芯原股份推出面向可穿戴设备的新一代GCNanoOptimaV 2.5D GPU IP,采用专用硬件加速引擎和优化内存架构,提升图形渲染性能与内存效率,已获多家领先客户采用。该IP集成硬件描边与椭圆渲染引擎,解决矢量图形渲染瓶颈;网格渲染架构降低片上SRAM需求;搭载DECNano 3.0压缩引擎,在2:1压缩比下提升图像质量;兼容VGLite图形API,支持LVGL等主流框架及SVG、PNG等格式。
HyperAI本次更新聚焦GPU排行榜与论文板块。GPU排行榜新增RTX 5090和RTX PRO 6000 Blackwell的模型适配查询,支持按显卡型号和卡数筛选可运行模型,并提供Qwen3.8-27B已验证部署入口,可创建兼容OpenAI的API服务。论文板块每日更新LLM、具身智能、世界模型等前沿研究,新增顶会获奖论文整合及任务、方法、机构等多维标签筛选,并关联代码、数据集与复现资源。
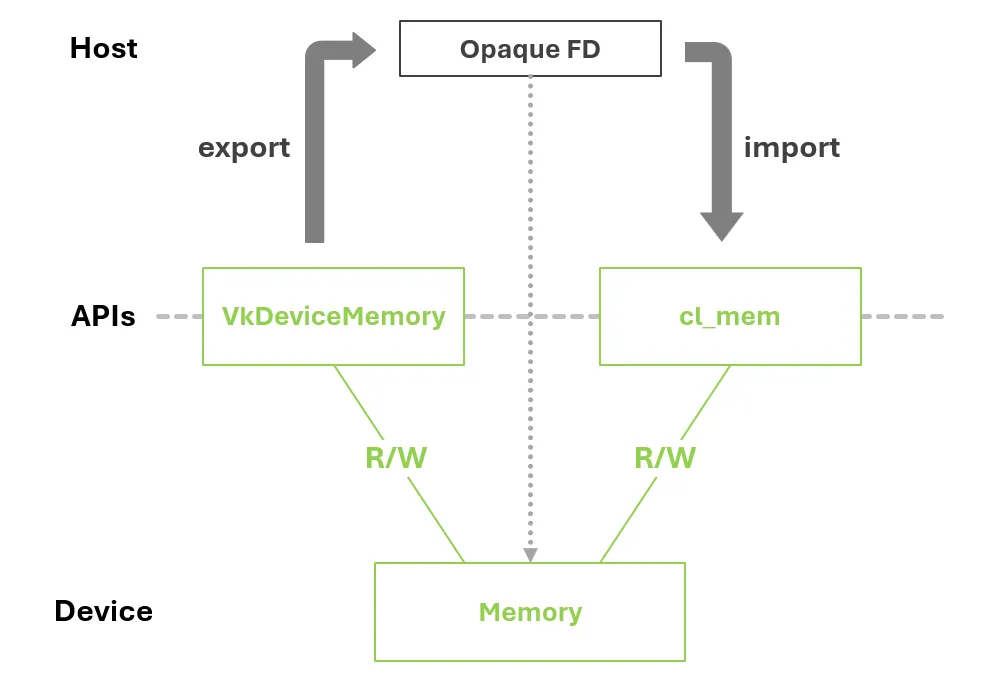
本文介绍在Android Adreno GPU上实现Vulkan与OpenCL直接共享GPU内存的完整流程:通过opaque fd导出/导入内存,缓冲区和线性平铺图像使用通用句柄,最优平铺图像需高通Vulkan opaque fd扩展;同步使用一次性sync fd信号量,每个跨API同步点都需重新导出导入;还需用队列族所有权屏障和OpenCL获取/释放命令转移访问权,并匹配设备与驱动UUID。
GPU算力租赁选型的关键在于区分“租卡”与“租平台”。个人和实验型任务应关注包含带宽、存储等隐性成本的实际单价及断点恢复能力;高校科研重视镜像保存与环境预装;企业需按总拥有成本计算,月调用量低于5亿token时托管平台更优,超过10亿token则自托管更划算。选型应综合单价、利用率和迁移成本,避免只看低价。
Together AI is putting AI coding agents to work on the GPU code that runs its inference infrastructure, automating performance The post Together AI let coding agents rewrite its GPU code. Then it...
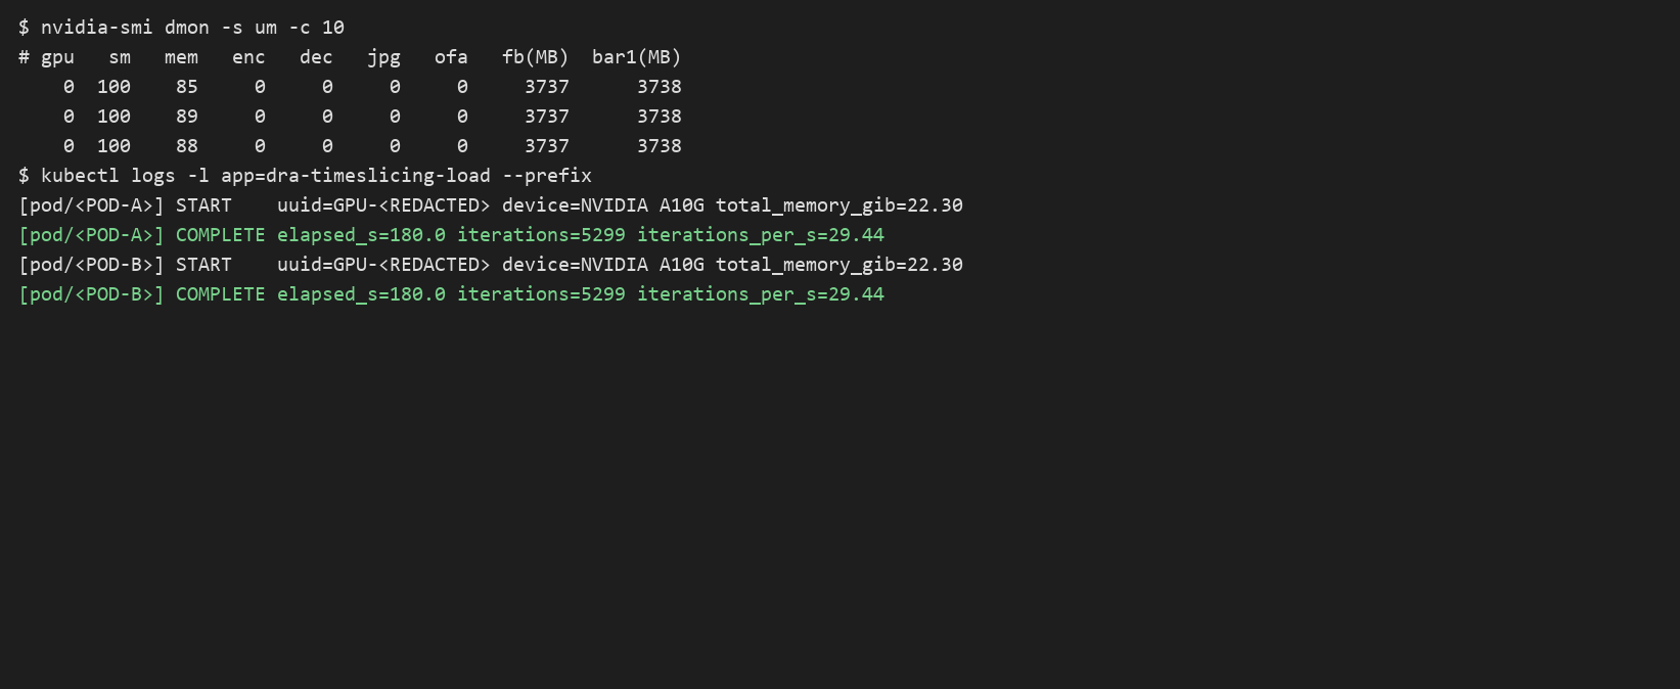
本文在 Amazon EKS 与 A10G 上实测三种 GPU 共享方案。Device Plugin Time-Slicing 部署简单,但无显存与算力隔离,双活跃时单服务吞吐约减半,显存超配会导致后启动服务失败。NVIDIA DRA 支持结构化设备发现与 Claim 生命周期管理,分时功能仍为 alpha 且无运行时隔离。HAMi 提供用户态显存配额与计算节流,可限制显存并触发 OOM,但属软件隔离,非 MIG 硬件隔离。建议可信、错峰负载用 Time-Slicing,需软件配额选 HAMi,关键业务独占 GPU。
文章讨论AI推理服务在Kubernetes上的可观测性与运维:需测量首token时间、每token时间、可靠性、成本与答案质量,并在上线前用代表性负载建立基线;GPU利用率高不代表服务健康,应关联模型、Kubernetes、网络、存储等各层指标排查瓶颈;自动扩缩需合适指标与GPU容量;提示词和响应属敏感数据,须规范采集与访问;上线决策应由平台、数据科学、安全与业务方共同基于证据做出。
Netflix has detailed how it is building a reliability platform for large-scale GPU training and inference, using layered health checks, automated remediation, and fault-tolerant training to keep...
文章以新加坡雾霾打破“花园城市”印象为引,隐喻云原生技术当前处境:理想化的完美形象出现裂痕,现实并不总如预期般整洁高效。
天数智芯发布天垓300通用GPU与彤央TY1200端侧芯片,现场随机出题与英伟达H200、Jetson Thor T5000实测对比:天垓300在文生图、长上下文推理和训练吞吐上部分领先H200,并支持异构混训;TY1200在端侧大模型和世界模型任务中跑赢Thor。同期发布天数智算软件栈,用Agentic AI简化部署、调优和算子开发,形成云、软件、端协同的算力闭环。
芯原推出面向可穿戴设备的GLTiny 3D GPU编程模型,提供精简API和超轻量驱动,可发挥其Nano OpenGL ES GPU IP的3D图形能力。该模型支持glTF模型原生渲染、光照、骨骼蒙皮、变形目标及完整动画,并支持高斯模糊、水波纹等特效,还可与VGLite结合实现2.5D矢量与3D模型同帧协同渲染。
无问芯穹在NVIDIA Research的SOL-ExecBench GPU算子评测中,先后登顶L1基础算子、L2融合算子、Quant量化与FlashInfer-Bench推理四大赛道,在235道题中拿下88项单题第一。其算子优化Agent采用容器隔离、Skills与共享Memory、分层优化策略,形成生成—验证—分析—调优闭环,探索以Agent自主优化底层算子、将Token投入转化为实际生产力的路径。
本文介绍Triton张量描述符,用于描述张量内存布局、简化GEMM核实现,并在SM90+ GPU上支持TMA操作。描述符分为设备端和主机端两类,包含基地址、形状、步长和块大小等元数据。作者分别用原始指针、设备描述符和主机描述符三种方式实现GEMM并测试,结果均正确。在RTX 5080上,大尺寸矩阵中描述符版本略快于原始指针,8192³时主机描述符约快7%。
AI实验室Neolab融资后常签长期算力租约,但多数未推出商业产品。因GPU现货租金大涨,部分实验室转售算力套利,方式包括转租长约、按天出售闲置GPU、套壳开源模型做API。29家典型Neolab共融资230亿美元,商业化不足35%。马斯克认为缺的是电而非卡,并预言算力云行业将整合倒闭。
开源项目GPU Unlock通过Linux内核模块,在英伟达驱动接管前调整硬件速度选择器,使安培架构显卡特定FP16/BF16运算指令发射速率翻倍。RTX 3090 Ti测试中,BF16矩阵乘法性能提升80%,TF32提升94%,FP16提升35%;ComfyUI图像生成BF16吞吐提升约56%-58%,但INT8及显存带宽受限场景提升有限。项目支持RTX 3090及部分3080/3070/3060,不修改驱动或VBIOS。
文章指出,GPU池满载和队列增长并不必然意味着需要扩容,应先区分GPU处于“已分配”“忙碌”还是“产生有价值结果”的状态。团队需明确各工作负载的截止时间、运行时长、资源需求和可中断性,并定义有价值输出的标准。通过错峰调度可降低峰值需求,无需扩容即可按时完成任务。高GPU活动率并不代表有额外吞吐量,应通过代表性负载测试测量可持续容量。结合OpenCost等工作负载成本数据与服务遥测、结果记录,可计算“每个合格结果的成本”,在质量、延迟和成本之间权衡,选择延迟任务、优化批处理、调整部署、更换模型或扩容。最终目标是以可辩护的成本交付所需结果,并保留足够余量。
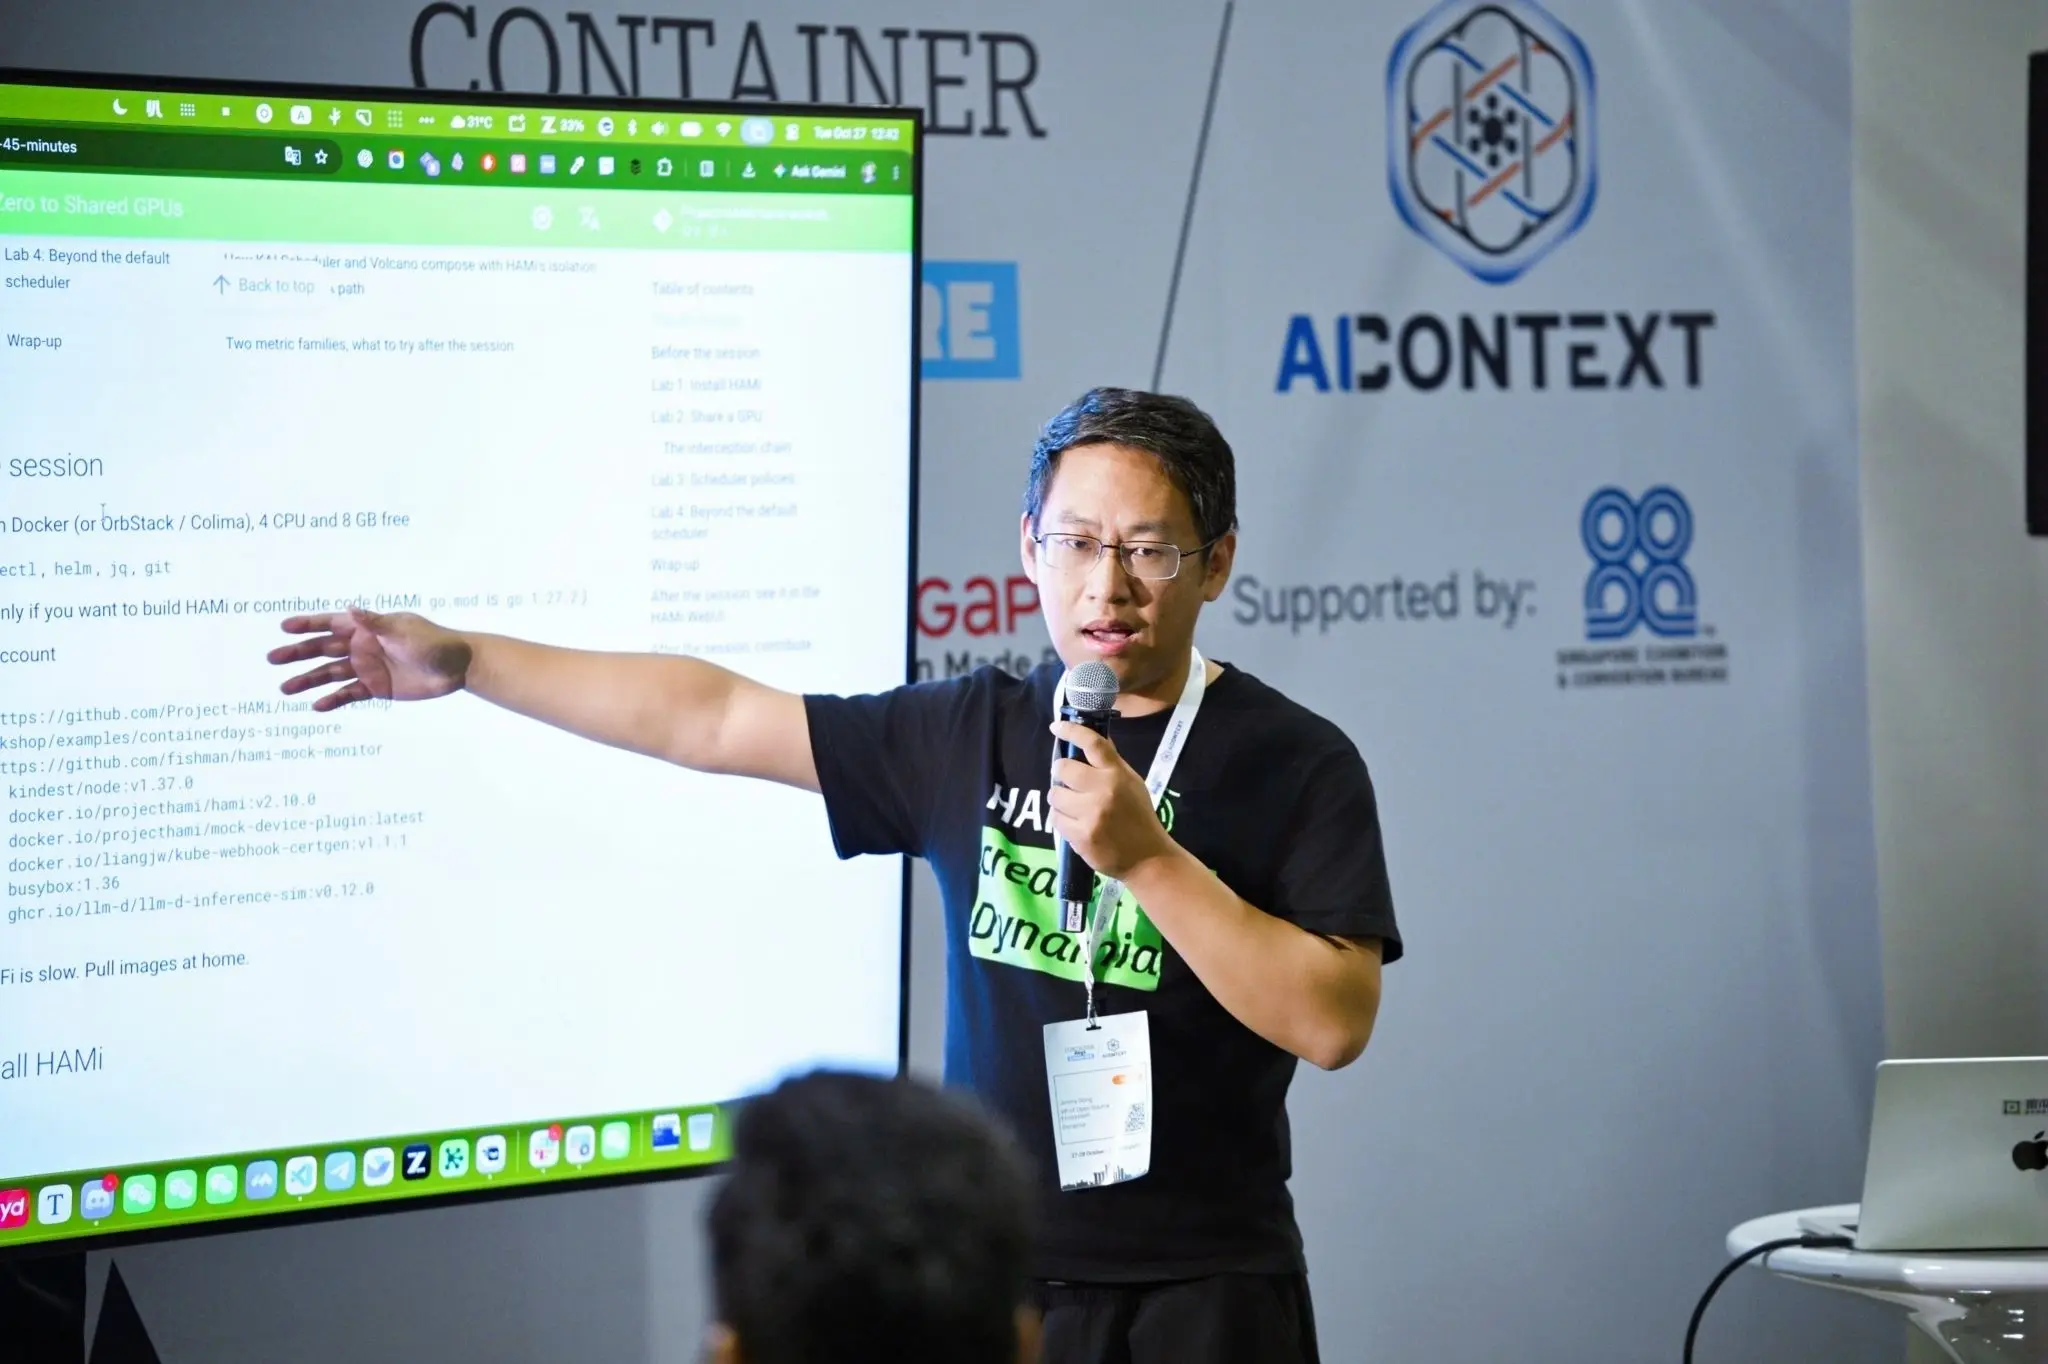
该工作坊在 ContainerDays 2026 新加坡站介绍 CNCF 孵化项目 HAMi 的 GPU 共享方案:借助 kind 集群与模拟设备插件伪造两块 A100-40GB 显卡,无需真实 GPU 即可观察调度过程。内容涵盖 GPU 共享动机(避免大卡被小任务独占)、HAMi 架构(webhook、调度器扩展、设备插件等)以及按显存和算力申请切片;四个实验分别覆盖安装、GPU 共享与拦截链、binpack 与 spread 调度策略、KAI Scheduler 与 Volcano vGPU 等扩展路径,最后介绍指标与 WebUI。
本文是KubeCon前瞻专栏,聚焦Kubernetes应对AI代理负载的挑战:HPE推出Pod重启自动诊断工具;AWS指出调度器与自动扩缩器需协同以避免GPU闲置;llm-d发布v1.0降低推理成本;CNCF称AI代理流量已超人类;研究显示为编码代理提供上下文可更快诊断集群故障;Valkey指出指标缺失并非时序状态;Splunk调查显示多数企业难以监控AI质量与成本。
本文介绍如何用Kamaji与HAMi在单机无GPU环境下搭建多租户GPU共享平台。Kamaji将各租户的Kubernetes控制面以Pod形式运行在同一管理集群中,实现租户隔离;HAMi支持Pod按显存和算力比例申请GPU切片,使多个Pod共享一张显卡。作者通过模拟设备插件伪造A100和L4显卡,完成两个租户集群的部署,八项测试全部通过,验证了调度、超额申请拒绝和租户隔离。主要问题是模拟插件不释放节点锁,需手动添加注解解决。该实验仅验证调度链路,未测试真实GPU隔离与性能。
英伟达发布621.01版驱动,支持微软“高级着色器交付”技术,通过云端为不同硬件预编译着色器,消除游戏启动时的编译等待及游戏中的卡顿与CPU峰值。《战争机器:E-Day》和《使命召唤:现代战争4》已支持该技术,需安装Xbox PC应用,Steam购买的游戏同样受益。AMD和骁龙X2设备也有相应驱动支持。
完成下面两步后,将自动完成登录并继续当前操作。