

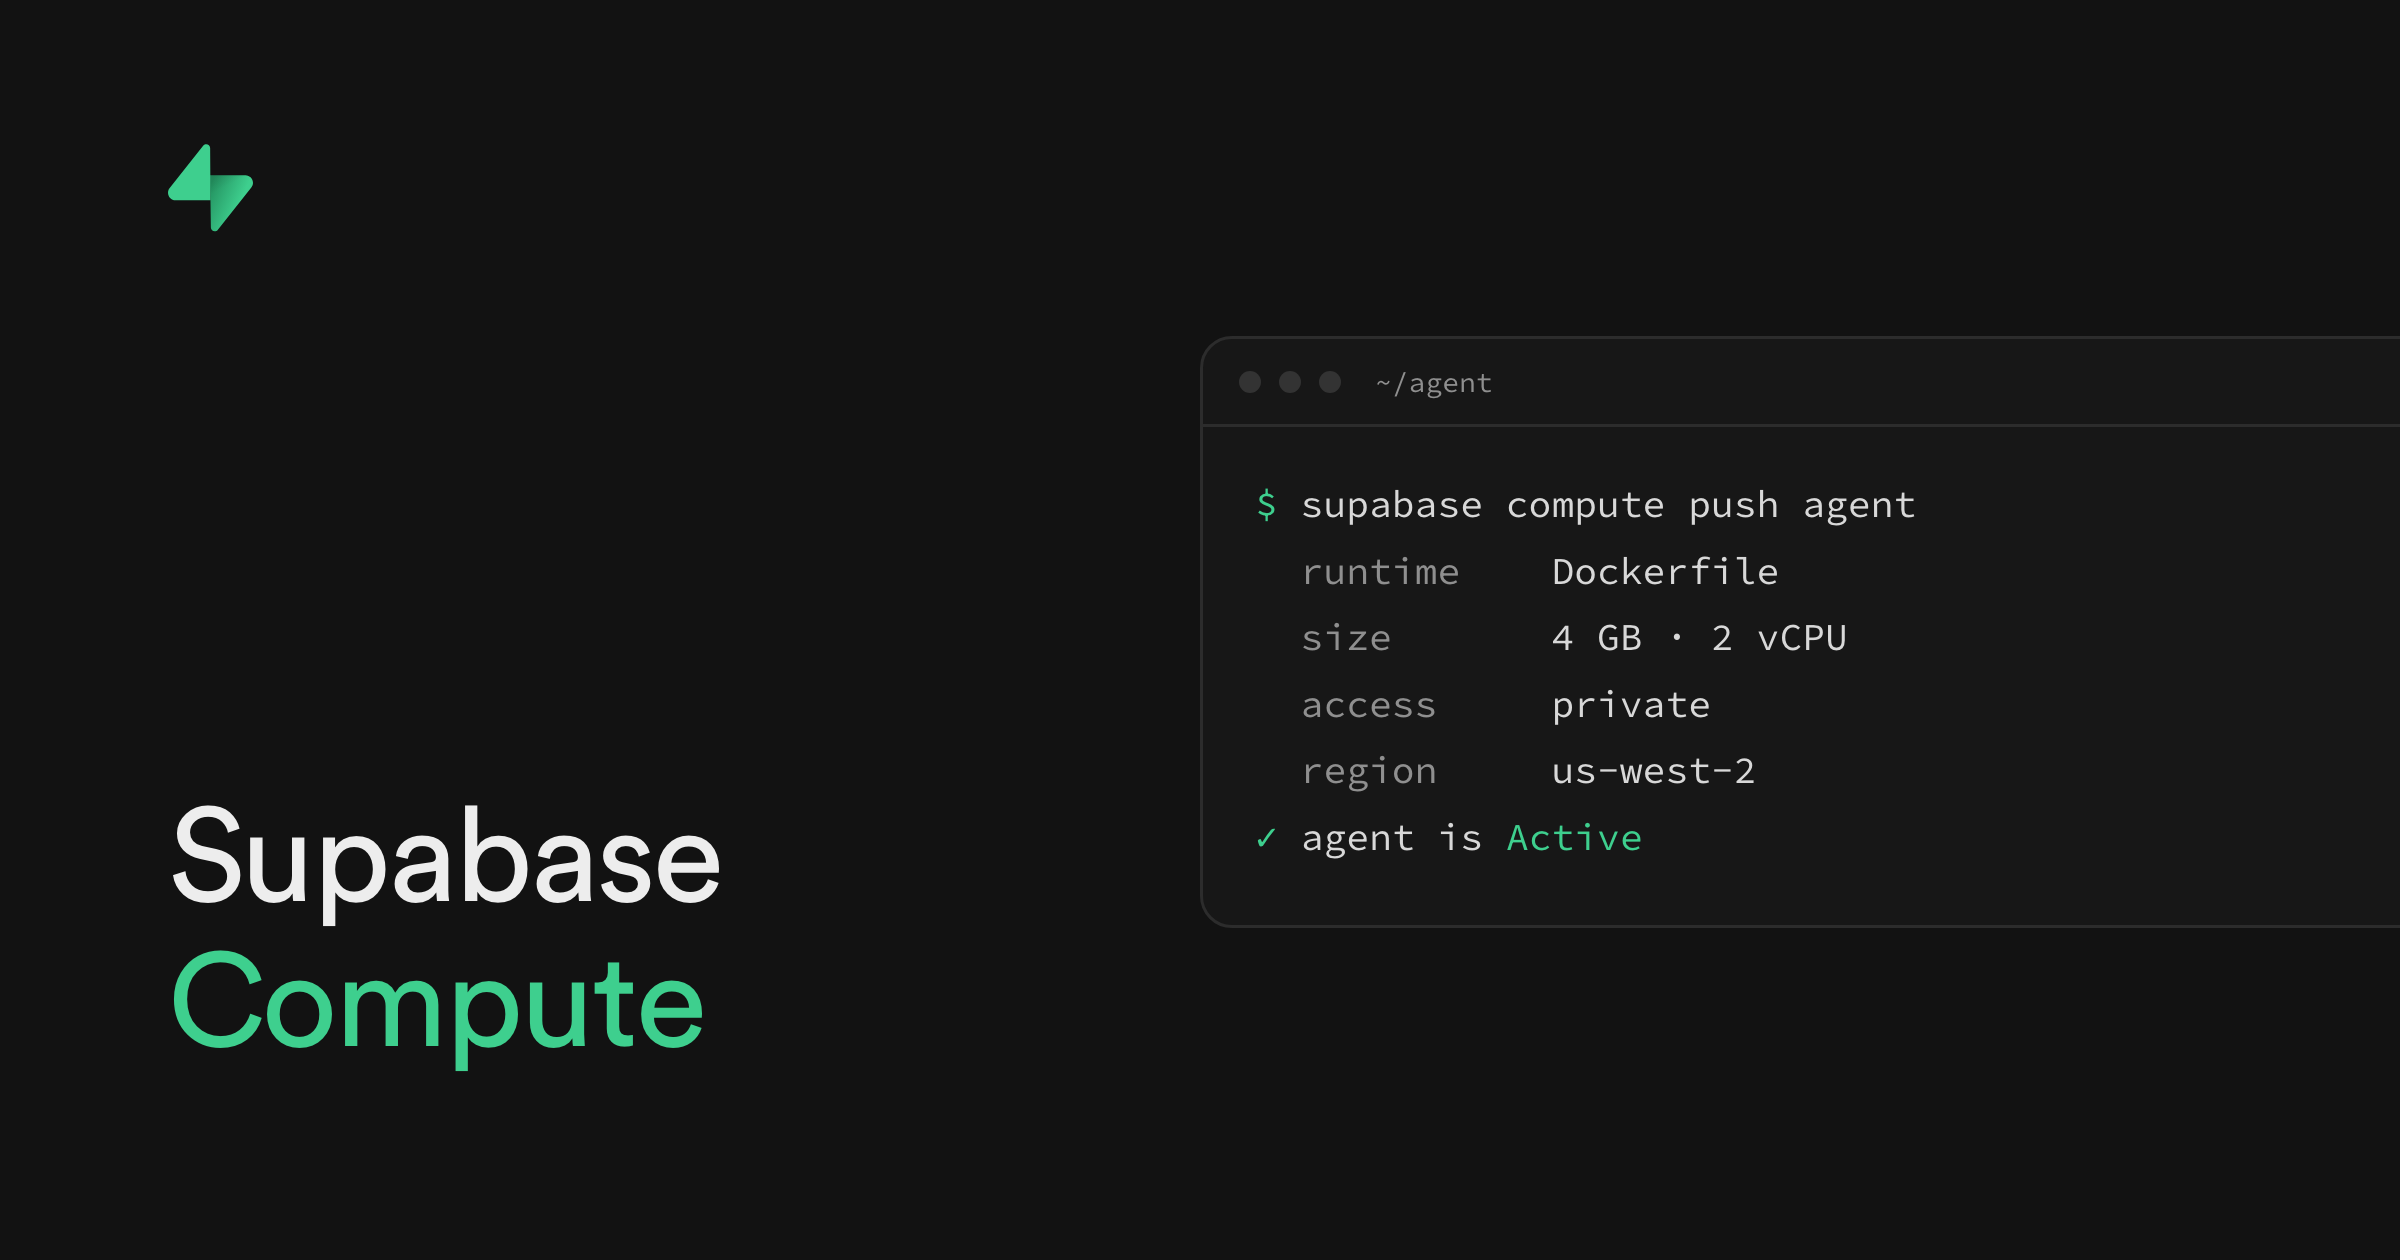

Supabase Compute:在你的项目内运行你的智能体
内容提要
Supabase推出Compute私有Alpha版,支持在同一项目内运行AI代理、后台任务和API,可使用Node、Deno或Dockerfile,运行时长从数分钟到数小时,目前仅限us-west-2区域。服务可获取项目密钥,日志可在仪表板查看。暂不支持自动扩缩容、GPU和持久磁盘,公共服务空闲时会暂停。
延伸解读
与数据同区域运行带来的延迟优势
文章提到,Dreambase 将数据代理迁移到 Compute 后,查询 Postgres 的中位延迟从跨区域的 65 毫秒降至 2.9 毫秒。这说明将计算任务放在项目同一区域,能显著减少网络往返,对需要频繁访问数据库的 AI 代理、实时 API 或 WebSocket 服务尤其有利。不过,目前仅限 us-west-2 区域,其他区域的项目暂时无法获得这一优势。
私有 Alpha 的定位与限制
Supabase 明确说明 Compute 私有 Alpha 用于评估而非生产,服务可能随时变更或终止。它不支持自动扩缩容、GPU 和持久磁盘,公共服务空闲时会暂停,且每个服务都能获取项目的全部密钥。因此,适合用来验证长时任务、多语言 API 或数据同步等场景,但不应承载关键业务。长时运行的工作需自行保存到 Postgres,以防服务重启丢失状态。
部署方式与现有工具链的衔接
Compute 复用 Supabase CLI(v2.120.0 及以上),通过 config.toml 中的几行配置即可定义服务,并支持 Node、Deno 或任意 Dockerfile。服务设置可写成配置,便于编码代理自动编写和部署。管理 API 也提供 alpha 端点用于部署、列出和删除服务。这意味着团队无需引入第二套部署平台,日志也统一显示在仪表板的 Compute 页面,减少了跨平台调试的负担。
Q&A
Supabase Compute 是什么?它主要用来做什么?
Supabase Compute 是 Supabase 推出的私有 Alpha 版服务,允许你在同一个 Supabase 项目内运行 AI 代理、后台任务和 API,与数据紧密相邻。它支持 Node、Deno 或任意 Dockerfile,运行时长可从几分钟到几小时。
Supabase Compute 目前有哪些限制?
目前仅限 us-west-2 区域,不支持自动扩缩容、GPU 和持久磁盘;公共服务空闲时会暂停,私有服务则持续运行;服务可能随时重启,因此长时间运行的工作需保存到 Postgres;每个服务会获取项目的所有密钥;仅用于评估,不适用于生产环境。
如何使用 Supabase CLI 部署一个 Compute 服务?
首先确保 Supabase CLI 版本为 v2.120.0 或更高,然后在 supabase/config.toml 的 [experimental] 下添加 compute = true。接着用 supabase compute new 创建服务,选择运行时(Node、Deno 或 Dockerfile)、规格(2GB 内存+1vCPU 或 4GB 内存+2vCPU)以及是否公开。将 supabase/compute/ 下服务文件夹中的起始代码替换为你自己的代码,最后用 supabase compute push 部署。
Supabase Compute 适合运行哪些类型的工作负载?
适合运行需要更多内存或 CPU、运行时间超过 400 秒(如 AI 代理)、使用其他语言编写的工作负载。具体包括:可协调多个任务的 AI 代理、用任意语言编写的 API 或 Web 服务、从 Postgres 拉取任务的持久作业处理器(如 OpenWorkflow)、运行数小时的数据同步或嵌入回填,以及用于语音代理等低延迟实时应用的 WebSocket 服务。
Supabase Compute 相比其他平台有什么性能优势?
由于 Compute 服务与数据在同一项目内运行,访问 Postgres 的延迟显著降低。例如,Dreambase 将其数据代理迁移到 Compute 后,查询 Postgres 的中位延迟为 2.9 毫秒,而从其他区域访问则为 65 毫秒。
Supabase Compute 服务如何获取项目密钥?日志在哪里查看?
每个 Compute 服务会自动获取所在项目的所有密钥。服务的日志可以在 Supabase 仪表板的 Compute 页面中查看。
