


玩转 stream API
内容提要
本文介绍了流式API的基本概念及其在前端开发中的应用,强调流式处理在提高用户体验和避免内存溢出方面的优势。详细讲解了可读流、可写流和转换流的构造与使用方法,并指出队列策略在流数据处理中的重要性。通过实例展示流式处理与传统方法在处理大文件和日志输出时的效率差异。
延伸解读
流式处理的核心优势
文章指出流式API能防止内存溢出并允许快速响应。通过连续数据传输,前端可以在数据到达时立即处理,而不必等待全部数据返回。例如,GPT的流式返回让用户更快看到结果。传统Ajax请求需等待所有数据,降低了用户体验。流式处理特别适合大文件或实时日志,能显著提升响应速度。
队列策略与背压机制
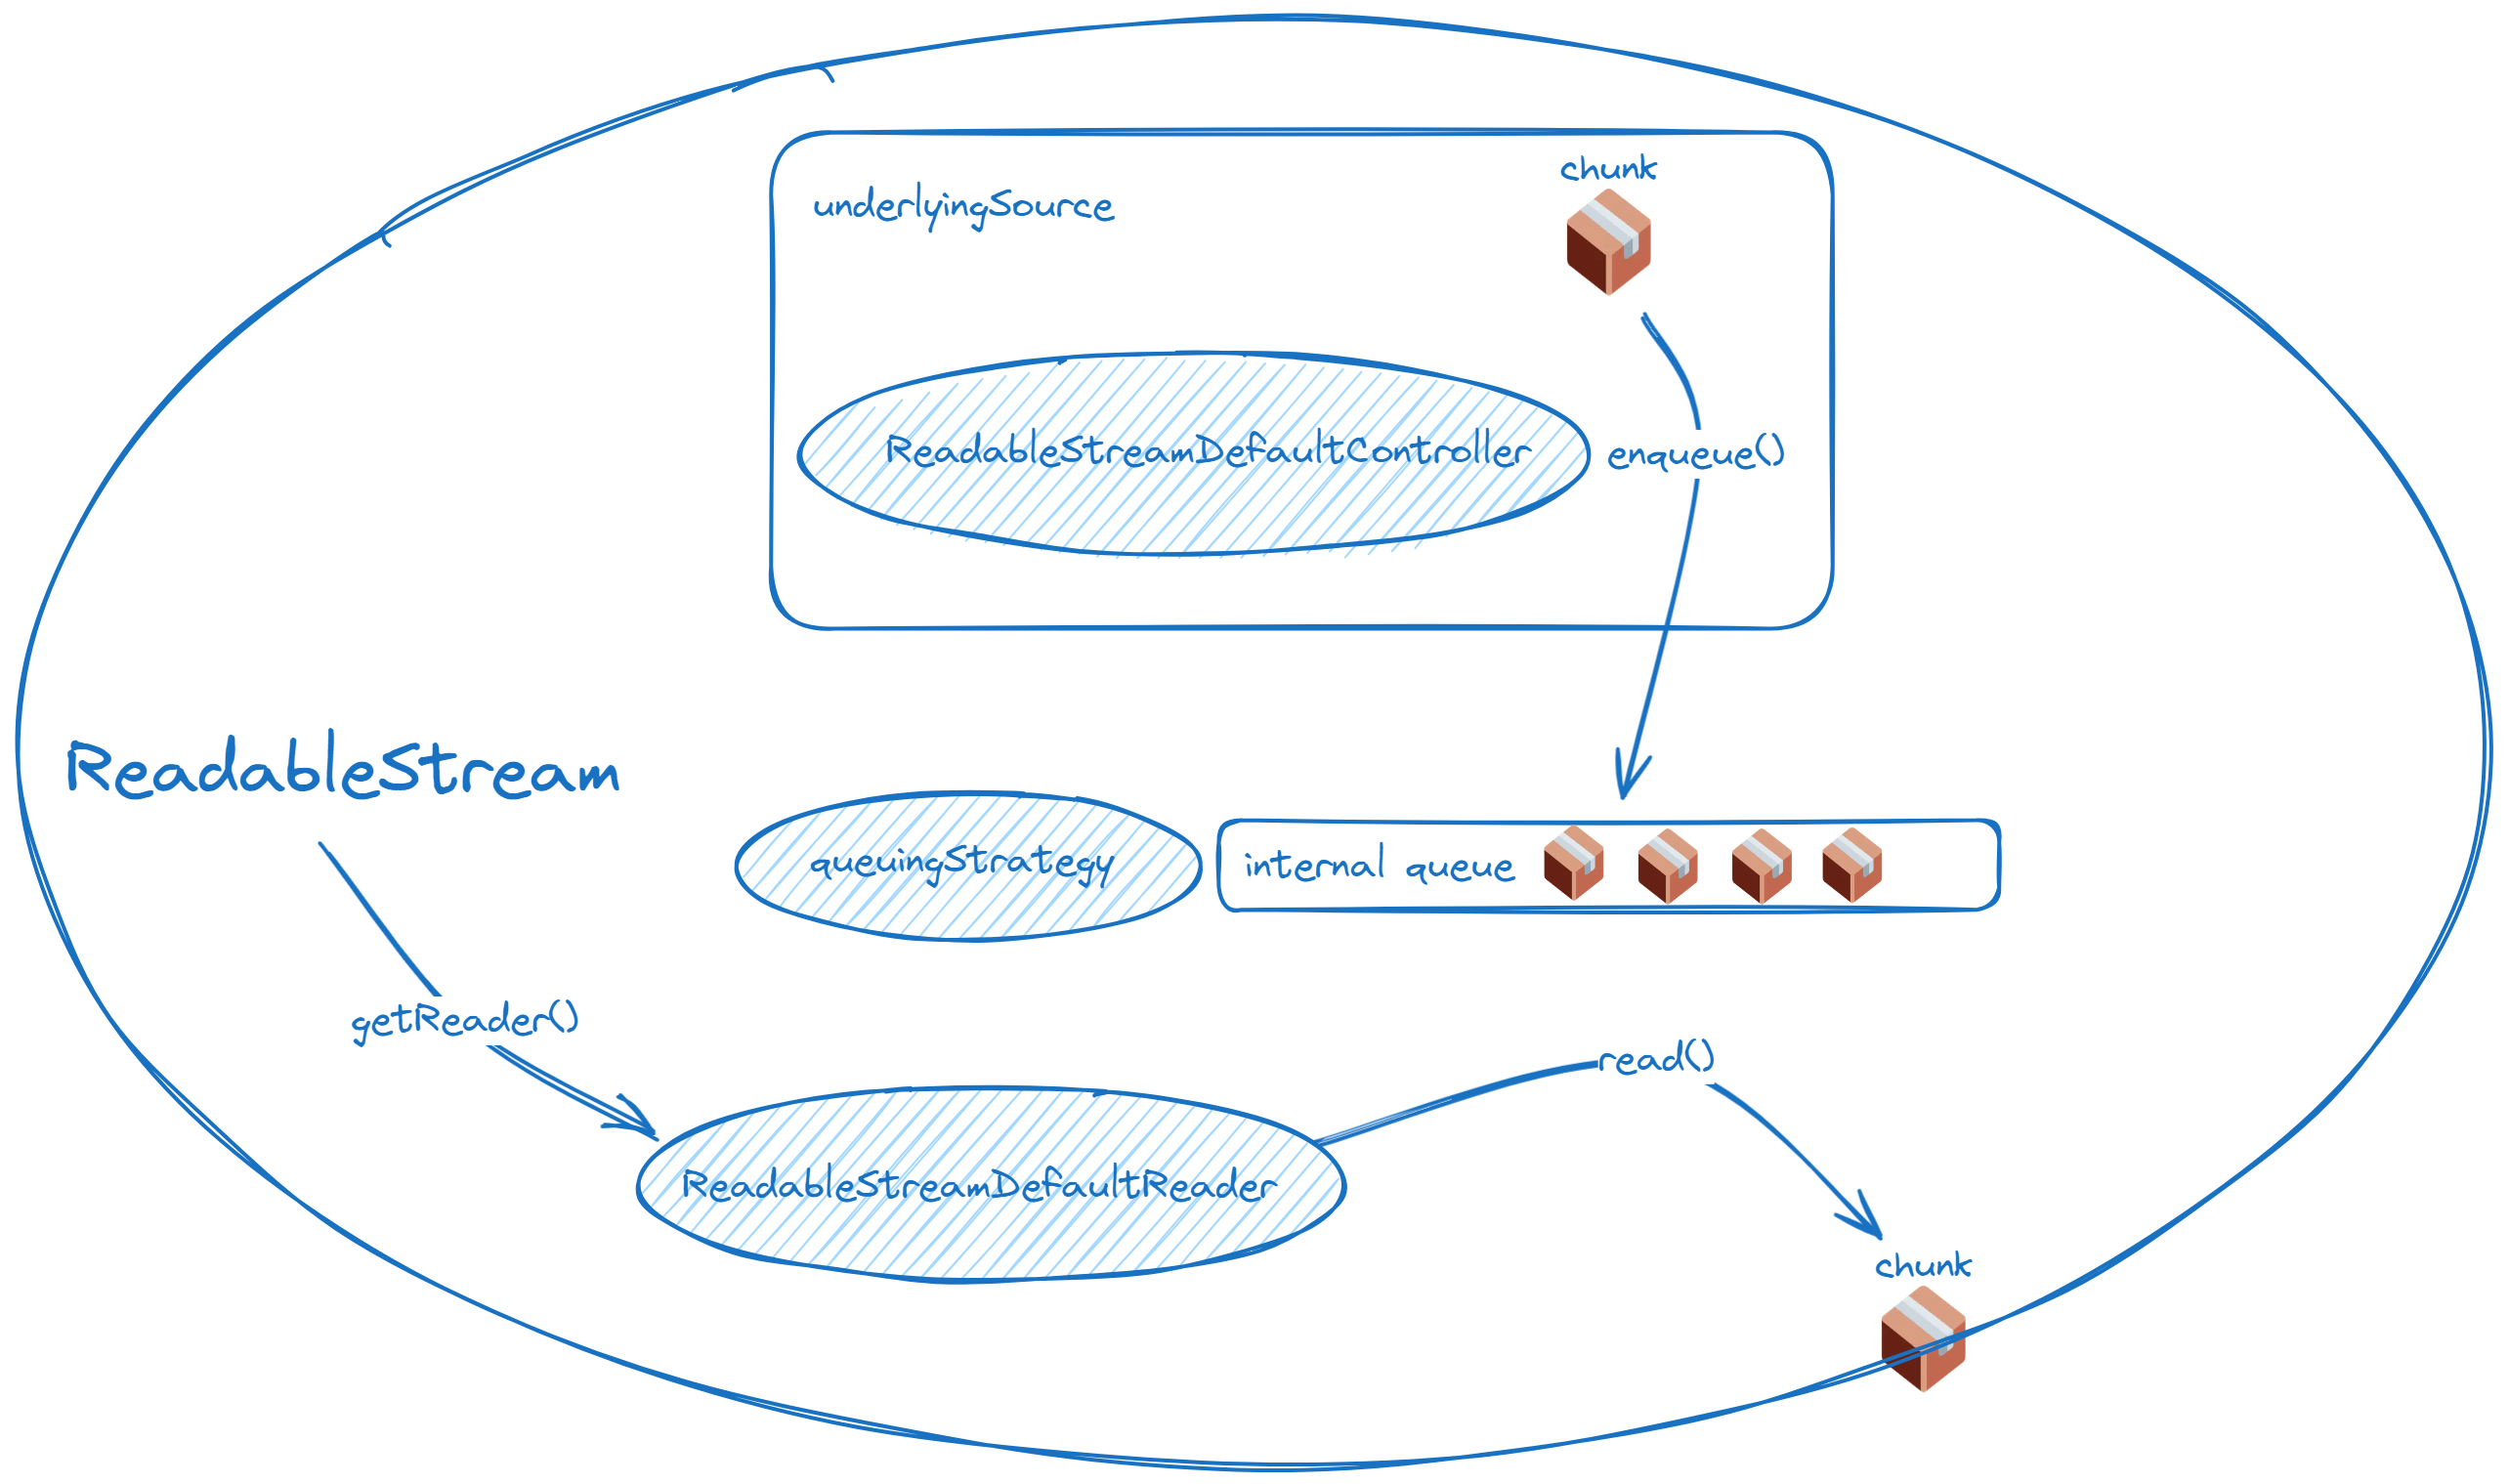
队列策略通过highWaterMark控制流的缓冲大小,但并非严格限制。当队列满时,desiredSize会提示生产端减速,避免内存膨胀。可读流的pull在队列有空余时自动调用,可写流则通过writer.ready来协调。文章强调,即使队列超过highWaterMark,仍可继续操作,但需注意内存消耗,设计时应遵循背压信号。
转换流与管道操作
转换流用于数据处理,可通过pipeThrough连接多个转换流,最后pipeTo到可写流。文章示例中,加密大文件传输使用TransformStream进行解密和文本解码,再写入DOM。管道操作能灵活组合流,实现复杂的数据处理链。这种模式适合需要多步处理的场景,如日志分割或协议解析。
实践中的性能对比
文章通过加密大文件传输和日志输出两个实例,对比流式与传统方法的效率。流式处理能立即展现内容,而传统方式需等待全部数据到达,延迟明显。在日志输出中,流式处理避免了一次性渲染的性能问题,并通过自定义转换流处理数据分块。这些案例说明流式API在处理大文件或实时数据时更具优势。
Q&A
流式API的主要优势是什么?
流式API可以防止内存溢出并提高用户响应速度。
可读流和可写流的主要功能是什么?
可读流用于读取数据,而可写流用于写入数据。
队列策略在流数据处理中的作用是什么?
队列策略通过控制流的队列大小,提高数据处理效率,防止内存溢出。
转换流的用途是什么?
转换流用于数据处理,可以连接可读流和可写流进行数据转换。
流式处理与传统方法在处理大文件时有什么区别?
流式处理可以即时展现内容,而传统方法需要等待所有数据返回后再处理,效率较低。
如何使用管道操作函数连接流?
可以使用pipeTo()将可读流连接到可写流,使用pipeThrough()将可读流连接到转换流。
