

用Python和Olostep在3分钟内抓取7000个网页
内容提要
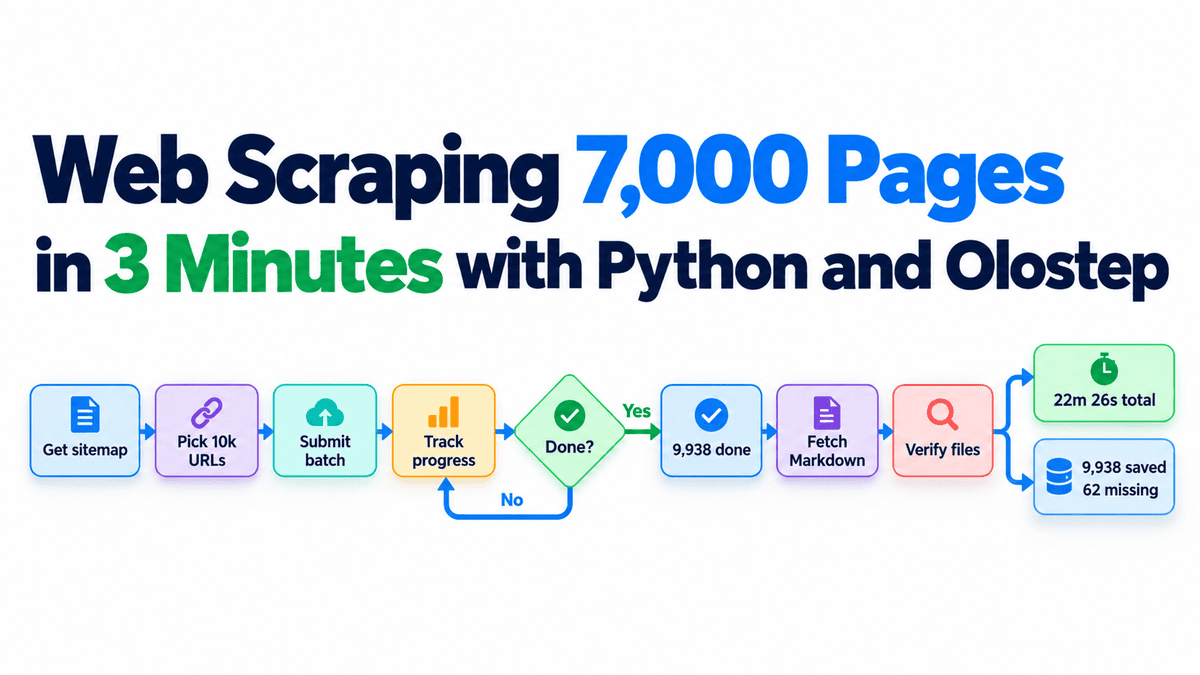
作者使用Python和Olostep批量API抓取1万个MDN页面并保存为Markdown。提交后约2分52秒完成7225页,全部抓取约18分30秒,下载约2分25秒,总耗时22分26秒。最终9938个文件成功,62个缺失,成功率99.38%。结论:批量抓取初期吞吐高,但应衡量完整流程并核验缺失结果。
延伸解读
批量抓取的真实耗时:别被初期速度迷惑
文章实测显示,Olostep 在不到3分钟内完成了7225页,但剩余页面处理明显变慢,全部抓取耗时约18分30秒,加上下载和验证,总流程达22分26秒。这说明批量抓取的初期吞吐量高,但整体完成时间可能远长于最初几分钟的表现。对于需要规划数据管道时间窗口的团队,应以端到端耗时为准,而非仅看峰值速度。
完成状态不等于全部成功:缺失结果需主动核验
尽管批次状态显示完成,最终仍有62个页面未生成有效Markdown文件,成功率99.38%。作者强调,必须通过检查文件是否存在且非空来核验结果,并生成缺失报告。这提醒我们,在构建可靠的数据管道时,不能仅依赖API的完成信号,而应加入结果验证环节,否则可能遗漏关键数据而不自知。
断点续跑与并发下载:提升工程鲁棒性的实用设计
代码中保存了批次ID和URL指纹,支持中断后恢复同一任务;下载阶段使用信号量控制最多96个并发请求,并跳过已保存文件。这些设计减少了重复工作和资源浪费,尤其适合长时间运行的大规模抓取。读者可借鉴这种检查点机制和并发控制策略,以应对网络波动或任务中断。
规模与耗时的非线性关系:小批量测试不足以推断大批量
作者对比了1000、5000和10000个URL的测试,发现5000页批次抓取约14分钟、总耗时16分钟,而10000页批次抓取约18分30秒、总耗时22分26秒。耗时并非随页面数线性增长,但大批量仍需要更长的尾部处理时间。因此,在规划企业级抓取任务时,应针对目标规模进行基准测试,而非简单按比例估算。
Q&A
用Python和Olostep批量抓取1万个网页,实际总耗时是多少?
完整流程(提交、抓取、下载、验证)总耗时22分26秒。其中抓取阶段约18分30秒,下载Markdown文件约2分25秒。
Olostep Batch API一次最多能提交多少个URL?
Olostep Batch API单次批量最多支持10,000个URL。
抓取1万个MDN页面,最终成功保存了多少个Markdown文件?
成功保存了9,938个Markdown文件,缺失62个,成功率99.38%。
为什么批量抓取完成后还需要验证结果?
因为批量任务显示“完成”并不代表每个页面都成功保存。测试中就有62个页面缺失,验证可以识别缺失文件并确保数据管道的可靠性。
使用Olostep Batch API抓取网页的基本流程是什么?
流程包括五步:准备URL列表、提交批量任务、跟踪进度、下载结果并保存为Markdown、验证文件并统计缺失。
Olostep在抓取初期速度很快,但整体耗时较长,可能的原因是什么?
作者猜测平台可能动态分配工作线程,初期吞吐高,但剩余页面处理较慢;也可能是慢页面、重试或其他处理延迟导致。
