


Liquid AI 发布 LiquidCodec:7400 万参数的流式音频编解码器
内容提要
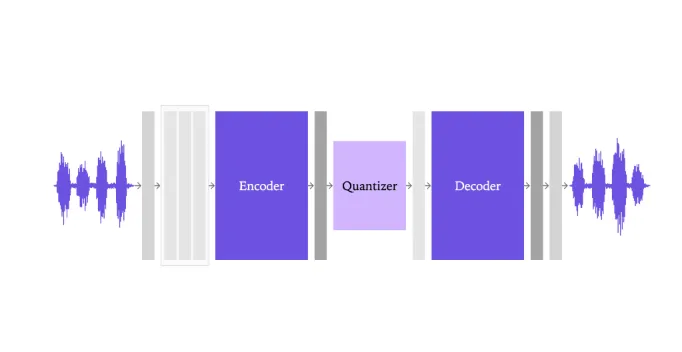
Liquid AI 发布约7400万参数的流式语音编解码器 LiquidCodec,用于 LFM3-Audio-2B 与 LFM3-Omni-2B。它将24kHz音频压缩为12路token流,采用分组有限标量量化,使12个码本可并行预测,解码器直接预测频谱系数。训练分两阶段,覆盖107种语言、26.4万小时语音,并采用量化感知训练。在8个测试集上重建质量优于 Mimi、NanoCodec 和 X-Codec 2,单CPU线程编码速度约为361倍实时。权重已在 Hugging Face 发布。
延伸解读
GFSQ 带来的并行预测优势
LiquidCodec 采用分组有限标量量化(GFSQ),而非 Mimi 等使用的残差向量量化(RVQ)。RVQ 中每个码本依赖前一个码本的残差,导致码本必须顺序预测;GFSQ 的各组相互独立,因此全部 12 个码本可由 MaskGIT 式 Transformer 并行预测。这一设计直接服务于 Liquid AI 的两个目标:让 token 更易被语言模型预测,并提升编解码速度。
速度优势明显,但需注意测试条件
在 Apple M4 Max 单 CPU 线程 FP32 下,LiquidCodec 编码 RTF 为 0.0028,约 361 倍实时,比 Mimi 低约 13 倍;解码 RTF 为 0.0115,低 2.9 倍。这些是 Liquid AI 自报数据,且测试平台为特定笔记本单线程,实际部署到其他 CPU 或边缘设备时速度可能不同。不过,单线程可运行本身对端侧流式场景有参考价值。
重建质量领先,但并非全面占优
在 8 个测试集上,LiquidCodec 的 ViSQOL 和梅尔距离均优于 Mimi、NanoCodec 和 X-Codec 2;固定 TTS 模型后,其 token 在全部测试集上取得最高 UTMOSv2。但 NanoCodec 在 8 个测试集中的 7 个上 PESQ(WB)更高,并在 LibriSpeech 说话人相似度上领先(SECS 0.836 对 0.785)。选型时应按任务侧重权衡,而非只看单一指标。
部署路径与量化选项
开发者可通过 Hugging Face Transformers 以 trust_remote_code=True 加载,调用 encode() 和 decode(),并利用 LiquidCodecStreamingCache 逐块解码。面向边缘场景,Liquid AI 提供了 llama.cpp 的 Q4_0、Q4_K_M 和 Q8_0 GGUF 版本;Q4_0 配合仅解码器 QAT 可将解码器体积缩小 3.5 倍,LibriSpeech ViSQOL 仅从 4.319 微降至 4.292。许可证为 HF 上的“
Q&A
LiquidCodec 是什么?它主要用在哪些模型里?
LiquidCodec 是 Liquid AI 发布的约 7400 万参数的流式语音编解码器(tokenizer),用于将语音转换为语言模型可预测的 token,再转回音频。它是 LFM3-Audio-2B 与 LFM3-Omni-2B 模型背后的音频编解码器,取代了之前使用的 Kyutai Mimi。
LiquidCodec 的量化方式与 Mimi 的 RVQ 有什么不同?
LiquidCodec 使用分组有限标量量化(GFSQ),各组相互独立,因此全部 12 个码本可以被 MaskGIT 式 Transformer 并行预测。而 Mimi 使用残差向量量化(RVQ),每个码本编码前一个码本遗漏的信息,无法并行预测。
LiquidCodec 的训练过程分为哪几个阶段?
训练分两个阶段:第 1 阶段使用 107 种语言、26.4 万小时语音,采用波形损失和频谱损失,未使用对抗损失;第 2 阶段在全频带语音(24 kHz 或更高)5.5 万小时上,配合对抗判别器进行微调,以消除金属感伪影。最后还有仅针对解码器的量化感知训练(QAT),面向边缘推理。
LiquidCodec 的编码和解码速度有多快?
在 Apple M4 Max 单条 CPU 线程上以 FP32 测试,LiquidCodec 编码约 361 倍实时(RTF 0.0028),解码约 87 倍实时(RTF 0.0115)。编码 RTF 比 Mimi 低约 13 倍,解码 RTF 低 2.9 倍。
LiquidCodec 在重建质量和 TTS 任务上表现如何?
在 8 个测试集上,LiquidCodec 均取得最佳 ViSQOL 和最低梅尔距离,例如 LibriSpeech 上 ViSQOL 为 4.319,优于 NanoCodec、X-Codec 2 和 Mimi。在 TTS 任务中,使用相同 TTS 模型训练,LiquidCodec 在全部 8 个测试集上取得最高 UTMOSv2,并在 4 个测试集上取得最佳 WER/CER,LibriSpeech WER 为 3.15%。但 NanoCodec 在 7 个测试集上 PESQ 更高,且在 LibriSpeech 说话人相似度上领先。
开发者如何部署和使用 LiquidCodec?
可通过 Hugging Face Transformers 以 trust_remote_code=True 加载,调用 encode() 获取音频编码,decode() 获取波形。原生 LiquidCodecStreamingCache 支持逐块解码。面向边缘场景,提供了用于 llama.cpp 的 Q4_0、Q4_K_M 和 Q8_0 GGUF 版本,Q4_0 配合仅解码器 QAT 可将解码器体积缩小 3.5 倍,LibriSpeech ViSQOL 仅从 4.319 微降至 4.292。
