Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
内容提要
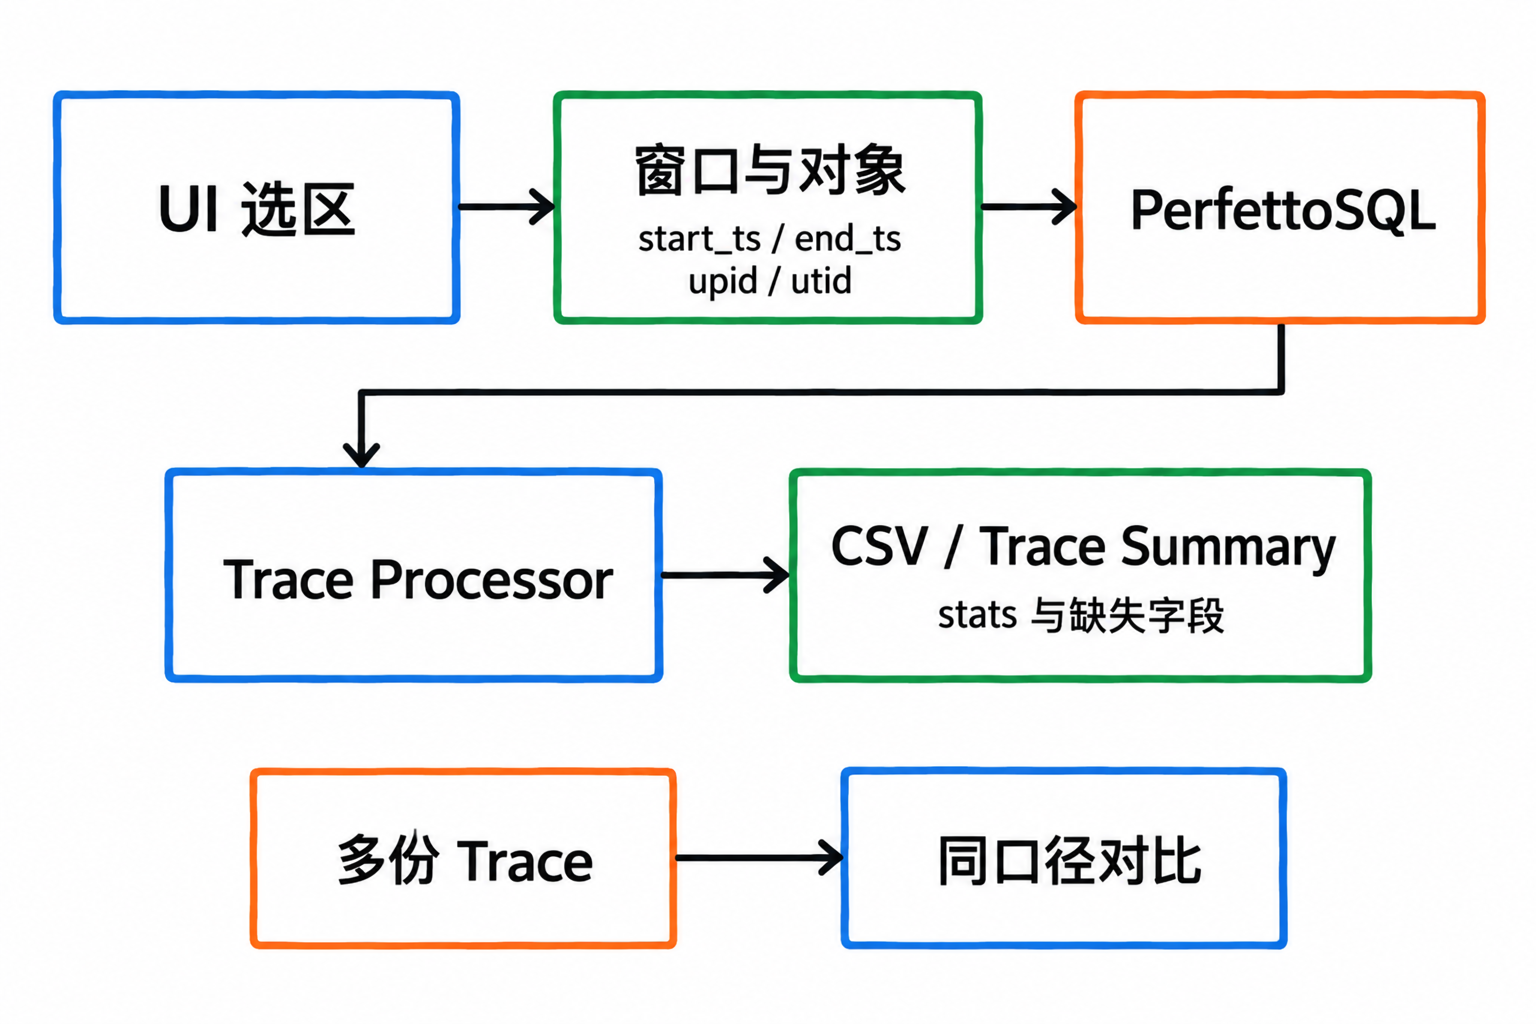
文章介绍用 PerfettoSQL 与 Trace Processor 将 Trace 分析从截图判断转为可复查查询:先查 stats 评估采集质量,再固定目标窗口与 upid/utid,用 SQL 查长切片、Running/Runnable 等证据,最后用 Python 批量跑多份 Trace,输出稳定 CSV 或 Trace Summary,支撑回归检测。
延伸解读
为什么要把截图结论改成 SQL 查询
文章指出,用 Perfetto UI 框选截图写结论只能解决眼前问题,无法回答换一份 Trace、换一台设备是否同样成立,也无法确认下个版本问题是否回归。把判断写成窗口化的 PerfettoSQL 查询后,分析结果变成可评审、可复用、可放进 CI 的文本文件,才能支撑批量对比和回归检测。UI 仍然有价值,SQL 的职责是把 UI 里的判断保存下来,方便复查和批量比较。
写查询前必须先确认采集质量
文章强调,下任何结论前先查 stats,看是否有 data_loss、parser error、buffer overrun、packet loss。ftrace loss 会直接影响 sched/thread_state/wakeup 判断,但不一定让 App Track Event 全部不可用;FrameTimeline 缺失会影响帧指标,但不一定影响 Binder 或内存查询。报告里要保留 stats 明细,再由每个指标决定复抓、剔除或降级,不能把所有非零项都当成整份 Trace fatal。
身份归属与时间单位是常见坑
文章提醒,tid/pid 会复用,同一份 Trace 里也可能出现多个同名线程,写脚本时应优先用 utid/upid 表示本次 Trace 内唯一的线程和进程实体。时间列 ts 和 dur 通常按纳秒理解,写阈值时用 time_from_ms() 更精确;time_to_ms() 是整数除法会截断亚毫秒,任何要写进报告、做 before/after 比较的耗时列都应写成 ROUND(dur / 1e6, 3),否则亚毫秒差异会在报告里直接消失。
从单份查询到回归检测的工程化路径
文章给出的路线是:先查 stats 体检,再固定目标窗口和 upid/utid,然后把长 slice、Running/Runnable、帧指标和降级原因写成 CSV 或 Trace Summary。多 Trace 分析要先固定输入契约,最小集合包括 trace_name、scenario、group、device、build、config_id,以及 trace_processor_version、sql_package_version 等排除环境漂移的字段。回归判定不要只比较平均值,建议同时保留中位数、p95、最
Q&A
PerfettoSQL 和 Trace Processor 是什么?它们和 Perfetto UI 是什么关系?
Trace Processor 是 Perfetto 的分析引擎,负责把 .perfetto-trace、Chrome trace、simpleperf protobuf 等文件解析成统一的 SQL 表;PerfettoSQL 是它提供的 SQL 方言。Perfetto UI 里的很多轨道也是基于这些表和视图查询出来的。SQL 的职责是把 UI 里的判断保存下来,方便复查和批量比较,UI 依然很有价值。
怎么用命令行执行 PerfettoSQL 查询?
先下载 trace_processor 并赋予执行权限,然后使用 query 子命令加载 Trace、执行 SQL 并打印结果,例如:./trace_processor query trace.perfetto-trace "SELECT ts, dur, name FROM slice LIMIT 5;"。也可以把 SQL 放进文件,用 -f 参数执行:./trace_processor query -f queries/slow_slices.sql trace.perfetto-trace。大 Trace 仍可用 server http 子命令让 UI 连接本地 Trace Processor。
PerfettoSQL 里 tid/pid 和 utid/upid 有什么区别?写脚本时该用哪个?
系统里的 tid/pid 会复用,同一份 Trace 里也可能出现多个同名线程。Trace Processor 用 utid/upid 表示本次 Trace 内唯一的线程和进程实体。写脚本时优先用 utid/upid,不要只靠线程名,因为 main、RenderThread、Binder:* 等线程名都可能重复。
怎么用 Python 批量分析多份 Trace 并输出回归检测报告?
安装 perfetto 包后,用 TraceProcessor(trace=...) 加载每份 Trace,用 tp.query(...) 执行同一组窗口化 SQL,读取同名 .json 元数据文件获取目标窗口,跑质量门禁,最后输出稳定字段的 CSV。脚本要固定输入契约(trace_name/scenario/group/device/build/config_id 等),并保留 stats 明细和降级原因。Trace 数量大时可换成官方 BatchTraceProcessor,用 query_and_flatten() 合成带来源信息的表。
分析 Trace 时为什么要先查 stats?数据丢失会怎样影响结论?
stats 里既有普通计数,也有错误和数据丢失,先查采集质量才能决定结论语气。如果出现 data_loss、parser error、buffer overrun、packet loss,后面的判断都要降低语气。ftrace loss 会直接影响 sched/thread_state/wakeup 判断,但不一定让 App Track Event 全部不可用;FrameTimeline 缺失会影响帧指标,但不一定影响 Binder 或内存查询。报告里要保留 stats 明细,再由每个指标决定复抓、剔除或降级。
怎么把 UI 里的判断写成可复查的窗口化 SQL 查询?
先把目标窗口固定成明确的 start_ts/end_ts,来源可以是 App 的 Trace.beginSection()、Track Event 标记、输入事件或 FrameTimeline 帧。然后引入 slices.with_context 和 time.conversion 模块,用 thread_slice 查询目标窗口内超过 5ms 的线程切片,输出线程、切片名、窗口内重叠时长和原始时长。查询结果只是列出可疑点,不能直接给根因或替代慢帧指标。
Runnable 和 Running 有什么区别?分析调度状态时要注意什么?
thread_state.state = 'Running' 对应实际占用 CPU 的区间;R、R+ 这类状态表示线程可运行但没有在 CPU 上跑,其中 R+ 通常代表被抢占后仍处于 runnable。做调度分析前先检查同一窗口内有没有 thread_state/sched 数据,目标线程匹配不到或 stats 里有 ftrace loss/drop/error 时,报告要输出 insufficient_sched_evidence 或 sched_evidence_grade=weak。出现长 Runnable 说明 CPU 竞争或调度延迟也要一起查,但不能单独定责。
从临时查询到稳定指标需要补齐哪些约束?
至少补齐四组约束:输出契约(列名、单位、排序规则固定,如 dur > time_from_ms(5)、列名 overlap_total_ms);身份归属(多进程场景用 utid/upid,线程名只适合读);目标窗口(报告带 window_source/window_name/window_start_ms/window_dur_ms);数据质量(每份 Trace 带 stats 明细和降级字段 quality_grade/degrade_reason/missing_sources/fallback_used)。复杂 JOIN 优先找标准库视图,长期项目优先考虑 Trace Summary。
Trace Summary 是什么?适合用在什么场景?
Trace Summary 的设计目标是把指标写进统一的 TraceSummary protobuf,适合接平台、看板、CI 时提供稳定结构。当前命令行入口是 summarize 子命令,通过 spec.textproto 定义 metric_spec,说明 metric id、维度和值,可声明 unit 和 polarity。适合内存、启动、帧、Binder、CPU、功耗这类需要跨版本长期跟踪的数据;临时排障仍然可以直接写 SQL。
做回归检测时,多份 Trace 需要带哪些元数据字段?
最小集合是 trace_name/scenario/group/device/build/config_id;duration_ms/thermal_state/trace_processor_version/sql_package_version 用来排除环境和工具漂移。这些字段可以来自文件名、metadata、测试平台或 case 包里的 metadata.json。缺少这些字段时,数字很难解释。before 和 after 的 TraceConfig 不一致时,不要比较指标。
