


帝国理工探索音频采集新方法,将大信号折回量程再还原
内容提要
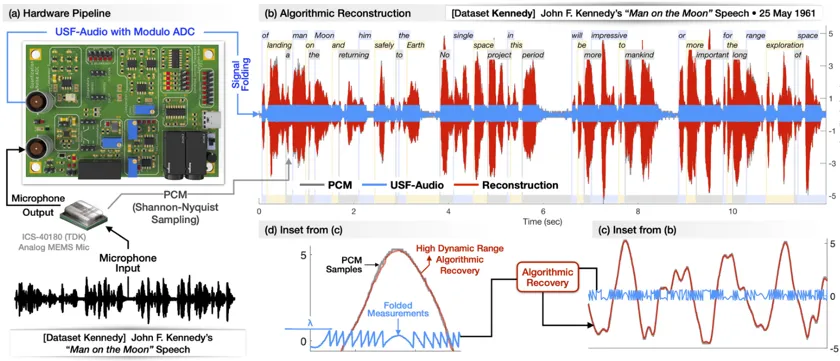
帝国理工学院团队提出USF-Audio音频采集方案:在模数转换前用模拟电路将超量程信号按固定幅度折叠回有限范围,再由算法重建原波形,从而兼顾强弱信号。6位硬件实验中噪声底平均改善约18 dB,52人听音评分由3.22升至3.81。但重建计算量大,10秒音频耗时784秒,实时应用仍需优化。
延伸解读
折叠采集的适用边界
USF-Audio 通过模拟折叠避免削波,但并非万能。论文指出,折叠电路无法挽回麦克风或前级已经发生的过载,因此它只解决 ADC 量程内的信号折叠问题。此外,恢复依赖信号带宽、采样率和量化位数满足特定条件,且需要较高采样率。这意味着该方案更适合在采集链路前端设计时统筹考虑,而非作为事后补救工具。
听感提升的局限与条件
52 人听音评分显示,6 位硬件采集下 USF-Audio 将平均分从 3.22 提升至 3.81,但这一改善是在低位数、动态范围受限的条件下取得的。在高位数数字仿真中,24 位 USF-Audio 与 32 位常规音频评分无显著差异。因此,该方案的价值主要体现在低位数量化或强动态范围场景,尚不能说明其全面优于成熟的高位数录音设备。
实时化是落地关键
论文中 10 秒音乐重建耗时 784 秒,远未达到实时要求。高计算量源于分帧算法处理电路噪声和非理想折叠,以及从折叠采样中恢复原始波形。若要在录音、通信或助听设备中实用,需大幅优化算法效率或借助专用硬件。此外,整机功耗、成本及对声音识别准确率的影响尚未专门测试,这些因素将决定其实际部署价值。
Q&A
USF-Audio 音频采集方案的基本原理是什么?
USF-Audio 在模数转换前用模拟电路将超出量程的信号按固定幅度折叠回有限范围,采样后再通过算法估计折叠位置与幅度,重建原始波形。
USF-Audio 在硬件实验中取得了哪些量化效果?
在 6 位量化硬件实验中,重建音频的噪声底平均改善约 18 dB;52 人听音评分从常规音频的 3.22 分提升至 3.81 分(5 分制)。
USF-Audio 目前的主要局限性是什么?
重建计算量大,10 秒音频耗时 784 秒,实时应用仍需优化;折叠电路无法挽回麦克风或前级已发生的过载;整机功耗、成本及声音识别准确率是否改善也需专门测试。
USF-Audio 与传统降低录音增益或事后去削波方法有何不同?
降低增益会损失微弱细节,事后去削波只能根据剩余波形估计丢失部分;USF-Audio 在采集端通过模拟折叠保留可恢复的结构,再由算法重建,兼顾强弱信号。
USF-Audio 的硬件原型是如何搭建和测试的?
团队用现成电子元件搭建原型,将麦克风输出同时送入折叠采集链路与常规采集链路,以 250 kHz 采样、约 6 位量化;常规参考通道输入范围 ±6.5 V,折叠后测量值位于 0—1 V。
USF-Audio 的听音评价结果说明了什么?
在 6 位硬件采集组中,USF-Audio 平均主观评分 3.81 分,高于常规音频的 3.22 分,削波音频仅 1.62 分,表明仪器测得的改善也体现在听感上;但高位数数字仿真中与 32 位常规音频无显著差异,尚不能说明全面优于成熟高位数设备。
