


使用 Amazon Application Recovery Controller Region Switch 和集中式入口控制实现自助式区域故障转移
内容提要
本文介绍受监管企业中的应用团队如何借助 Amazon ARC Region Switch,在集中式入口代理管控下实现自助式区域故障转移。方案利用 Transit Gateway 对等连接、Route 53 私有托管区和 VPC Lattice,使应用团队无需与基础设施团队协调即可独立控制 DNS 故障转移记录;中央父计划通过 AWS RAM 按依赖顺序执行各团队共享的子计划,实现组合级协调恢复,兼顾安全合规与团队自主性。
延伸解读
集中入口与自助故障转移的边界划分
文章的核心思路是用技术边界替代跨团队协调:基础设施团队继续拥有入口代理和Transit Gateway,应用团队只控制自己的Route 53私有托管区中的故障转移记录。这样安全策略、审计日志仍由中央入口统一执行,而应用团队无需接触代理配置即可切换流量。这种划分把“谁负责什么”写进了架构,而非依赖流程约定,是受监管企业兼顾合规与自主性的关键。
跨区域额外一跳是有意取舍
Global Accelerator会把用户导向最近接入点,若应用只在另一区域活跃,流量需经Transit Gateway对等连接跨区域到达。文章明确指出这是有意接受的额外网络跳数,换取的是故障转移时无需基础设施团队介入。读者应意识到,这一设计会带来跨区域延迟,尤其当故障转移后服务调用位于另一区域的依赖时,需要按文章建议测试真实的混合组合,而非只测全量切换。
细粒度故障转移的收益与双模风险
借助VPC Lattice服务网络端点,每个服务可获得独立DNS名称并映射到各自的故障转移记录,团队能逐个服务验证,而不必一次性翻转整个端点。文章同时提醒,这种组件级切换会增加活跃/待机组合,可能产生双模行为——正常与故障模式下响应时间或流程不同。因此它更适合对延迟和组合有把握的团队;否则,较粗粒度的整体切换可能是更稳妥的选择。
父子计划把依赖关系变成可执行编排
应用团队通过AWS RAM把各自计划共享给中心账户,父计划按依赖顺序调用子计划,只有上游成功后才执行下游。这解决了多应用相互依赖时靠电话和会议协调的问题,同时每个子计划仍由所属团队独立拥有、版本化和测试。文章强调,共享只授予中心账户访问权,不改变计划内容;父计划可端到端演练,从而在真实事件前验证组合级恢复是否可行。
Q&A
在受监管企业里,应用团队如何在不依赖基础设施团队的情况下独立执行区域故障转移?
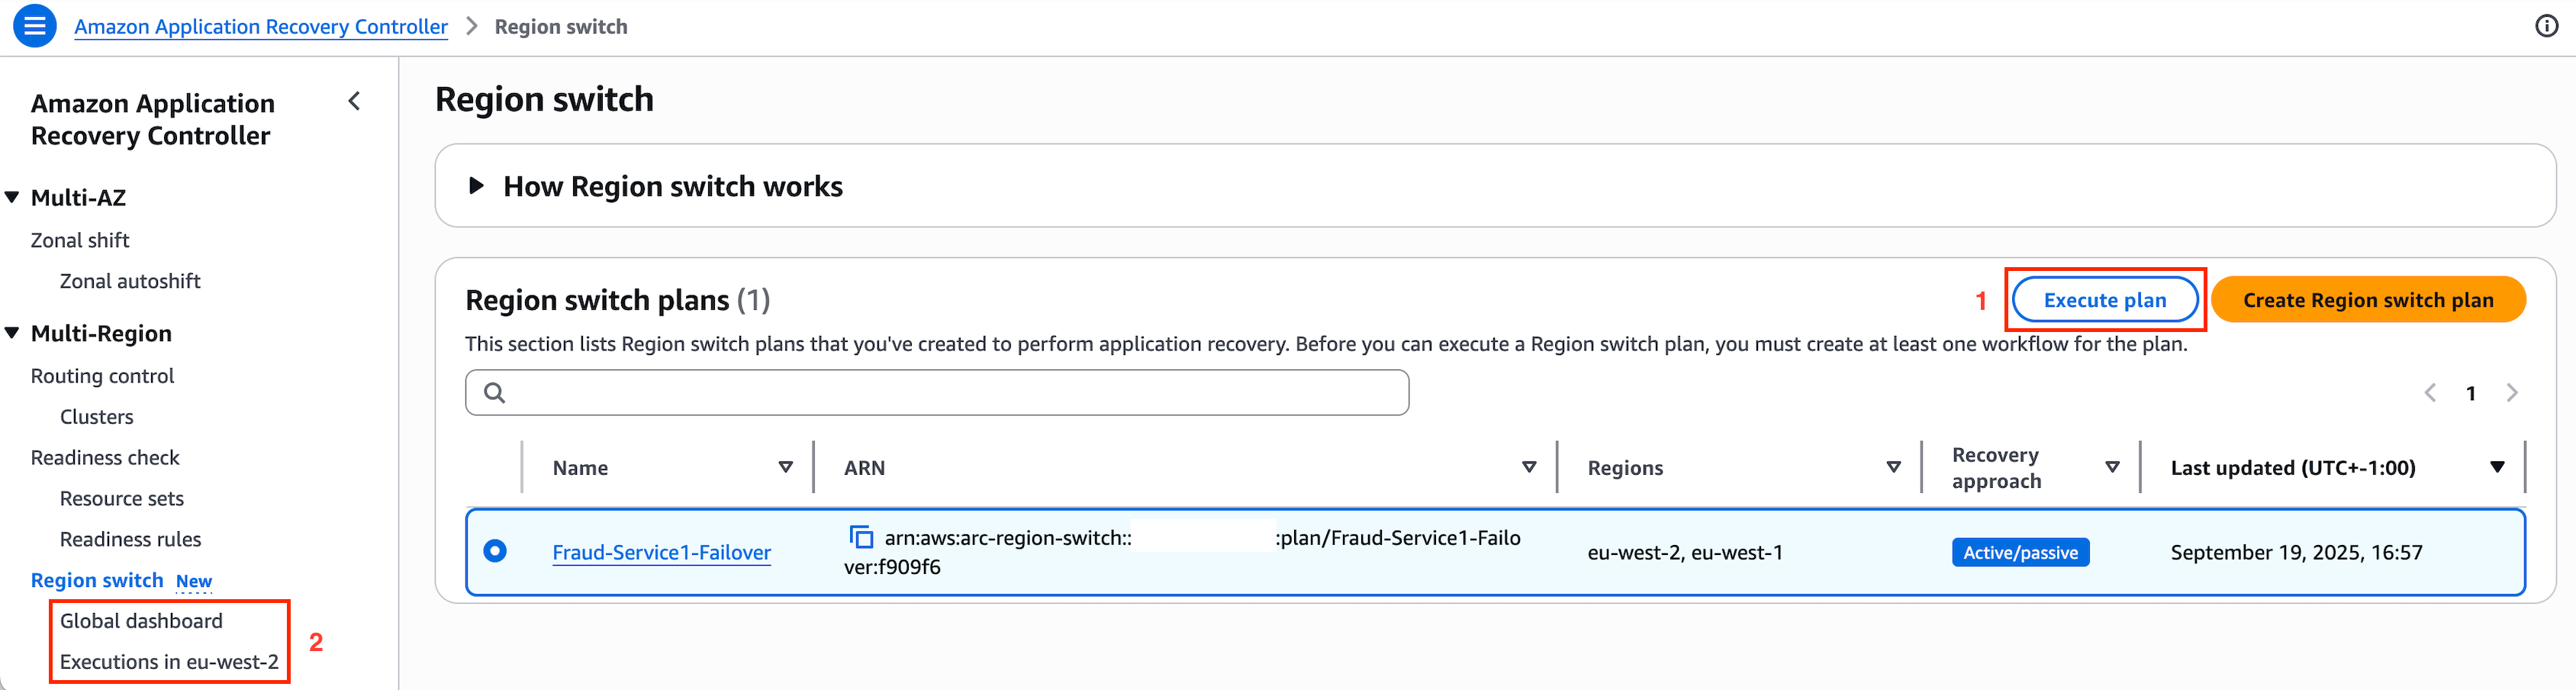
应用团队可以使用 Amazon ARC Region Switch 创建故障转移计划,并通过控制自己拥有的 Route 53 私有托管区中的故障转移记录集来切换流量。基础设施团队负责集中式入口代理和 Transit Gateway 等网络基础,应用团队则独立管理 DNS 记录,从而无需协调即可完成故障转移。
ARC Region Switch 如何解决灾难恢复计划中的配置漂移问题?
Region Switch 会自动评估计划的配置、IAM 权限和资源就绪状态,每小时多次检查,并在控制台、EventBridge 或 API 中显示警告,从而在故障转移前发现配置漂移问题。
使用 VPC Lattice 服务网络端点如何实现更细粒度的故障转移控制?
每个 VPC Lattice 服务可以关联到服务网络端点并获得独立的区域 DNS 名称,每个名称映射到 Route 53 私有托管区中独立的故障转移记录集。这样应用团队可以逐个服务进行故障转移,而不是一次性切换所有服务。
如何协调多个相互依赖的应用进行组合级故障转移?
通过 AWS RAM 将各应用团队的 Region Switch 计划共享到中心账户,并作为子计划添加到父计划中。父计划按依赖顺序执行子计划,只有前一个子计划成功完成后才运行下一个,从而实现确定性的组合级恢复。
故障转移完成后,还需要执行哪些恢复后工作流?
恢复后工作流包括:验证应用健康状态(如运行合成事务)、检查数据完整性、验证依赖服务;调整扩展策略和告警配置;准备原主区域作为新备用;以及生成合规证据和通知。这些步骤也作为 Region Switch 计划中的执行块自动运行。
ARC Region Switch 计划如何实现自动化触发以减少恢复时间?
计划可以通过 CloudWatch 告警自动触发,从而消除检测和决策时间。团队还可以选择添加手动批准步骤,在关键点进行人工控制。
