ChatGPT擅长搜索排序吗?
内容提要
这篇EMNLP2023论文研究了大语言模型在搜索排序中的表现,提出了一种直接输出段落排序组合的方案,并使用蒸馏技术将GPT-4的排序能力转移到更小的模型上。实验结果显示,GPT-4在TREC和BEIR数据集上表现优异,使用GPT-4对由ChatGPT重排序的段落进行重新排序的方法取得了良好结果。
延伸解读
滑动窗口策略的公平性局限
论文采用滑动窗口策略应对LLM输入长度限制,但作者指出该方法从全局看可能不公平,因为段落间的排序未必存在偏序传递关系。例如,局部比较中胜出的段落不一定全局更优。此外,作者认为随着LLM长度限制的放宽,该策略的意义已不大。
蒸馏小模型以降低成本
由于GPT-4排序成本高昂,论文尝试将GPT-4的排序能力蒸馏到更小的专用模型。具体从MS MARCO抽取10,000个查询,用BM25检索20个候选段落,通过减少学生模型与ChatGPT排序输出的差异进行训练。这为实际部署提供了成本更优的替代方案。
GPT-4与ChatGPT的排序表现对比
实验显示,GPT-4在TREC和BEIR数据集上表现优异,相比monoT5 (3B),nDCG@10分别平均提升2.7和2.3。ChatGPT在BEIR上也超过大多数监督基线。此外,用GPT-4对ChatGPT重排序的前30个段落进行再排序,成本仅为完全使用GPT-4的1/5,效果良好。
Q&A
ChatGPT在段落重排序任务中的表现如何?
ChatGPT在段落重排序任务中表现良好,尤其在BEIR数据集上超过了大多数监督基线。
论文中提出了哪些零样本段落重排序的指令?
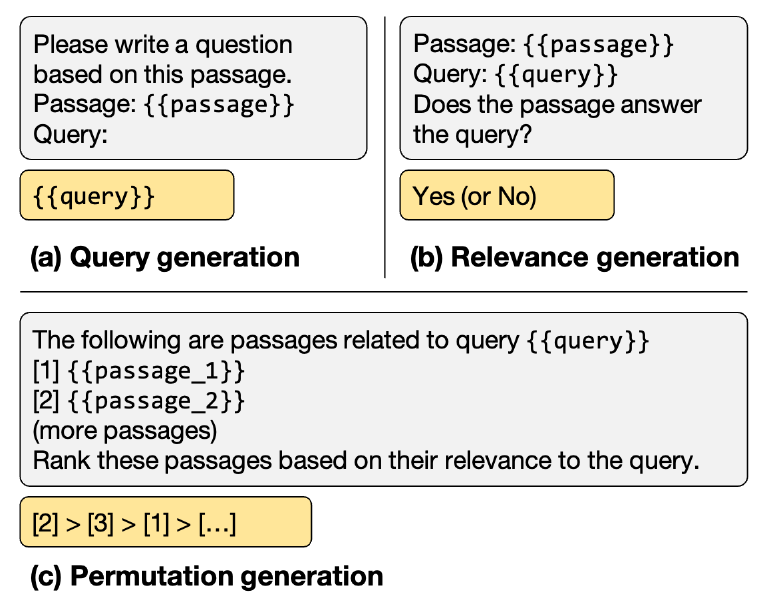
论文提出了查询生成、相关性生成和排序生成三种零样本段落重排序的指令。
如何将GPT-4的排序能力转移到更小的模型上?
采用蒸馏技术将GPT-4的排序能力转移到更小的专用模型中,以减少两者输出之间的差异。
GPT-4在TREC和BEIR数据集上的表现如何?
GPT-4在TREC和BEIR数据集上表现优异,显著提高了nDCG@10。
滑动窗口策略在段落排序中有什么问题?
滑动窗口策略在全局上可能不公平,因为不同段落之间的排序未必存在偏序传递关系。
使用GPT-4对ChatGPT重排序的段落有什么优势?
使用GPT-4对ChatGPT重排序的段落成本仅为使用GPT-4进行重排序的1/5,同时取得了良好的结果。
