


面向AI工程师的评估
内容提要
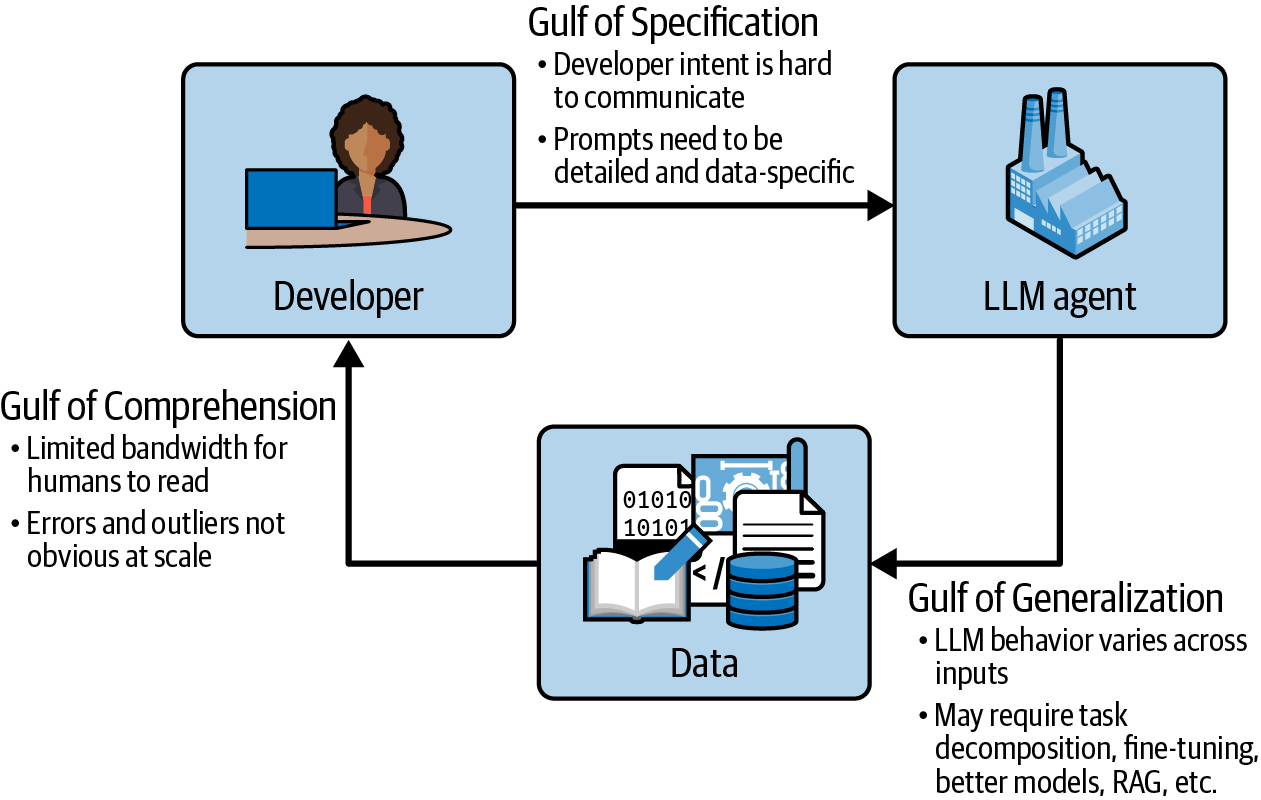
文章介绍AI评估中的“三大鸿沟”框架:理解鸿沟指开发者需了解真实输入输出及模型行为;规范鸿沟指意图与提示词之间的差距,需明确要求;泛化鸿沟指模型即使指令清晰仍会出错。作者提出“分析—测量—改进”循环:先查看真实轨迹识别失败模式,再用自动评估器量化发生频率,最后根据问题来源修改提示词或采取更强干预。
延伸解读
先诊断鸿沟,再决定修复方式
文章强调,遇到AI应用失败时,应先判断问题属于哪条鸿沟:理解鸿沟需要查看更多真实轨迹;规范鸿沟需要修改提示词或代理逻辑;泛化鸿沟则需测量发生频率并考虑更强干预。这种分类能避免团队笼统归因于“模型不行”,从而选择正确的修复路径,而不是盲目调参或重写提示词。
评估不是一次性检查,而是迭代循环
文章提出“分析—测量—改进”循环:先阅读真实轨迹识别失败模式,再用自动评估器量化频率,最后根据问题来源修改提示词或采取更强干预。这个循环强调需求往往在与真实输出交互后才变得清晰,因此评估应贯穿开发过程,而非上线前的一次性验收。每轮循环都能帮助团队更准确地判断鸿沟所在。
用户能力决定评估严格程度
文章对比了编程助手和个人造型师:程序员能精确表达需求、阅读调试代码并运行测试,因此能自行弥合部分鸿沟;而普通用户可能无法清晰指定要求,也难以发现泛化失败。文章指出,当用户难以自行发现错误或错误代价较高时,应用需要设计更严格的评估流程来弥合鸿沟。
测量泛化错误需要自动化评估器
文章以邮件代理为例:即使提示词已明确要求从邮件头提取发件人,模型仍可能因正文提到公众人物而返回错误姓名。这类泛化错误无法靠修改提示词解决,需要通过代码规则或LLM作为评判者等自动评估器,在大量输出上量化发生频率,从而判断它是偶发困扰还是系统性问题。
Q&A
什么是LLM应用开发中的“三大鸿沟”框架?
三大鸿沟框架是用于理解和诊断LLM应用开发挑战的模型,包括理解鸿沟(开发者与数据之间的差距)、规范鸿沟(开发者意图与给LLM的指令之间的差距)和泛化鸿沟(数据与LLM泛化能力之间的差距)。
如何判断LLM应用的失败是规范问题还是泛化问题?
如果提示词没有明确表达要求,导致模型行为不一致,属于规范问题,可通过改进提示词或代理逻辑修复;如果提示词已经清晰明确,但模型仍偶尔出错,则属于泛化问题,需要测量错误频率并考虑更强干预(如增加示例、改进检索或微调)。
Analyze-Measure-Improve生命周期具体包括哪些步骤?
Analyze阶段查看真实输入输出轨迹,识别失败模式;Measure阶段设计自动评估器量化失败模式的发生频率;Improve阶段根据错误来源修改提示词或采取更强干预(如增加示例、改进检索、微调)。
为什么LLM应用评估不是一次性的检查?
因为每个应用都需要在自身上下文中重新跨越三大鸿沟,且需求只有在与真实输出交互后才会清晰。评估是一个迭代过程,需要不断分析、测量和改进。
在客户支持聊天机器人中,三大鸿沟分别体现在哪些方面?
理解鸿沟体现在客户查询的多样性(多语言、拼写错误、多部分问题);规范鸿沟体现在定义“好”的响应(如何时应转人工);泛化鸿沟体现在机器人能处理好账单问题但在产品特定问题上表现不佳。
如何根据应用的风险高低设计评估策略?
在风险较高的鸿沟上(用户难以自行发现错误或错误成本高),需要设计更严格的流程来闭合鸿沟。例如,个人造型师应用需要主动提问澄清需求,并更严谨地测量泛化失败。
