


使用GPT-5模型系列构建应用:实用指南
内容提要
OpenAI发布GPT-5,性能更强、更易操控,在SWE-bench Verified达74.9%,擅长编程与多步智能体任务。官方建议迁移至Responses API以保留推理上下文,优化提示词并建立评估基线,用reasoning_effort和verbosity控制思考深度与输出长度,并针对过度思考、冗长等问题调优提示。
延伸解读
迁移到 Responses API 的必要性
文章强调,只有 Responses API 能让 GPT-5 在多次对话和工具调用中保留推理链(reasoning items),从而提升性能并利用缓存降低成本。Chat Completions API 不支持此功能。因此,若想充分发挥 GPT-5 的智能,迁移到 Responses API 是首要步骤,尤其适合需要多步推理和工具调用的智能体应用。
提示词优化:从评估基线开始
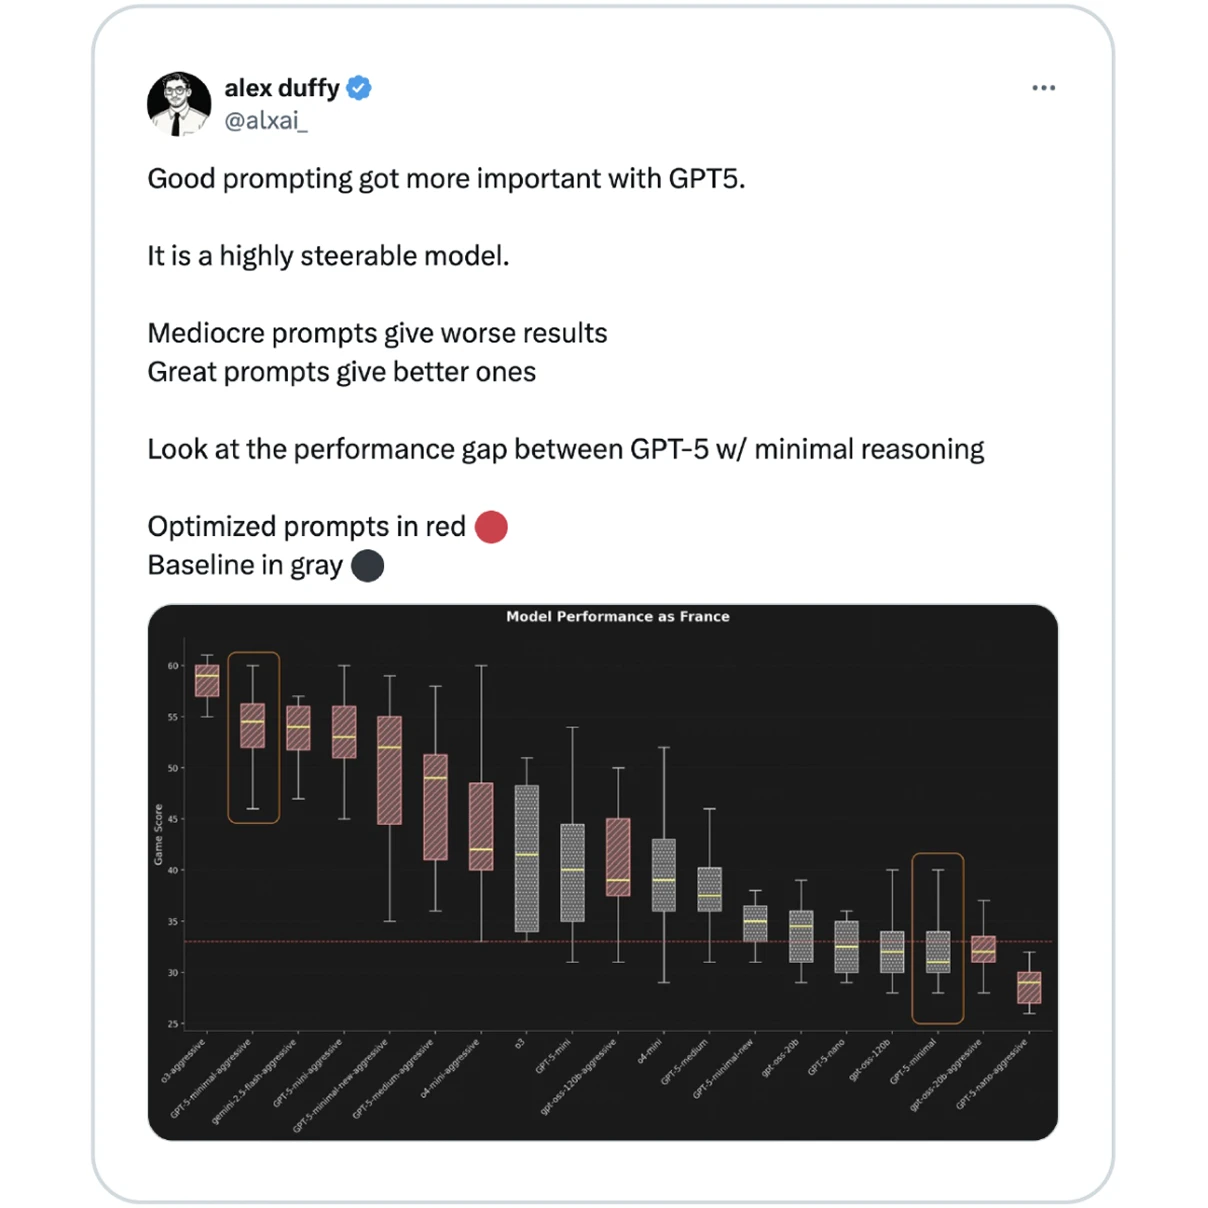
文章建议先使用现有提示词在评估集上建立基线,观察输出偏差。然后利用 Responses API 流式输出推理摘要,定位问题。GPT-5 擅长元提示(metaprompting),且通常需要更少的脚手架,更短更清晰的指令可能效果更好。将稳定有效的提示词模板化并文档化,有助于团队一致性和持续迭代。
利用 reasoning_effort 和 verbosity 精细控制
GPT-5 新增 reasoning_effort 和 verbosity 参数,分别控制思考深度和输出长度。reasoning_effort 可选 minimal、low、medium、high,默认 medium;verbosity 可选 low、medium、high。文章指出没有唯一最佳配置,需根据任务复杂度系统实验,并结合评估找到适合自己用例的设置。
常见问题与调优方向
文章列举了过度思考、思考不足、过度顺从、输出冗长、延迟、工具过度使用和工具调用格式错误等常见问题。由于 GPT-5 高度可操控,通过仔细调整提示词、结合评估和元提示,大多数问题可以快速解决。文章还指向 GPT-5 故障排除手册以获取更深入的诊断和修正指导。
Q&A
GPT-5在编程任务上的性能表现如何?
GPT-5在SWE-bench Verified上达到74.9%的准确率,擅长编程和多步智能体任务,能够解析复杂输入、编排工具使用和管理多阶段工作流。
为什么建议从Chat Completions API迁移到Responses API?
Responses API允许模型在对话轮次和工具调用之间持久化推理链(推理项),使每次请求都能访问完整的内部上下文,从而显著提升性能并改善缓存以降低成本。Chat Completions API不支持这些功能。
如何优化GPT-5的提示词?
首先用现有提示词运行评估以建立基线,然后检查模型推理以定位问题。利用GPT-5的元提示能力改进提示词,通常需要更少的脚手架,更短更清晰的指令可能效果更好。最后将有效的提示词模板化并文档化。
reasoning_effort参数有什么作用?如何设置?
reasoning_effort控制模型思考的深度以及调用工具的倾向。默认值为medium,可选minimal、low、medium、high。应根据任务复杂度实验调整,并用评估来衡量效果。
verbosity参数如何影响GPT-5的输出?
verbosity影响模型输出的长度,可选low、medium、high。你还可以添加提示指令,让模型在特定场景下覆盖默认设置。
使用GPT-5时常见的故障有哪些?如何解决?
常见问题包括过度思考、思考不足、过度顺从、输出冗长、延迟问题、工具过度使用和工具调用格式错误。由于GPT-5高度可操控,通过仔细调整提示词、结合评估和元提示,大多数问题可以快速解决。
