

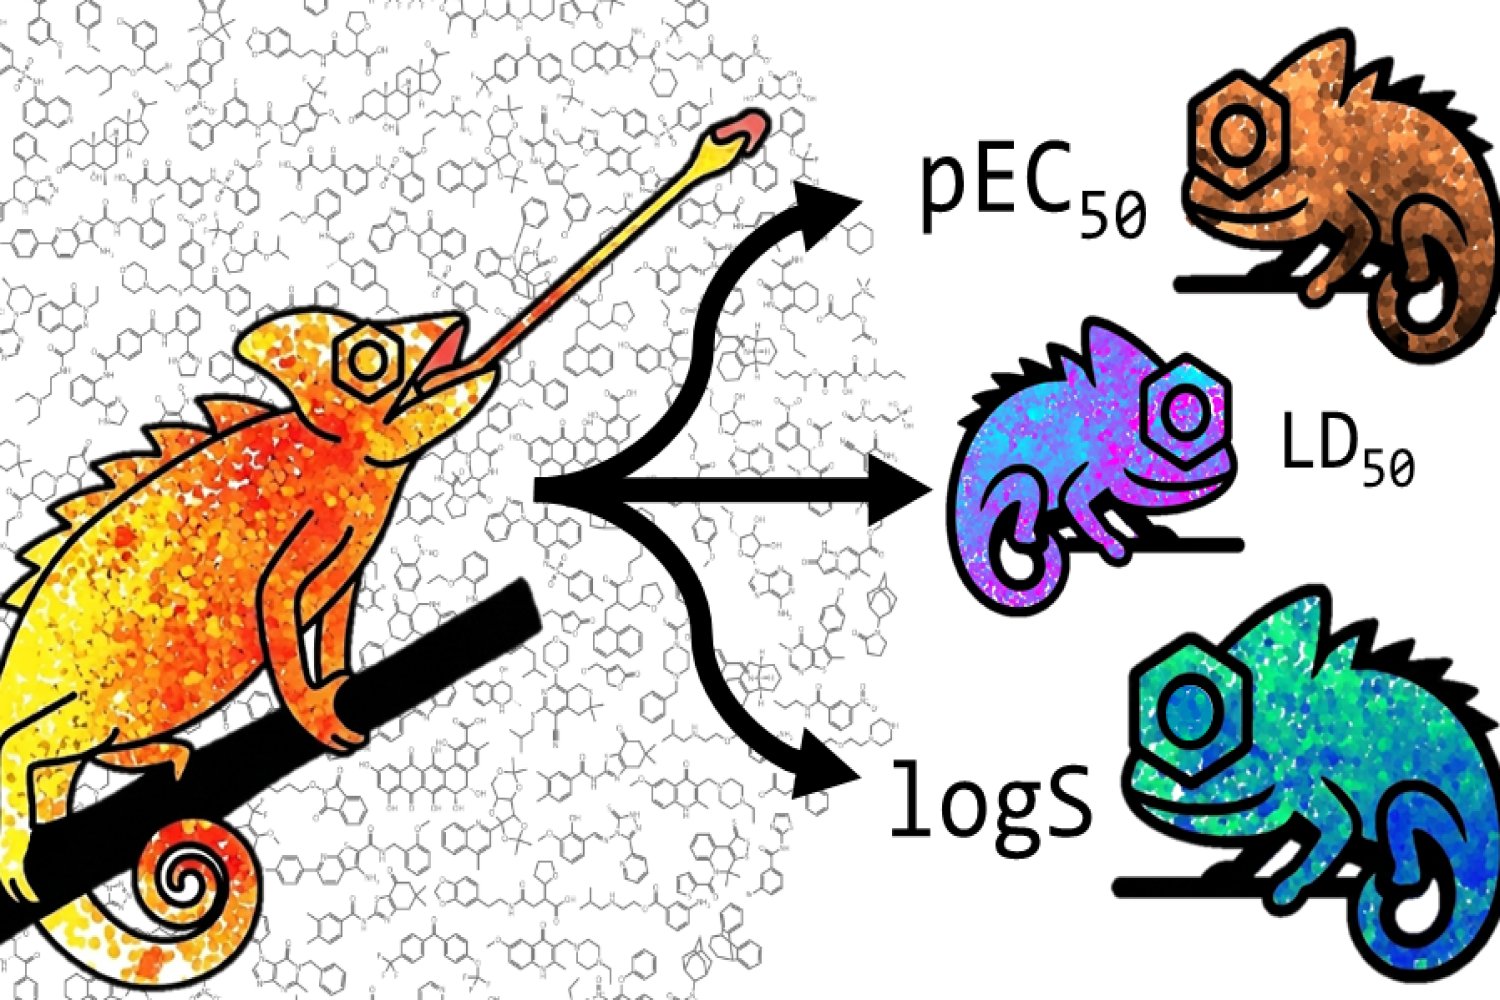

如何用少量数据预测分子行为
内容提要
麻省理工学院开发出机器学习模型CheMeleon,通过预训练约百万分子的1600种分子描述符学习化学规律,微调后可用少量数据预测新分子性质。该模型在58项测试中优于其他基础模型和传统专家模型,在OpenADMET竞赛前20名中占9席,已被多家药企采用,可大幅减少实验合成与测试。
延伸解读
预训练策略:用描述符替代文献数据
CheMeleon 的预训练不依赖化学文献,而是从 PubChem 取约百万分子,计算约 1600 种分子描述符作为学习目标。这与依赖海量文献文本的模型形成对比,也解释了它为何能在数据稀缺场景下工作:模型先学会结构与描述符之间的通用关联,再迁移到具体性质预测。
少样本微调的实际意义
文章强调,CheMeleon 作为基础模型,微调时只需少量数据点就能获得较好性能,因为它不必从零学习化学规律。对药企而言,这意味着在针对新靶点或新性质时,可减少前期实验合成与测试量,更快筛掉不值得合成的分子,但文章未给出具体所需数据量或精度数字。
竞赛表现与行业采用
在 OpenADMET 组织的预测未合成分子性质的竞赛中,前 20 名有 9 个使用了 CheMeleon。文章还提到至少一家药企将其定为建模新性质时的默认起点。这些信号说明模型在真实任务中已有初步外部验证,但竞赛排名不等于临床或生产决策中的可靠性,仍需结合具体场景评估。
与专家模型的分工而非替代
传统专家模型依赖研究者手动输入已知的构效关系,如溶解度与分子量、氧原子数或支链程度相关。CheMeleon 则从数据中自行学习底层模式。文章在 58 项测试中报告其优于其他基础模型和传统专家模型,但这不意味着专家知识不再重要;在数据极少或机理复杂的任务中,两者结合可能更稳妥。
Q&A
CheMeleon是什么?它由谁开发?
CheMeleon是麻省理工学院(MIT)开发的一种机器学习模型,属于预训练基础模型,旨在用少量数据预测分子性质。它基于开源机器学习包ChemProp构建,可通过ChemProp下载并微调。
CheMeleon如何实现用少量数据预测新分子性质?
CheMeleon首先使用约一百万分子的1600种分子描述符进行预训练,学习化学规律;然后针对特定性质(如溶解度、毒性)用少量数据微调,从而预测新分子的性质。
CheMeleon在哪些测试中表现优于其他模型?
在58项测试中,CheMeleon优于其他基础模型和传统专家模型。在OpenADMET竞赛前20名中,有9个参赛者使用了CheMeleon。
CheMeleon已经被哪些机构或公司采用?
已被多家制药公司采用,至少一家制药公司将其作为公司政策,要求在进行性质建模时从CheMeleon开始。
CheMeleon与传统专家模型相比有什么优势?
传统专家模型需要专家手动输入领域知识,而CheMeleon通过预训练自动学习化学规律,无需大量数据即可微调,且性能更优,能大幅减少实验合成与测试的需求。
CheMeleon使用什么数据源进行预训练?
使用PubChem数据库中的约一百万分子的分子描述符(约1600种)进行预训练,不依赖文献数据。
