

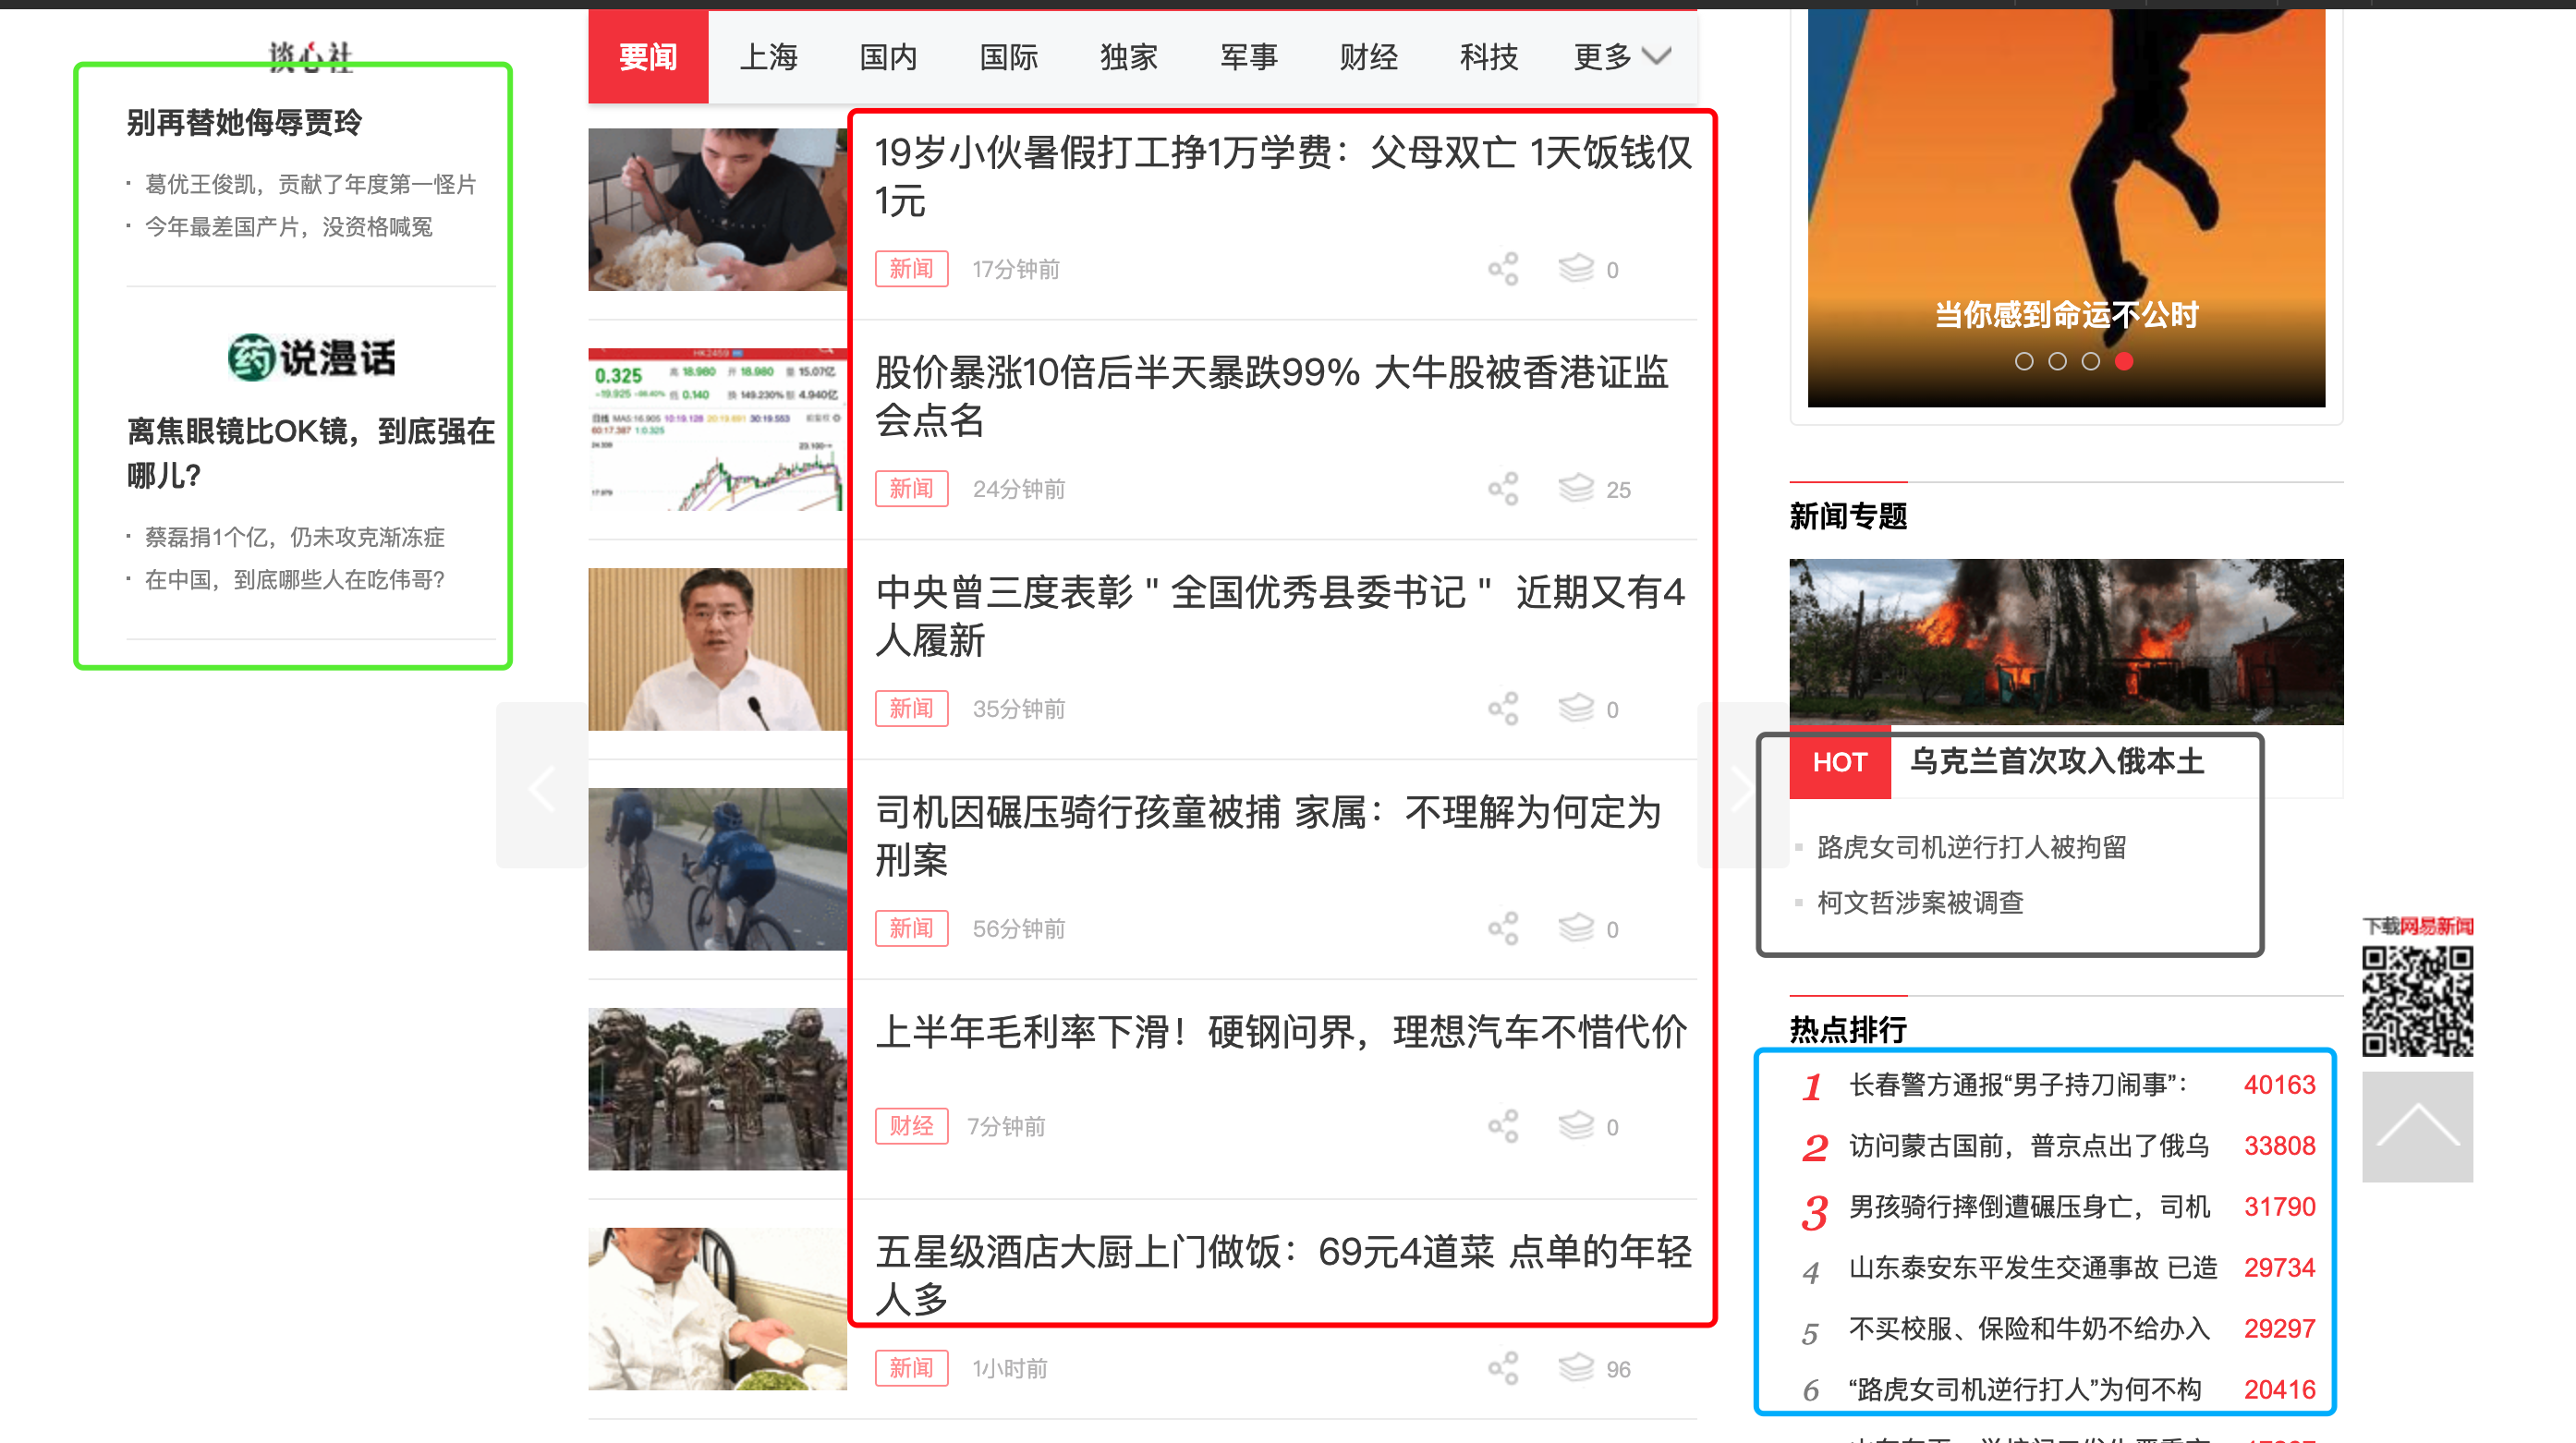

一日一技:图文结合,大模型自动抓取列表页
原文中文,约2100字,阅读约需5分钟。
📝
内容提要
GNE工具能提取文章正文,但无法抓取列表页。作者利用GLM-4V-Plus模型,通过图片识别和HTML分析,成功提取列表页的文章标题和URL,并验证了自动生成的XPath的有效性。计划结合DrissionPage实现全自动爬虫,邀请读者留言表达兴趣。
🔎
延伸解读
GNE工具的局限性
尽管GNE工具在提取文章正文方面表现出色,但其无法处理列表页的局限性显而易见。列表页的结构复杂,元素位置不固定,导致自动抓取时容易出现错误。这一问题在使用传统方法时尤为突出,开发者需谨慎选择工具以确保数据的准确性。
GLM-4V-Plus的优势
GLM-4V-Plus模型结合了图片识别和HTML分析,能够有效识别列表页中的文章标题和URL。这种创新方法为爬虫技术带来了新的可能性,尤其是在处理异步加载页面时,开发者可以期待更高的抓取效率和准确性。
全自动爬虫的前景
结合GLM-4V-Plus和DrissionPage的全自动爬虫计划,标志着爬虫技术的一个重要进步。通过自动化处理,开发者不仅可以节省时间,还能提高数据抓取的准确性。这一技术的实现将为数据分析和信息获取带来更大的便利。
❓
Q&A
GNE工具的主要功能是什么?
GNE工具可以自动提取文章页面的正文,但不支持列表页的自动抓取。
为什么列表页的内容提取比较困难?
列表页的内容位置难以定义,程序可能会提取错误的元素。
GLM-4V-Plus模型如何改善列表页的提取效果?
GLM-4V-Plus模型结合图片识别和HTML分析,能够准确找到文章列表位置。
如何验证自动生成的XPath的有效性?
通过手动验证自动生成的XPath,确保能够正确找到每篇文章的标题和URL。
文章中提到的DrissionPage有什么作用?
DrissionPage计划与GLM-4V-Plus结合,实现全自动爬虫。
作者对全自动爬虫的未来有什么期待?
作者期待结合GLM-4V-Plus和DrissionPage实现真正的全自动爬虫,并邀请读者留言表达兴趣。
🏷️
