
智谱新模型,490 tokens/s!
内容提要
智谱在Zcode中灰度上线GLM-5.3-Highspeed模型,实测速度达490 tokens/s,远超GLM-5.3-FlashX的200 tokens/s。该模型上下文窗口100万token,最大生成128k,分低中高三档思考强度,配置与普通版一致。有猜测称其与OpenCode匿名模型Omen Alpha有关,目前仍在随机灰度中。
延伸解读
速度提升的实际意义
GLM-5.3-Highspeed实测速度达490 tokens/s,相比GLM-5.3-FlashX的200 tokens/s和GLM-5.3-Flash的约60 tokens/s有显著提升。这意味着在长程任务中,生成1万token仅需约20秒,能大幅减少等待时间,提升交互效率。
配置与思考强度
该模型上下文窗口为100万token,最大生成128k token,并提供low、high、max三档思考强度。这些配置与GLM-5.3普通版一致,用户可根据任务复杂度调整思考强度,平衡速度与效果。
灰度状态与获取方式
目前GLM-5.3-Highspeed在Zcode 3.15.1中随机灰度,订阅用户有机会体验。并非所有用户都能立即使用,需等待灰度覆盖。文章作者尝试手动添加未成功,可能因套餐或灰度限制。
与Omen Alpha的关联猜测
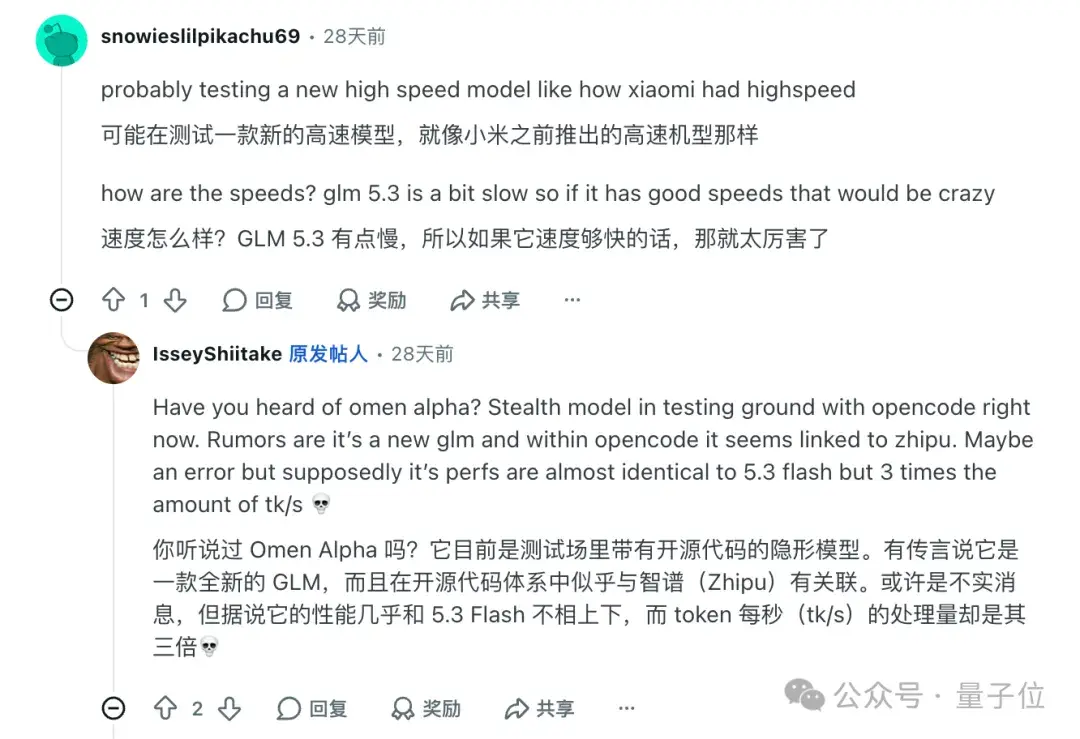
有网友猜测GLM-5.3-Highspeed可能与OpenCode上的匿名模型Omen Alpha有关,后者被认为与GLM相关。但具体关系尚未证实,也有猜测指向GLM-5.3-Omni或GLM-5.4-Flash,需等待官方信息。
Q&A
GLM-5.3-Highspeed模型是什么?在哪里可以体验?
GLM-5.3-Highspeed是智谱在Zcode中灰度上线的新模型,订阅用户可随机获得体验资格。
GLM-5.3-Highspeed的实测速度有多快?
据网友爆料,实测速度达到490 tokens/s,接近500TPS。
GLM-5.3-Highspeed与GLM-5.3-FlashX的速度对比如何?
GLM-5.3-Highspeed实测490 tokens/s,远超GLM-5.3-FlashX的最高200 tokens/s。
GLM-5.3-Highspeed的上下文窗口和最大生成token是多少?
上下文窗口为100万token,最大生成token上限为131,072(约128k)。
GLM-5.3-Highspeed的思考强度配置有哪些档位?
分为low、high、max三档思考强度配置。
GLM-5.3-Highspeed与OpenCode上的匿名模型Omen Alpha有关吗?
有网友猜测两者可能有关,但尚无定论,Omen Alpha的真实身份众说纷纭。
