


让翻译跟上对话:语音到语音同传的实时挑战
内容提要
语音到语音同传的难点不在翻译本身,而在于一句话尚未说完时就要边听、边理解、边翻译并自然说出。传统ASR、翻译、TTS三级流水线易误差传递、丢失语气。同传核心是把握开口时机,在准确、实时、自然间取舍,并保留语义、表达与说话人特征。评价需兼顾准确性、延迟、稳定性、自然度与鲁棒性。技术正从级联走向更统一模型,两条路线各有优劣,也可组合使用。
延伸解读
开口时机:同传的核心权衡
同传系统必须在信息不完整时决定何时开口。等得越久,上下文越完整,但延迟越高;开口越早,越实时,却可能因歧义而翻错。例如“不是不能做”若被简化成“我们会做”,就扭曲了原意。系统需要动态判断哪些内容已足够明确,哪些还需等待,并在目标语言中保留限定和转折空间。这种“读多少、写多少”的策略,是同传区别于普通翻译的关键。
级联与端到端:各有取舍
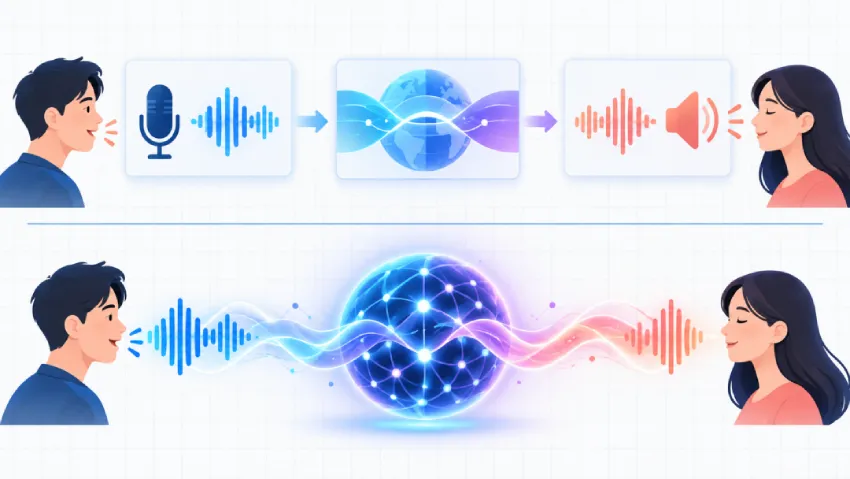
传统三级流水线(ASR、翻译、TTS)结构清晰,便于定位错误,但误差会逐级传递,且文字中间层易丢失语气信息。更统一的端到端模型直接连接源语音与目标语音,有望降低延迟、保留语调,但错误更难拆解。两者并非替代关系:级联系统易审计修正,端到端系统更自然实时。实际产品可能组合使用,例如统一模型实时生成,独立模块负责校验和字幕。
评价同传:多指标平衡
仅看译文准确率不足以评价同传系统。还需关注延迟、增量稳定性(已输出结果是否频繁改变)、语音自然度、表达保持(疑问、强调、情绪)以及鲁棒性(噪声、口音、多人插话)。这些指标常相互冲突:等待更久可提升准确率但增加延迟;快速短片段输出可能牺牲连贯性。因此,评价标准应是系统能否针对具体场景(如国际会议、旅行对话)在准确、实时与自然间找到合适平衡。
声音复刻的边界与责任
同传不仅传递语义,还可能涉及表达风格和说话人身份特征。保留语气能增强交流感,但情绪迁移错误可能改变态度;声音复刻则涉及授权、隐私和滥用风险。可靠的产品需明确区分内容翻译、表达风格迁移和声音复刻,并为后两者设置清晰的授权边界。技术越接近“像本人”,越需要谨慎处理这些伦理和法律问题。
Q&A
语音到语音同传和普通语音翻译有什么本质区别?
普通语音翻译通常等一句话说完再处理,而同传需要在说话人尚未说完时就开始翻译,边听边理解边输出,核心挑战是把握开口时机,在信息不完整时做出取舍。
传统ASR+翻译+TTS三级流水线做同传有什么缺点?
主要缺点是误差传递和声音信息丢失。ASR识别错误会传递到翻译和TTS,导致流畅但错误的结果;只传递文字会丢失停顿、强调、情绪等声音信息,合成语音难以还原说话人的表达方式。
同传系统为什么很难决定什么时候开始翻译?
因为需要权衡上下文完整性和实时性。等太久会失去同传意义,开口太早可能因上下文不足而翻错,比如把尚未明确的态度翻成确定承诺。不同语言语序差异还会放大这个问题,系统必须持续判断何时有把握输出。
评价一个语音到语音同传系统应该看哪些指标?
至少包括语义准确性、延迟、增量稳定性、语音自然度、表达保持和鲁棒性。这些指标会互相冲突,真正的标准是系统能否在准确、实时和自然之间找到适合具体场景的平衡。
语音到语音同传的技术路线有哪些?各有什么优劣?
主要有两条路线:一是流式级联系统,保留ASR、翻译、TTS三个模块但协同工作,优点是结构清晰、易排查问题;二是更统一的端到端模型,直接连接源语音和目标语音,能更好保留语调情绪、降低延迟,但错误难拆解。两者可组合使用。
同传系统在保留说话人声音和语气时需要注意什么?
需要区分语义、表达和身份特征三个层次。保留语气和声音特征能增强交流感,但情绪迁移错误可能改变态度,声音复刻涉及授权、隐私和滥用风险。可靠产品应明确区分内容翻译、风格迁移和声音复刻,并设置授权边界。
