


数据不足时的学习(第二部分):主动学习
内容提要
主动学习在标注预算有限时,从无标注数据中挑选最有价值的样本交由人工标注,以最大化模型提升。其核心是设计采集函数,常用策略包括不确定性采样(最低置信度、边际、熵、委员会投票)、多样性采样、预期模型变化及混合策略。深度方法包括MC dropout、贝叶斯神经网络、损失预测、对抗式VAAL/MAL、对比学习CAL、核心集、BADGE梯度嵌入、BALD、遗忘事件等。
延伸解读
采集函数:主动学习的核心
主动学习的效果很大程度上取决于采集函数的设计。文章系统梳理了不确定性采样、多样性采样、预期模型变化及混合策略等基本方法,并指出深度模型预测常过度自信,直接使用概率估计不确定性可能不可靠。因此,实际应用中需结合模型校准或采用贝叶斯近似来获得更准确的不确定性度量。
深度不确定性估计的实用选择
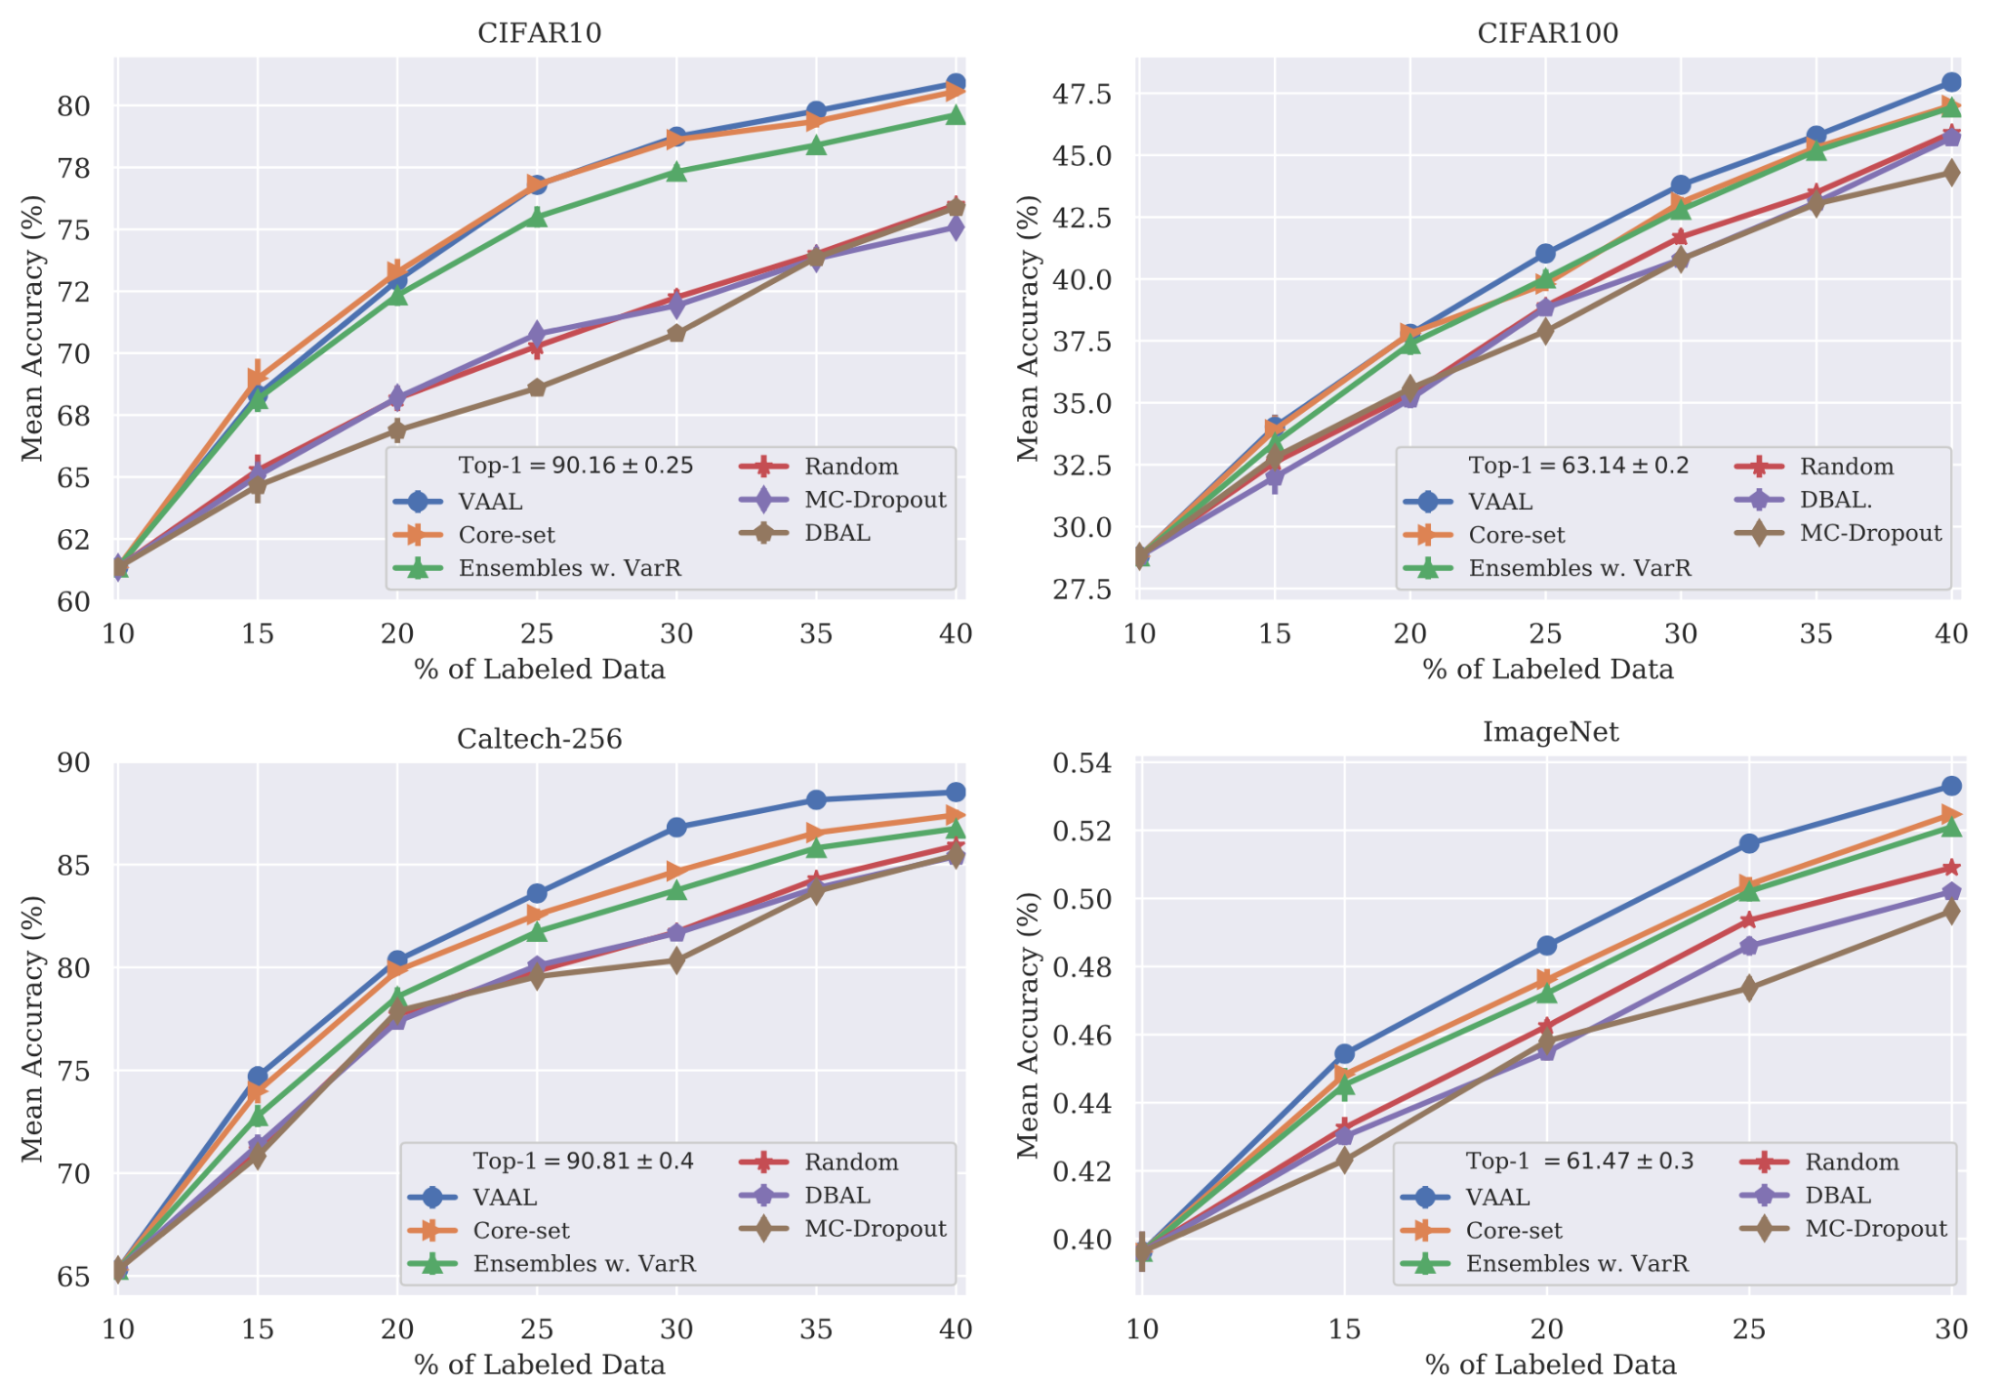
为估计模型不确定性,文章介绍了MC dropout、贝叶斯神经网络、深度集成等方法。实验表明,朴素集成配合变异率能获得更好的校准预测,但计算成本高昂;MC dropout则以较低成本提供可接受的不确定性估计,适合资源受限场景。此外,损失预测、对抗式VAAL/MAL、对比学习CAL等方法从不同角度提升了采样效率。
多样性与代表性:避免采样偏差
仅依赖不确定性可能导致选出的样本高度相似,忽略数据整体分布。文章强调多样性采样和代表性方法(如核心集、BADGE梯度嵌入)的重要性。核心集通过几何近似选择代表点,但在类别多或维度高时效果下降;BADGE则在梯度空间中同时捕捉不确定性和多样性,适合批量主动学习。
混合策略与半监督结合
单一策略往往难以兼顾不确定性和代表性,混合策略如Suggestive Annotation先选高不确定性候选,再用核心集挑代表样本。此外,主动学习可与半监督学习结合,如CEAL对高置信样本赋予伪标签,从而在有限标注预算下进一步节省成本。这些方法为实际部署提供了灵活的选择。
Q&A
主动学习是什么?它主要解决什么问题?
主动学习是一种在标注预算有限的情况下,从无标注数据中挑选最有价值的样本交由人工标注,以最大化模型性能提升的方法。它主要解决标注成本高、数据标注困难(如医学图像)的问题。
主动学习中常用的不确定性采样策略有哪些?
常用的不确定性采样策略包括:最低置信度(1 - 最大预测概率)、边际采样(最大两个预测概率之差)、熵采样(预测概率分布的熵),以及基于委员会投票的方法如投票熵、共识熵和KL散度。
MC dropout 是如何用于估计模型不确定性的?
MC dropout 在每次前向传播时对每个权重层应用不同的 dropout 掩码,通过多次采样得到预测分布,从而近似贝叶斯神经网络的后验,估计认知不确定性。该方法被证明在数学上等价于深度高斯过程的近似。
核心集(Core-set)方法在主动学习中是如何选择样本的?
核心集方法将主动学习视为核心集选择问题,目标是选择一组样本使得模型在核心集上的损失与在整个数据集上的损失差异最小。这等价于 k-Center 问题:选择 b 个中心点,使所有数据点到最近中心的距离最大值最小。通常用贪心算法近似求解。
BADGE 主动学习策略是如何同时考虑不确定性和多样性的?
BADGE 在梯度空间中同时衡量不确定性和多样性。不确定性通过未标注样本的预测标签对应的损失相对于最后一层参数的梯度范数来估计;多样性则通过对所有梯度嵌入运行 k-means++ 来采样,确保选出的样本在梯度空间中分散。
遗忘事件(Forgetting Events)如何用于主动学习?
遗忘事件指样本在训练过程中预测标签从正确变为错误或反之的转变。研究发现,可遗忘样本(经常被遗忘)往往包含噪声标签或难以分类的特征,而不可遗忘样本可以安全移除。在主动学习中,可以用标签分散度(label dispersion)作为无标签样本的遗忘信号,分散度高表示模型预测不稳定,不确定性高。
