

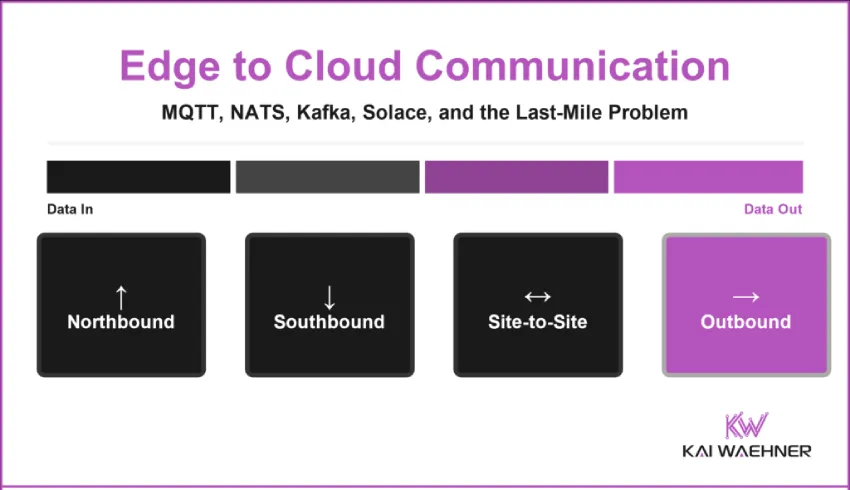

MQTT、Kafka、NATS 还是 Zenoh?按流量模式选择边云消息技术
内容提要
边缘到云集成包含四种流量模式:北向遥测、南向控制、站点间同步和面向人的出站投递,各有不同约束。网络不可靠、禁止入站连接、硬件异构等条件决定架构须离线优先、由边缘主动拨出。MQTT平台覆盖遥测与控制,Kafka类事件流负责站点间复制,NATS、Zenoh等消息网格统一多模式,Lightstreamer等平台解决最后一公里投递。选型应先回答五个问题:消费者是谁、是否真需实时、最受限节点、站点规模、数据驻留要求。
延伸解读
网络约束先于产品选型
文章强调,边云之间的网络是唯一无法重构的组件,其特性在评估任何产品前就已决定架构。连接不可靠要求离线优先和存储转发;禁止入站连接迫使边缘主动拨出;硬件异构要求资源占用与层级匹配。因此,选型应先确认这些约束,而非比较厂商功能列表。
四种流量模式对应不同技术品类
北向遥测和南向控制主要由 MQTT 平台覆盖,因其双向设计;站点间同步适合 Kafka 类事件流或 NATS 叶节点;面向人的出站投递则需要 Lightstreamer 等最后一公里平台。消息网格和协议代理可横跨多个模式,但覆盖越广,锁定风险越高。
实时需求需要先测量再设计
文章提醒,团队常宣称业务需要实时,但相当一部分边缘流量用周期性批处理即可满足。若 15 分钟批处理够用,文件同步或变更数据捕获更经济。流式架构应留给真正需要新鲜数据的场景,否则会为批处理问题支付流式成本。
五个问题缩小候选范围
选型前应回答:消费者是机器还是人、是否真需实时、最受限节点是什么、站点规模能否支撑每站集群、数据必须存放在哪里。这些答案基本能确定技术方向。此外,边缘必须主动拨出,本地运行需在离线时存活,缓冲区应刻意定容。
Q&A
边到云通信具体包含哪几种流量模式?
边到云通信包含四种流量模式:北向遥测(从边缘向中央平台发送传感器数据、日志等)、南向控制(从中央平台向边缘下发命令、配置、更新)、站点间同步(在站点之间或站点与核心数据中心之间同步数据)、面向人的出站投递(将实时数据推送到看板、移动App等)。
为什么边云架构必须采用离线优先和边缘主动拨出的设计?
因为边云之间的网络连接不可靠(可能离线数小时甚至数天),且工业现场、零售网络等通常禁止入站连接(处于NAT、防火墙之后)。因此架构必须离线优先:本地继续运行、缓冲数据,链路恢复后续传;同时由边缘主动向云端拨出连接,如MQTT客户端向Broker拨出、NATS叶节点向Hub集群拨出。
MQTT、Kafka、NATS、Zenoh分别适合哪种边云流量模式?
MQTT平台(如EMQX、HiveMQ)同时服务北向遥测和南向控制;Kafka类事件流适合站点间复制(尤其适合能自运营集群的大站点);NATS和Zenoh作为消息网格,用一套网格承载北向、南向和站点间流量,适合成千上万小站点的Hub-and-Spoke模式;Zenoh还用于汽车和机器人项目。
选择边云消息技术时应该先回答哪五个问题?
五个问题:1) 数据由谁消费,机器还是人?2) 这条流真的需要实时吗?3) 路径上最受限的节点是什么?4) 有多少站点,每个站点能运营一套集群吗?5) 数据必须存放在哪里?回答后候选清单基本确定。
对于成千上万个小站点,为什么NATS比Kafka更合适?
Kafka式复制适合规模大到能自运营流集群的站点,但成千上万小站点若每站点一套流集群,运维重量会压垮模型。NATS服务器是一个无外部依赖的小二进制文件,每个站点运行叶节点向中央集群拨出,WAN断掉时继续服务本地应用,恢复后异步镜像同步,更适合小站点的Hub-and-Spoke模式。
面向人的出站投递为什么需要专门的最后一公里平台?
因为人和机器消费数据的方式不同:人需要在连接时立即获得当前状态,然后接收实时更新,而日志不是用户界面。最后一公里平台(如Lightstreamer、Ably、PubNub)处理扇出、按客户端限流和权限校验,解决中央平台与大量并发浏览器、移动App之间的投递问题,这是大多数边缘架构容易忽略的第四种流量模式。
