


利用节点交换分区扩展 Kubernetes 工作负载
内容提要
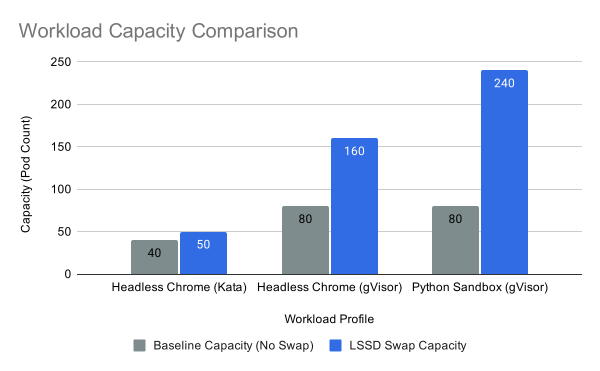
Kubernetes v1.34 起正式支持节点交换分区。使用 NVMe SSD 作为交换设备,可将闲置内存换出,显著提升 Pod 密度。测试表明:内核编译内存限制降低 50% 无性能损失;Python 沙箱并发从 80 增至 240,密度提升 3 倍,延迟主要源于 CPU 竞争而非交换 I/O。建议配置 LimitedSwap 并采用 Burstable QoS。
延伸解读
从禁用交换到正式支持:关键变化
Kubernetes 过去不鼓励启用交换,主要因为 cgroup v1 将内存与交换合并计算,导致容器真实内存用量难以预测和隔离。v1.34 起节点交换正式可用,依赖 cgroup v2 独立追踪交换用量,同时 NVMe 本地 SSD 大幅降低换页延迟。这两点共同使交换从风险项变为可用的密度调节手段。
交换是突发缓冲,不是活跃内存的替代
内核编译测试显示,将容器内存限制从 600 MB 降至 300 MB 并启用本地 SSD 交换后,执行时间未变慢甚至略快;但进一步压到 200 MB 时,活跃工作集被换出,I/O 等待导致执行时间增加超过 40%。这说明交换适合吸收闲置和突发内存,不能替代活跃内存,配置时需保留足够物理内存给工作集。
密度提升的延迟来源:CPU 竞争而非交换 I/O
Python 沙箱并发从 80 提升到 240,密度提高 3 倍;浏览器沙箱等高密度场景下,每 Pod 延迟增加主要来自 Pod 之间争抢 CPU,而非交换 I/O。若对延迟有明确目标,应运行在低于峰值密度的水平,延迟代价会相应减小。调优时应同时关注 CPU 配额与交换配置。
落地配置要点:LimitedSwap 与 Burstable QoS
启用节点交换需在 kubelet 配置中设置 failSwapOn: false 和 memorySwap.swapBehavior: LimitedSwap,并搭配云厂商的高速本地盘。工作负载应使用 Burstable QoS,即内存 limit 高于 request,让节点根据闲置内存自动分配快速交换空间,同时保持活跃进程响应。
Q&A
Kubernetes 从哪个版本开始正式支持节点交换分区?
Kubernetes v1.34 起正式支持节点交换分区(GA)。
为什么以前 Kubernetes 不推荐使用交换分区?
历史上交换分区被劝阻有两个原因:一是 cgroup v1 下内存和交换分区被合并限制,无法独立跟踪,导致容器实际内存使用不可预测;二是交换到慢速旋转磁盘的延迟惩罚。
使用 NVMe SSD 作为交换设备对 Pod 密度有什么提升?
测试表明,使用 NVMe SSD 交换可将 Python 沙箱并发从 80 个提升到 240 个,密度提升 3 倍;内核编译内存限制降低 50% 无性能损失。
如何配置 Kubernetes 以启用节点交换分区?
在 kubelet 配置中设置 failSwapOn: false 和 memorySwap.swapBehavior: LimitedSwap,并搭配云提供商的高速本地磁盘(如 GKE 的 Local SSD)。
启用交换分区后,为什么延迟增加主要来自 CPU 竞争而非交换 I/O?
在高密度下,Pod 之间竞争 CPU 资源导致延迟上升,而交换 I/O 由于使用快速 NVMe SSD,其影响相对较小。
对于 AI 代理工作负载,节点交换分区有什么好处?
AI 代理工作负载启动时需要大内存,之后长时间空闲。交换分区可将空闲内存换出,释放物理 RAM,从而在相同基础设施上提高 Pod 密度和节点利用率,同时保持安全隔离。
