

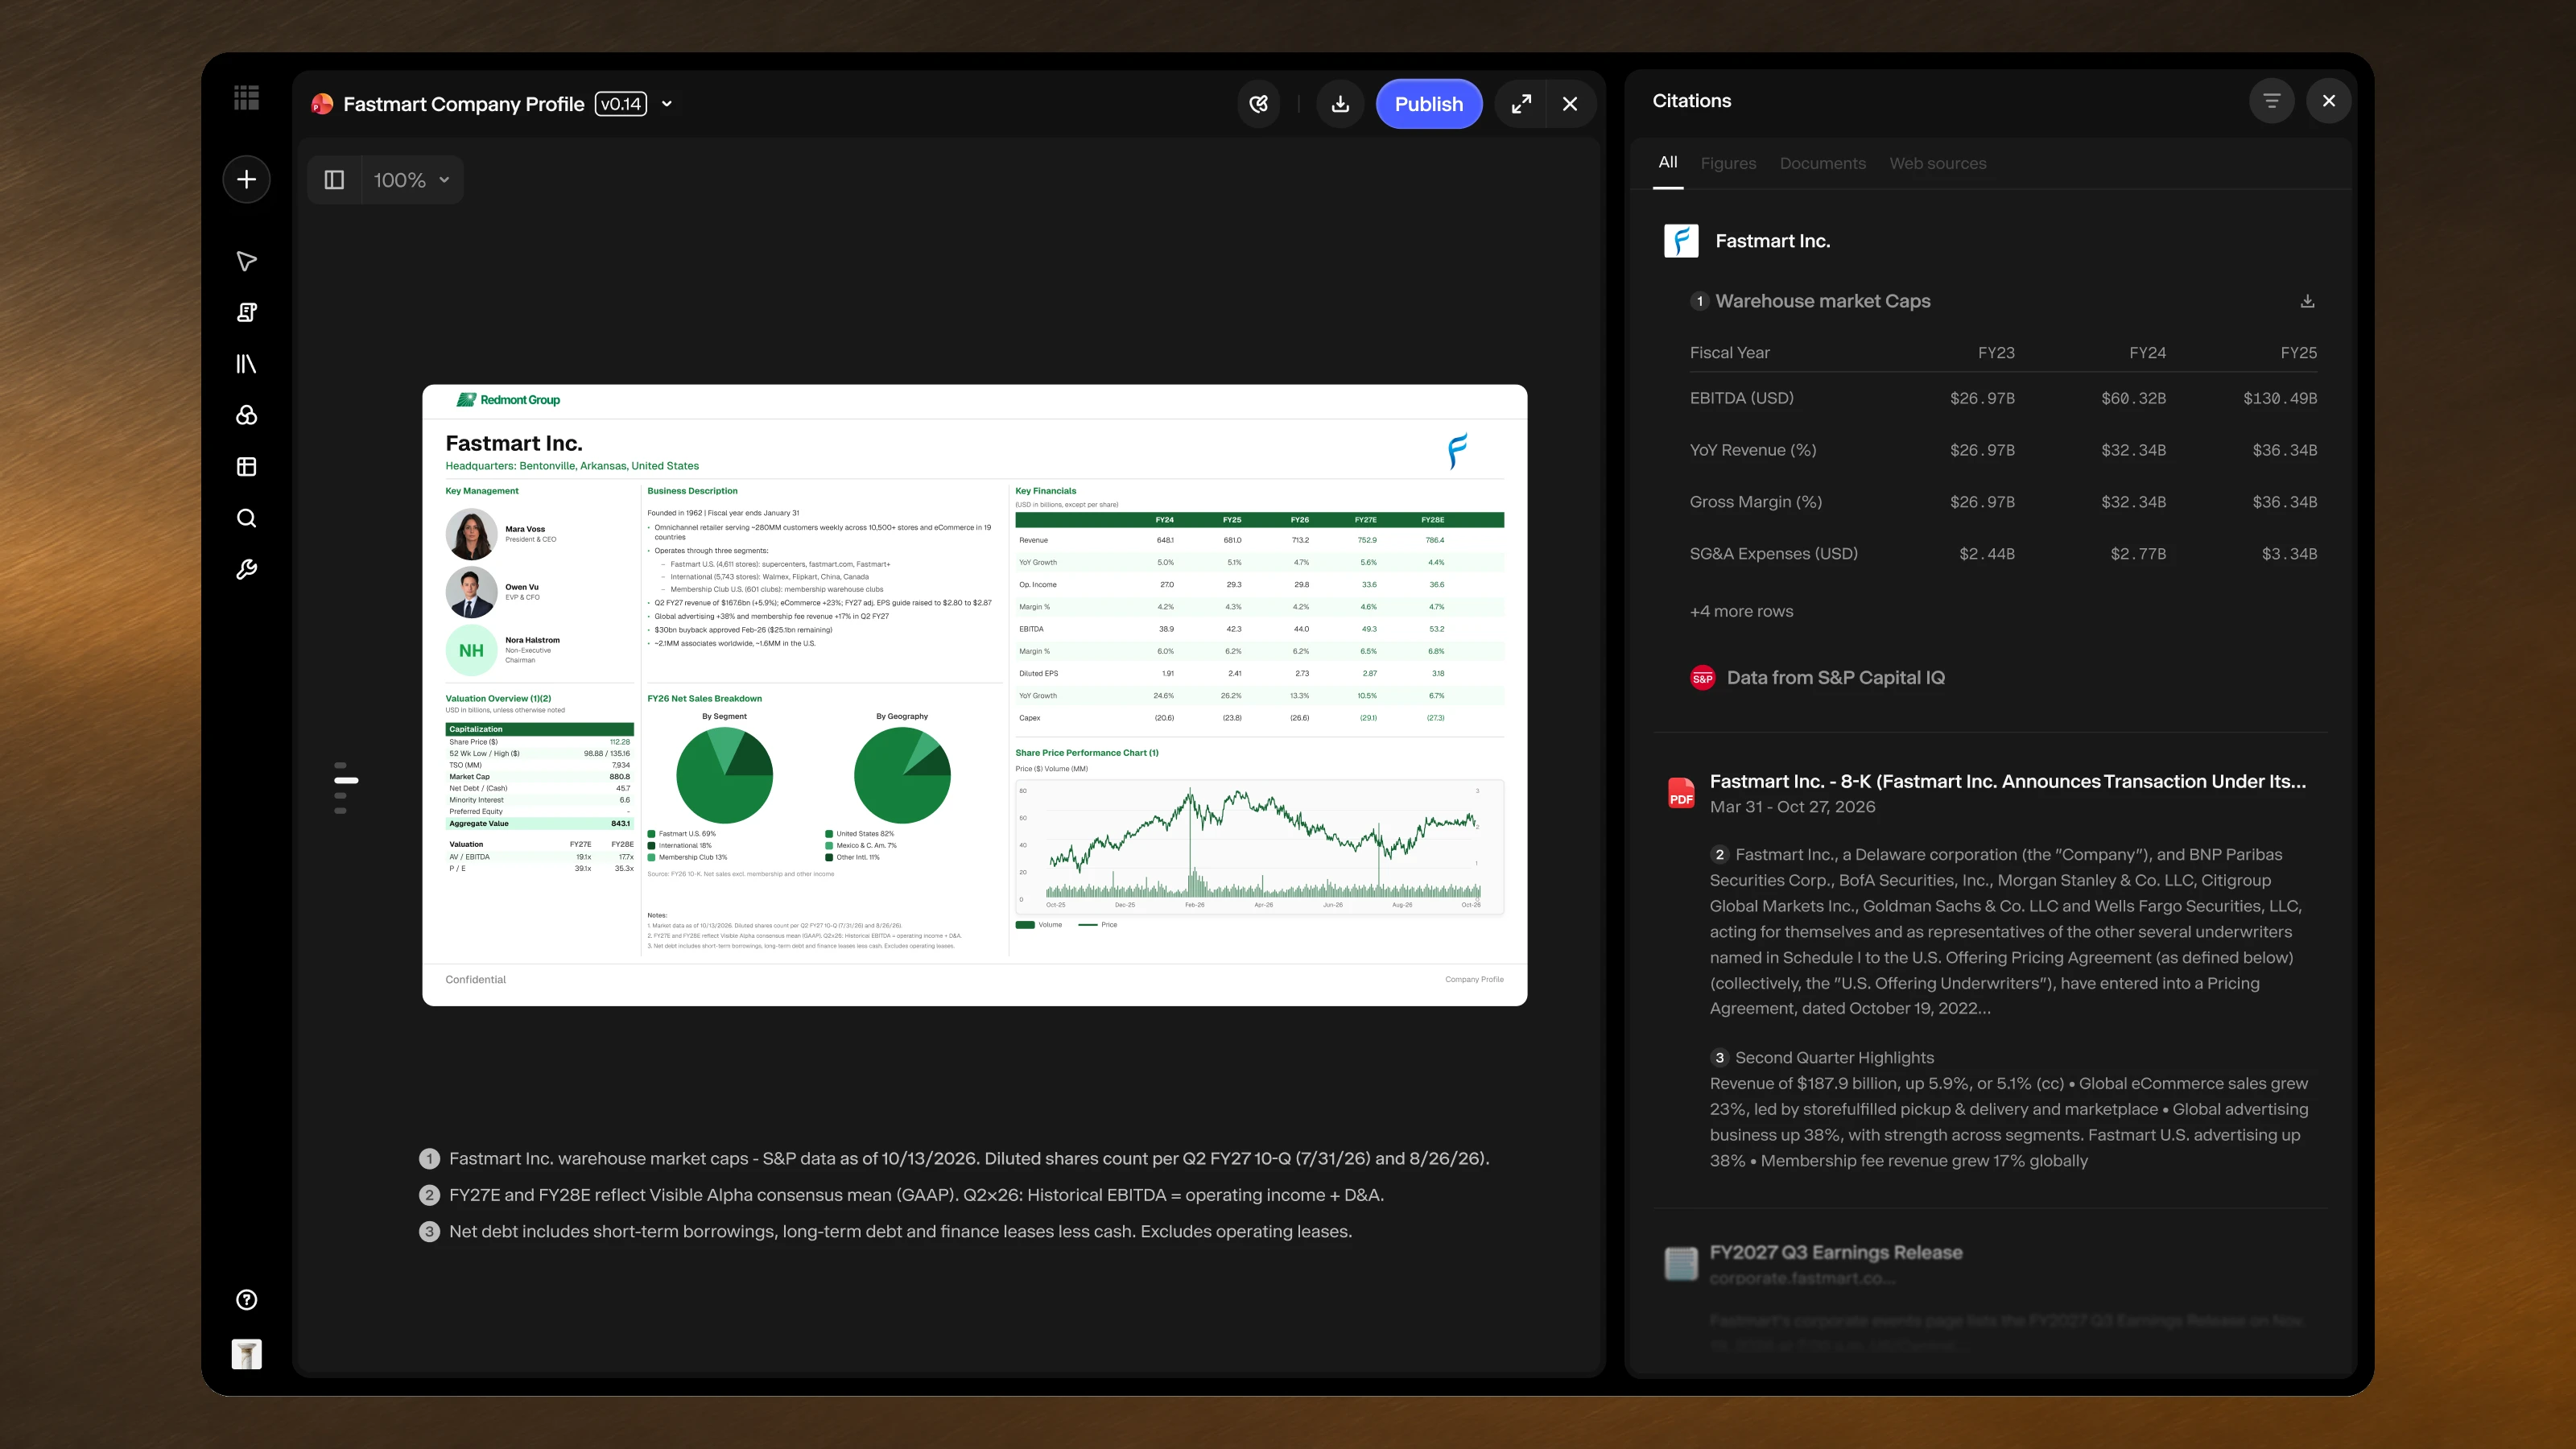

Hebbia借助GPT-6 Astra在金融研究领域取得进展
内容提要
Hebbia测试了OpenAI预发布模型GPT-6 Astra,用于金融研究中的来源检索与演示文稿制作。结果显示,该模型在引用所需来源类型上比最佳替代模型高13.6个百分点,99.5%的引用摘录与问题相关;演示文稿需求满足率达97.9%,领先14.4个百分点,并在遵循指令和制作质量两方面均居首。Hebbia认为这能减少银行家核对来源和重做幻灯片的时间,未来智能体还可后台监测信息、提前发现信号。
延伸解读
测试方法与基准的局限
Hebbia的测试使用预发布版GPT-6 Astra,在2026年8-9月进行,采用相同的金融研究案例和评分标准,并由领域专家编写或审核标准。但文章未披露测试案例数量、具体评分细则及替代模型名单,因此13.6和14.4个百分点的领先幅度应理解为特定测试条件下的结果,不宜直接外推为所有金融研究场景的普遍表现。
引用可追溯性的实际价值
文章强调用户基于AI输出做出数百万美元决策,因此引用可追溯性至关重要。Hebbia的Matrix允许用户打开引用查看底层文档和高亮段落,幻灯片脚注也链接回源材料。这意味着AI的价值不仅在于生成答案,更在于让银行家能快速核对客户集中度等关键数据,减少人工翻查数千份文件的时间,但最终仍需人工复核报告期等细节。
演示文稿质量的双重考验
银行家不希望收到“看起来像AI做的”幻灯片,而要求符合公司品牌且像人做的。测试中GPT-6 Astra在遵循简报和演示质量两方面均居首,满足97.9%的适用要求。其他模型往往在精致度与指令遵循之间取舍,而该模型首次同时领先。这提示评估金融AI时,不能只看内容准确性,还需考察格式合规与品牌一致性。
智能体的未来角色与边界
Hebbia设想未来智能体可在后台监测信息并提前发现信号,帮助金融专业人士比竞争对手早几小时开始思考。但文章仅将其描述为未来方向,未提供实际部署或效果数据。当前可验证的进展仍集中在来源检索和演示文稿制作两个环节,智能体的主动监测能力尚待进一步验证,读者应区分已测试成果与愿景。
Q&A
Hebbia测试GPT-6 Astra的主要目的是什么?
Hebbia测试OpenAI预发布模型GPT-6 Astra,旨在改进金融研究中的两个环节:查找问题所需的来源文档,以及根据银行家的简报制作演示文稿。
GPT-6 Astra在引用来源方面的表现如何?
在Hebbia的测试中,GPT-6 Astra在引用所需来源类型上比最佳替代模型高13.6个百分点,且99.5%的引用摘录与问题相关。
GPT-6 Astra在制作演示文稿方面有哪些优势?
它满足了97.9%的适用演示文稿需求,领先最佳替代模型14.4个百分点,并且在遵循指令和制作质量两方面均排名第一。
Hebbia的Matrix如何帮助银行家处理大量文档?
Matrix可以将数据室中的数千份文档整合起来,让银行家检查客户集中度、合同条款和流失率等,并链接答案到背后的文档,还能引入同行文件与行业新闻辅助分析。
为什么引用和可追溯性对金融用户很重要?
因为用户基于AI的输出做出数百万美元的决策,引用能提供可追溯性,并让用户确信AI找到了正确答案。
Hebbia认为GPT-6 Astra能如何节省金融专业人士的时间?
它能生成更接近最终输出的演示文稿,减少重新格式化幻灯片和核对来源的时间,将通宵工作缩减为几分钟的审查。
Hebbia对未来智能体在金融领域的角色有何设想?
Kavita设想智能体可以在后台监测信息,为金融专业人士提前发现信号,从而比竞争对手更早开始思考和处理机会。
