

Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
内容提要
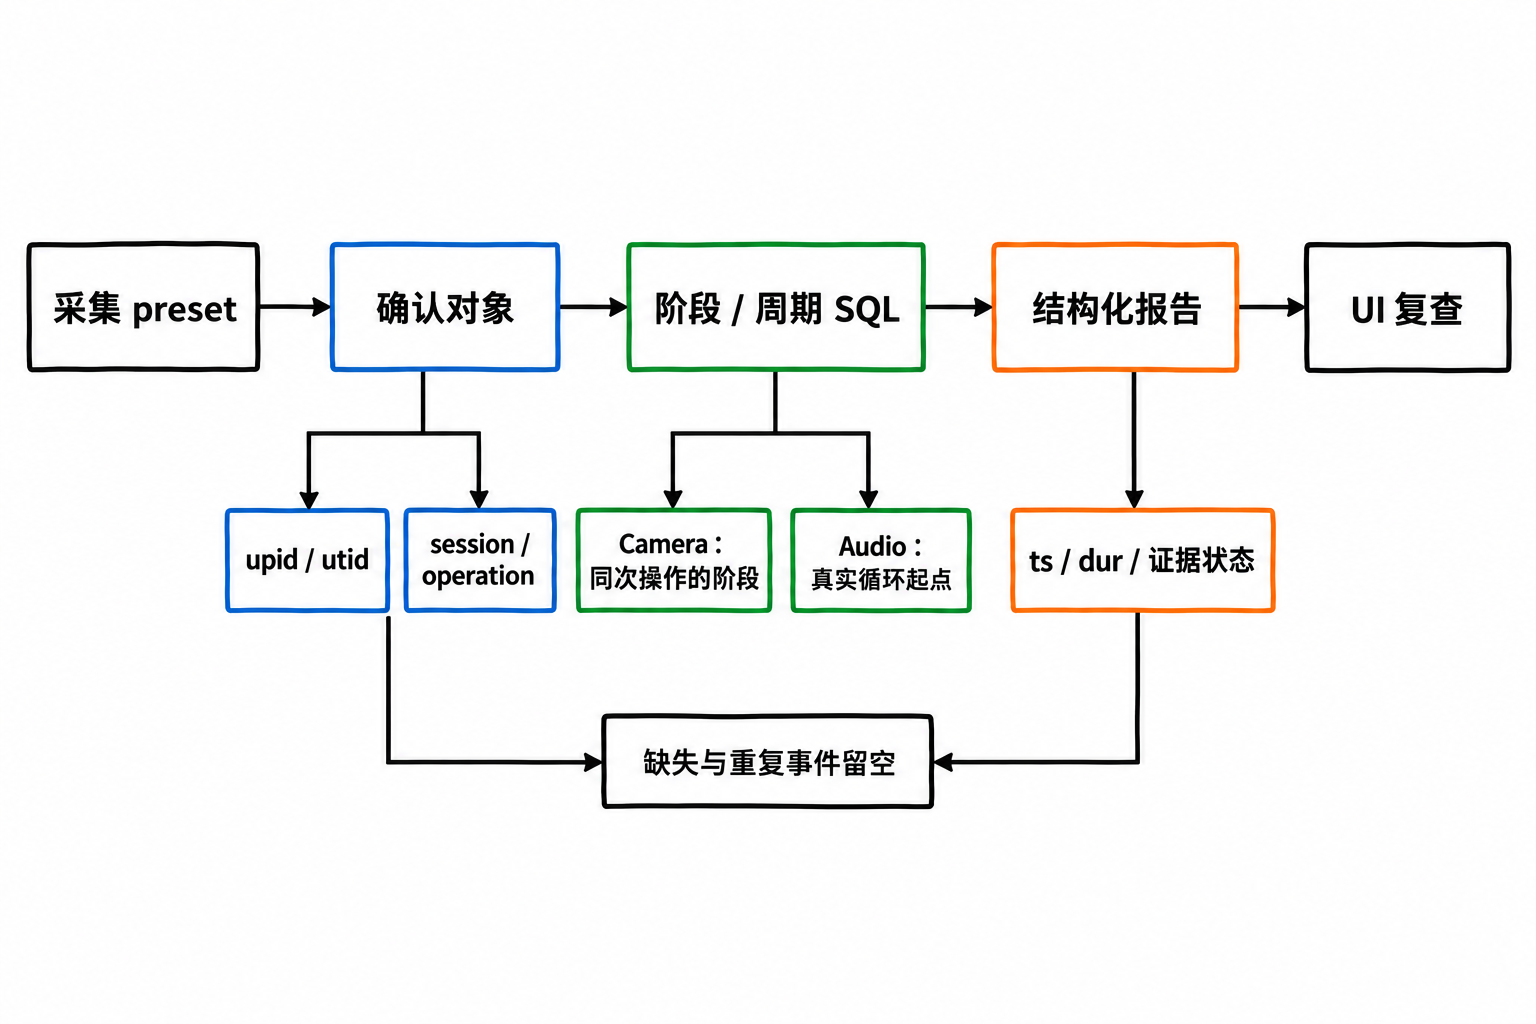
本文介绍用Perfetto进行Camera/Audio专项分析的方法:先建立对象字典与领域schema,确认进程、线程、track等对象;再按阶段(open、configure、首帧)和周期(Mixer循环、underrun)编写SQL计算耗时与阻塞;报告需保留可回UI复查的时间点,并区分Running与Runnable。核心是固定preset、稳定埋点、证据分级,使分析可复用、可复查。
延伸解读
对象字典:自动化分析的前置条件
文章强调,Camera/Audio 专项分析的第一步是生成对象字典,明确相关进程、线程、track、slice 名称、log tag 和 request/session id。脚本先列出候选对象,再由领域负责人确认,并写回 domain_objects 表或 YAML/JSON。后续 SQL 只使用 owner_confirmed=1 的对象,避免因 vendor HAL、provider、codec 等名称漂移导致自动化退回模糊匹配。这要求团队在流程中明确人工确认环节,不能仅靠 LIKE 查询。
阶段与周期:两种不同的分析口径
Camera 问题需按阶段拆分,如 open、configure、first HAL buffer、first presented frame,并区分 API 返回、HAL buffer 返回和用户可见首帧三种口径。Audio 问题则强调周期性,关注 mixer 循环间隔、连续异常是否与 underrun log 或听感时间点重合,而非单个长 slice。文章指出,Audio 周期阈值不能跨设备固定,应基于同一设备同一 route 的干净播放建立基线,再比较异常现场。
证据分级与报告可复查性
报告应包含数据质量、对象字典、阶段指标和可跳回 Perfetto UI 的复查点。结论需分级:确认、倾向、排除、降级,并明确所需字段,如 required_signals_available、data_quality、ui_review_points。文章强调,只有“倾向”证据不能写成“确认”,数据缺失时应降级并说明原因。这能避免工程争议,确保每个结论都能回到同一 preset、SQL 和证据等级。
平台体系:preset、trigger 与权限边界
平台侧需将 TraceConfig 版本化管理,按 field、lab、deep 三层区分使用场景和采集方。field 层用于 user build 线上问题,低开销、短窗口;deep 层用于 userdebug/root 专项排查,禁止用于线上。普通 App 不能开启系统级 ftrace、process stats 或 FrameTimeline,只能写 marker 或发已登记 trigger。线上采集需授权、脱敏、保留周期和审计,并明确 preset 负责人、版本、质量门禁等字段。
Q&A
Perfetto 做 Camera/Audio 专项分析时,为什么要先建立对象字典?
因为 Camera 和 Audio 的难点在于 Trace 里存在哪些对象,如 App client、cameraserver、provider、HAL、request/session id 等,这些对象可能分散在不同进程。对象字典能明确相关进程、线程、track、slice 名称、log tag 和 request/session id,后续 SQL 只围绕字典计算阶段耗时和阻塞证据,避免靠关键词猜测根因。
Camera open 慢应该拆成哪些阶段来分析?
至少拆成:App 发起 open、App 到 cameraserver、cameraserver 到 provider/HAL、configure streams、first HAL buffer、first presented frame、capture/result。报告要写清量的是 API 返回、第一帧从 HAL 返回,还是第一帧被用户看到,因为三者口径不同。
Audio underrun 分析为什么要关注周期而不是 Top slice?
Audio 问题更强调周期性,一次长 slice 不一定导致听感问题,连续几个 mixer 周期抖动、App 写入间隔不稳或 HAL 写入阻塞才更接近 underrun。报告应优先看周期尾部是否变长、连续异常是否出现,以及是否和 underrun log、route change 或听感时间点重合,Top slice 只作为辅助线索。
在专项分析中,Running 和 Runnable 为什么要分开统计?
Running 表示线程实际在 CPU 上运行,Runnable 表示线程已就绪但等待 CPU。两者混在一起会掩盖问题:Runnable 高通常指向 CPU 竞争、优先级、频率或唤醒源问题;Running 高则可能需进一步做 CPU profiling 或函数级热点分析。统计对象应来自 domain_objects 中 owner_confirmed=1 的线程。
自动化分析报告为什么必须保留能跳回 Perfetto UI 的时间点?
因为只有结论没有时间点,别人无法复查。报告中的每个异常都应能跳回 Perfetto UI,指向可复查的时间段,例如 provider configure 花了 98ms、对应 request id 是 17、同一时间 Binder 线程 Runnable 41ms 且无 data loss。脚本负责整理上下文,最终结论仍需能被 UI 和源码路径复核。
平台侧要把 Perfetto 用稳,需要固定哪四件事?
平台侧需要固定:preset、trigger、证据包格式、自动分析入口。TraceConfig 应像接口一样版本化管理,放在仓库里评审、测试、发布;trigger 名称要收敛且不可随意更改;证据包格式要统一;自动分析入口要能按 preset、SQL 和证据等级输出结论。
为什么 deep preset 不能放到线上使用?
deep preset 包含 CPU profiling、native heap profiling、GPU counters 等高开销能力,在实验室和专项排查中有价值,但在 user build 的长期现场采集中成本太高,隐私和稳定性风险也更高。field 层应禁止 linux.perf、heapprofd、GPU counters、syscall/pagefault 高频事件。
Camera/Audio 自动化分析中,如何避免事件名漂移导致 SQL 失效?
需要在可控代码里补稳定事件,如 Camera#OpenStart、Camera#OpenEnd、Audio#TrackStart、Audio#Underrun 等,事件名要稳定,不能把动态 id 拼进事件名。动态信息放参数、counter 或 metadata。平台字典和 domain schema 分两层,靠映射表对应,SQL 和报告只认 schema 名,埋点实现改名时只更新映射。
