

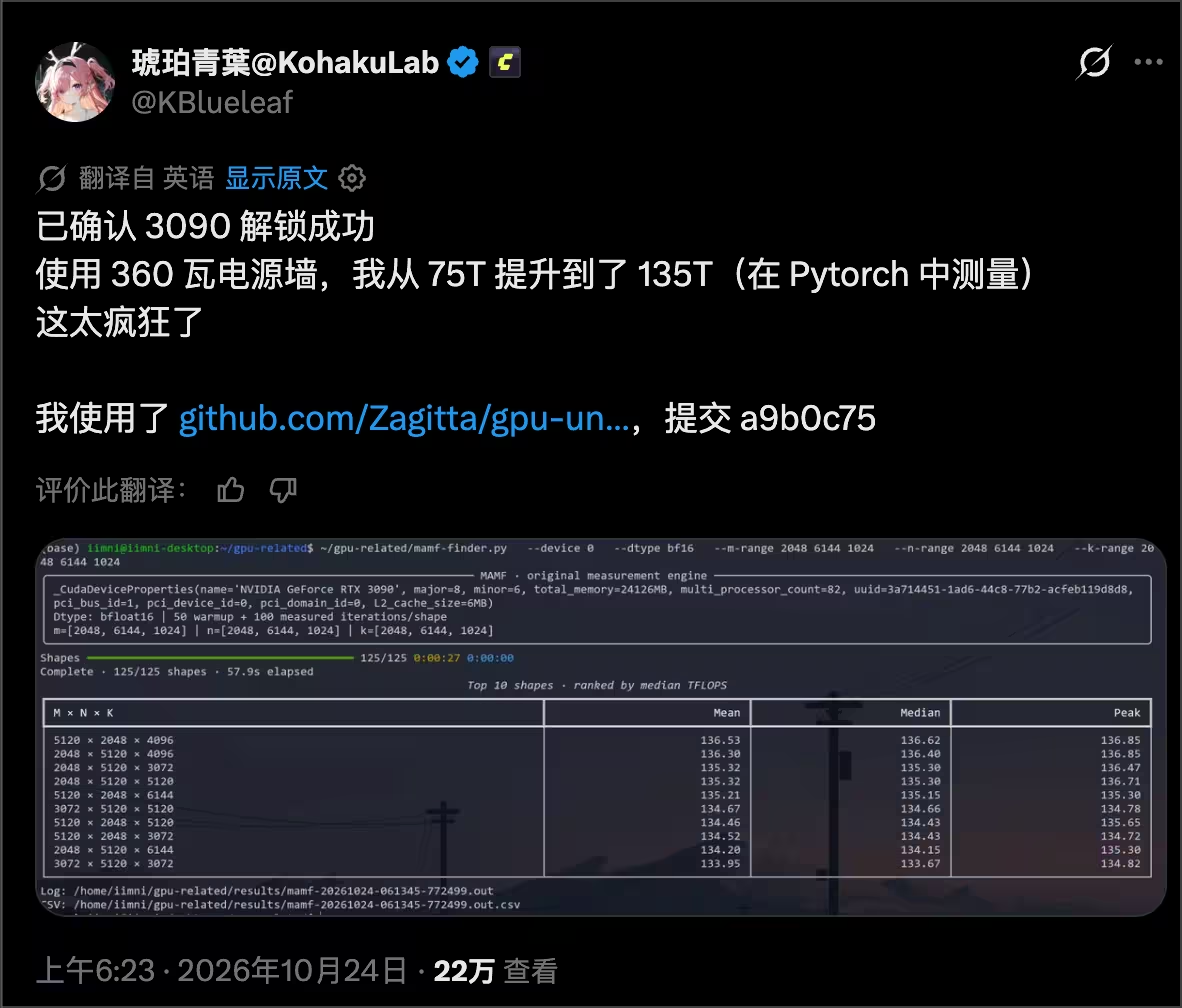

英伟达显卡的 AI 算力被人为限制了?有人成功解锁,性能接近翻倍
内容提要
开发者发现英伟达RTX 30系列(GA102/GA104核心,如3090、3080、3070)部分Tensor Core矩阵运算存在速度限制,并已推出Linux和Windows开源解锁工具。解锁并非超频,而是解除计算路径吞吐限制,实测AI矩阵计算性能提升60%至近100%,如RTX 3090从75升至135 TFLOPS。本地大模型推理提升有限,llama.cpp量化模型几乎无变化。Windows解锁较复杂,项目尚新,存在兼容性风险,不建议主力机尝试,英伟达未作解释。
延伸解读
解锁提升的是矩阵算力,而非游戏性能
文章明确指出,解锁并非超频,不会提升游戏帧率,而是解除Tensor Core特定矩阵运算路径的吞吐限制。实测提升集中在BF16、TF32等AI计算格式,如RTX 3090从75 TFLOPS升至135 TFLOPS。这意味着收益仅体现在使用这些计算方式的模型和推理引擎上,普通游戏玩家和未调用受限路径的应用不受影响。
本地大模型推理收益有限,需看引擎实现
尽管矩阵算力提升显著,但实际大模型推理速度并未同步翻倍。测试显示,Strata引擎的提示词处理提升16%、首token等待缩短14%,而生成速度基本不变;llama.cpp量化模型解锁前后几乎无区别。这说明推理性能还受内存带宽、量化方式、引擎调度等因素制约,用户不应期待通用的大模型加速效果。
Windows解锁复杂且风险较高,暂不建议主力机尝试
Linux版已有较多成功案例,包括虚拟化环境;Windows版则需通过UEFI启动程序在驱动加载前操作,目前仅在有限硬件上验证,并非双击即用。两个项目均很新,涉及显卡底层配置修改,存在兼容性和稳定性风险。文章明确建议暂时不要在主力电脑上直接尝试,适合有折腾经验的用户在小范围测试。
限制原因未明,硬件损坏风险被认为较低
英伟达尚未对为何设置这些限制给出官方解释。开发者KBlueleaf认为,由于显卡原本就能通过其他计算方式达到类似速度,解锁造成硬件损坏的风险应该很低。但这一判断基于个别开发者观点,并非官方保证。用户在尝试前仍需自行评估风险,并关注项目后续的兼容性反馈。
Q&A
哪些英伟达显卡的AI算力被限制了?
主要是采用Ampere架构、GA102和GA104核心的RTX 30系列显卡,包括RTX 3090、3080、3070等型号。
解锁后AI矩阵计算性能能提升多少?
根据实测,不同显卡提升幅度在60%到近100%之间。例如RTX 3090从75 TFLOPS提升到135 TFLOPS,提升80%;RTX 3090 Ti的BF16提升80%,TF32提升94%;RTX 3080 Ti的BF16提升67%,TF32提升73%。
解锁算力限制是超频吗?会提升游戏帧率吗?
不是超频。解锁是解除部分计算路径的吞吐限制,并非增加计算单元或提高频率。它不会提升游戏帧率,但能在特定AI矩阵计算中提升性能。
解锁后运行本地大模型推理速度能快一倍吗?
不一定。实测显示,使用RTX 3090运行Strata引擎时,16K提示词处理速度提升16%,首个token等待时间缩短约14%,但生成速度基本不变。而使用llama.cpp量化模型时,解锁前后几乎没有区别。
Windows系统现在可以解锁吗?操作复杂吗?
可以,但目前比较复杂。Windows版本通过UEFI启动程序在NVIDIA驱动加载前完成解锁,且只在有限硬件配置上验证过,并非下载后双击即可使用。
解锁工具有风险吗?是否建议在主力机上尝试?
两个项目都很新,涉及显卡底层操作,存在兼容性和稳定性风险。目前不建议在主力电脑上直接尝试。不过有开发者认为,由于显卡原本就能通过其他方式达到类似速度,硬件损坏的风险应该很低。
