


为什么全世界的 AI 都画不好一只骑自行车的鹈鹕
内容提要
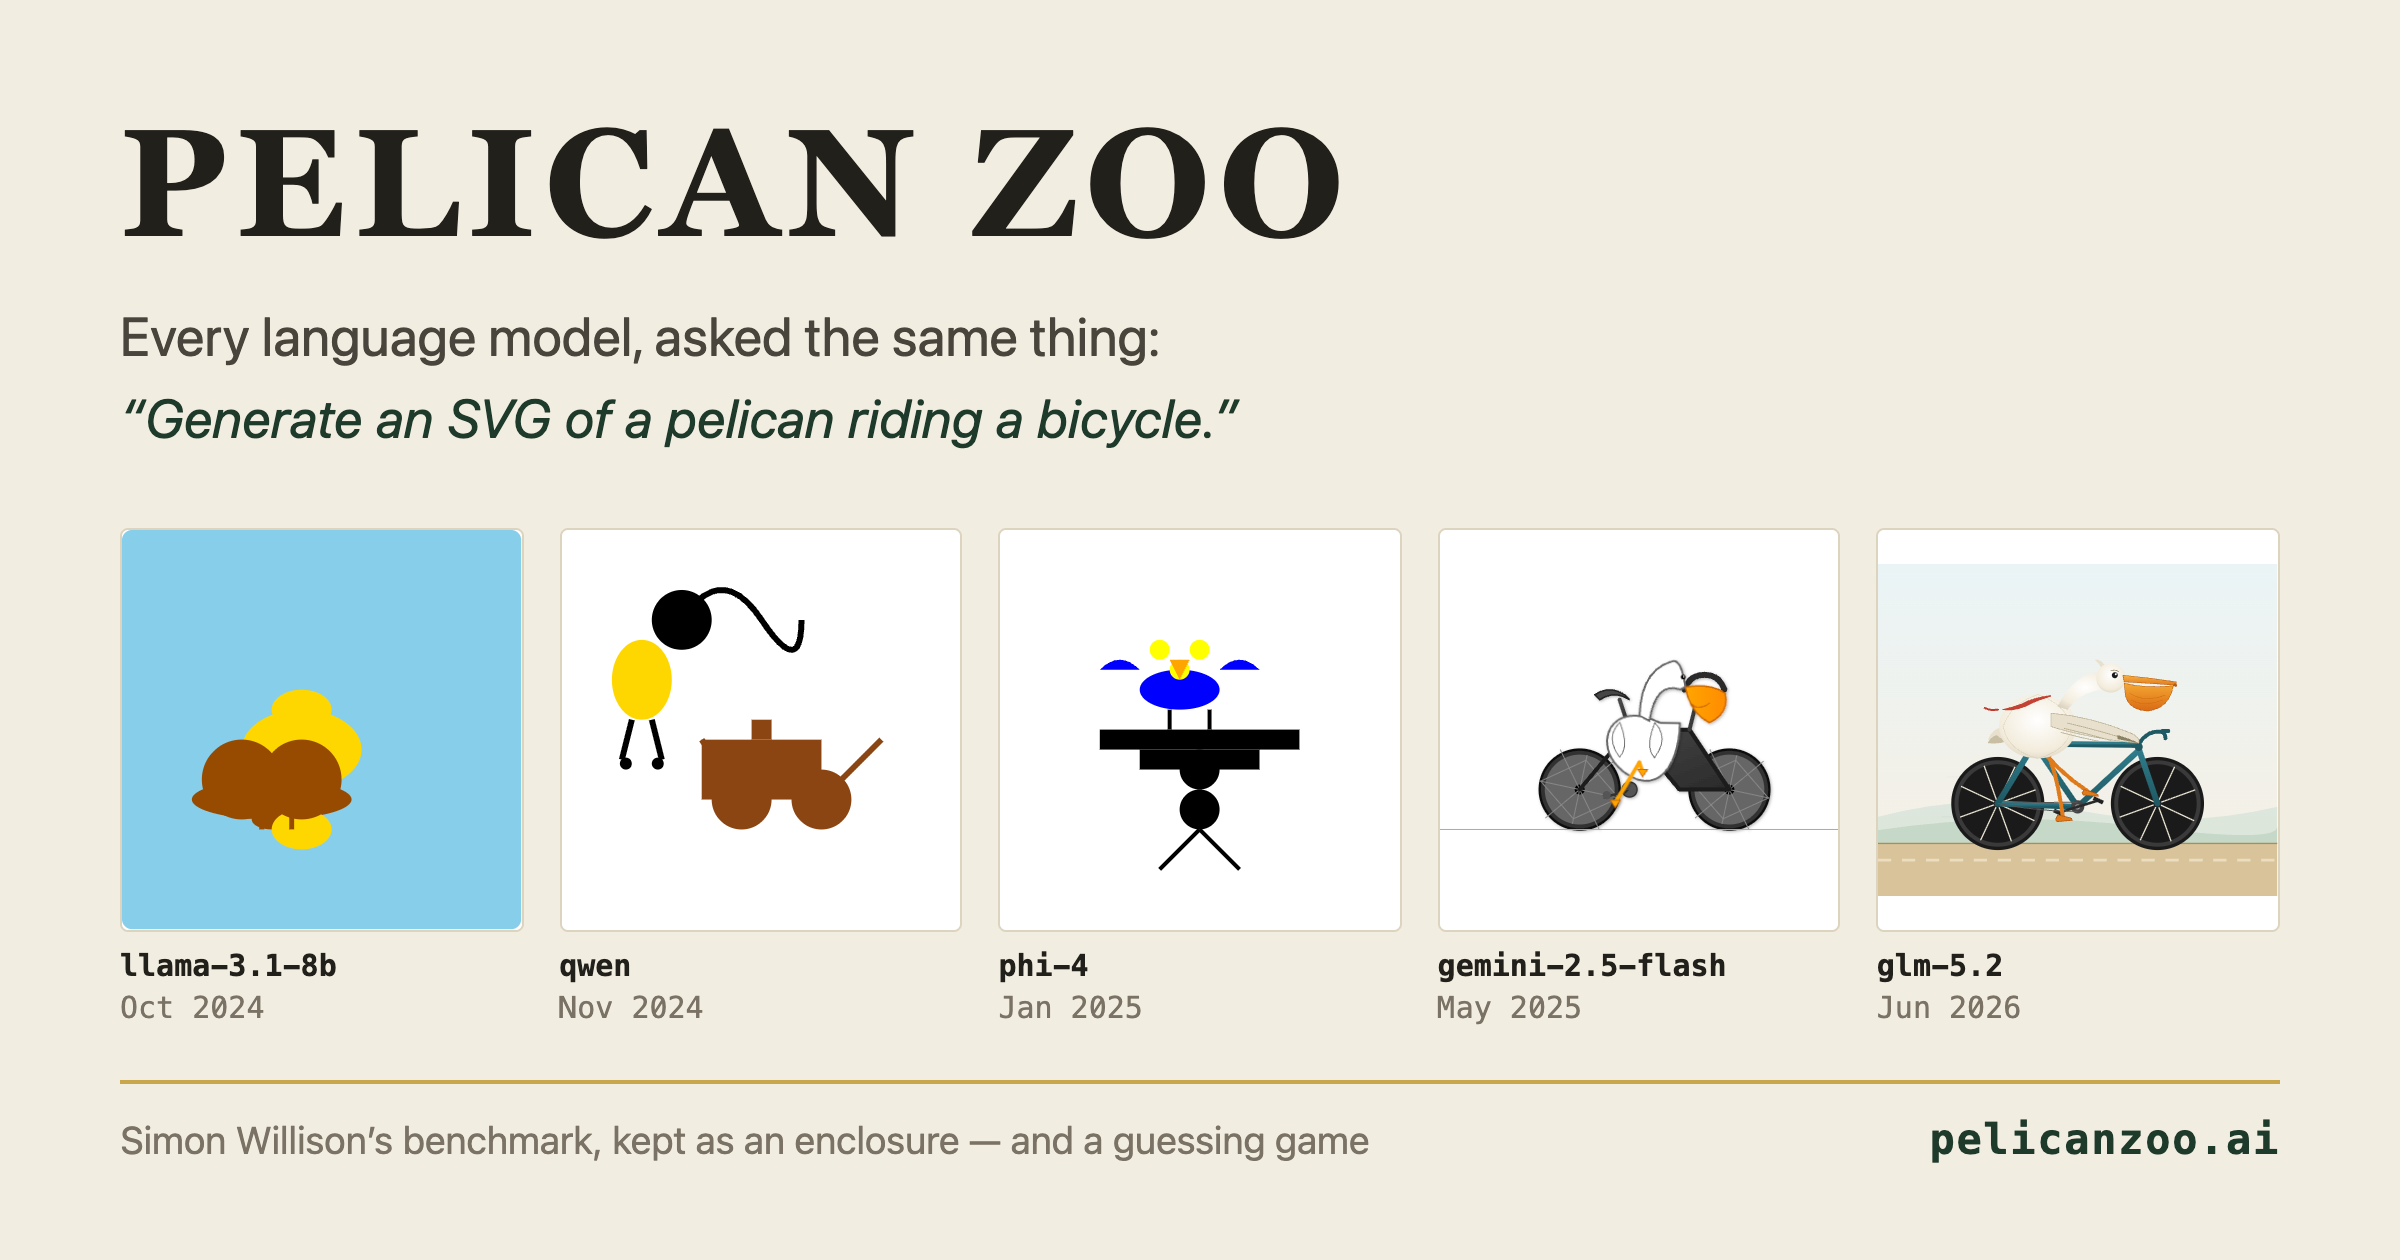
程序员Simon Willison自2024年起用“生成骑自行车的鹈鹕SVG”测试大模型,因该题无先例且考验代码绘图能力。两年间他收集66个模型的103只鹈鹕,建站pelicanzoo.ai展示,含猜模型、投喂、AI点评等玩法。测试初期与模型实力相关,后逐渐脱节,作者强调它已非有效评测,更多是一种观察模型行为的仪式。
延伸解读
从玩笑到仪式:鹈鹕测试的演变
Simon Willison 最初用“画骑自行车的鹈鹕”来调侃模型评测的荒谬,但头一年结果意外与模型代码能力相关。随着模型进步,相关性逐渐消失,测试已无法区分模型强弱。作者强调它不再是有效评测,而更像一种观察模型行为的仪式,提醒读者不要用它来比较模型。
成本与推理:鹈鹕背后的账单
文章披露了不同模型生成鹈鹕的成本差异:o1-pro 花费 88.755 美分,Gemini 2.5 Pro 仅 4.77 美分且效果更好;Claude Fable 5.1 最高档耗时近 14 分钟、输出 65927 token、花费 3.3 美元。这些数据说明,生成质量与成本、推理档位并不简单成正比,读者可借此观察模型的工作方式。
模型行为观察:注释、帽子与系统提示
SVG 注释让模型“说出”意图,如 Gemini 3 在注释里写“帽子(可选趣味细节)”,Qwen 小模型则用红字宣称“这是艺术,鹈鹕不骑车!”。Simon 还发现八个单词的提示被算成 95 个输入 token,暗示系统提示的存在。这些细节比画作本身更能揭示模型的“脾气”和隐藏行为。
pelicanzoo.ai:鹈鹕动物园的玩法与意义
作者将散落在 Simon 几十篇文章中的 103 只鹈鹕集中展示,来自 66 个模型、12 家厂商。站点提供猜模型、投喂、AI 点评和徽章等互动,所有图片和评注均链回 Simon 原帖。它不仅是趣味合集,也为观察模型输出差异提供了可检索的样本库,但需注意其非官方、非评测性质。
Q&A
为什么用“画一只骑自行车的鹈鹕”来测试大模型?
因为互联网上几乎没有鹈鹕骑自行车的 SVG,模型不可能在训练数据里见过;同时大语言模型本身不会画画,但会写代码,而 SVG 恰好是代码,这能考验模型凭坐标和半径拼出形状的能力。此外,鹈鹕和自行车都很难画,鹈鹕根本骑不了自行车,题目本身就不讲理。
2024 年大模型画的鹈鹕有多差?
早期画作非常抽象:Claude 3.5 Sonnet 交出来两个圆中间连一个三角形,喙像黄色香蕉笑脸;Llama 3.3 70B 画了小圆圈、竖线和像水槽的东西;Qwen2.5-Coder 的自行车像拖拉机;Mistral Small 3 画了矮胖白鸭子蹲在杠铃上。
Simon 如何用 AI 给 34 张鹈鹕排名?
他让 Claude 写了个小工具,把任意两张鹈鹕并排截图,34 张图两两配对共 560 场对决,每场交给 GPT-4.1 mini 当裁判选出更好的并说明理由,最后用 Elo 积分算排名。整个裁判过程花了约 18 美分。
为什么说鹈鹕测试已经不是一个好的模型评测?
因为画鹈鹕的好坏和模型真实能力逐渐脱节,例如 GLM-5.2 画的鹈鹕比 GPT-5.6 和 Claude Fable 5 都好,但作者不认为 GLM 是那个级别的模型。更重要的是,鹈鹕完全测不到今天最要紧的能力,即模型能否在长对话里稳定调用工具。
pelicanzoo.ai 网站有哪些主要玩法?
主要玩法包括:猜模型,给一张鹈鹕和四个模型名猜作者,共 73 轮;投喂,用户提交自己生成的鹈鹕 SVG 代码和模型名,网站清洗代码后生成 GitHub 提交页面;翻车合集,展示画错成鸭子、苍鹭、火烈鸟甚至负鼠的案例;艺术评论家,大模型读 SVG 源码写点评;发徽章,投喂的鹈鹕合并后会获得百分制评分和可嵌入的徽章。
Simon 为什么还在继续画鹈鹕?
两个理由:一是逼自己真的去用新模型,贴出一只鹈鹕就意味着他确实跑通了该模型,不是光看发布会;二是哪怕一句提示词也能暴露不少东西,比如他发现 Kimi K3 的八个单词提示被算成 95 个输入 token,发一个“hi”也要 86 个,背后大概藏了一段 85 个 token 的系统提示。
