

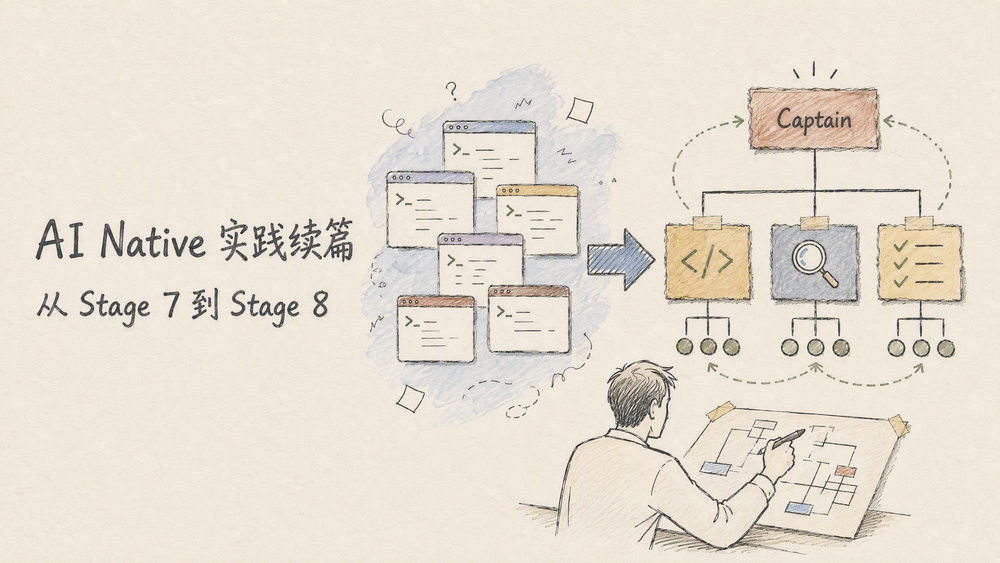
AI Native 实践续篇:迈向 Stage 8
内容提要
作者梳理了AI Native工作方式的演进,从Stage 7迈向Stage 8:将完整任务交给统筹Agent调度多个Agent,自己不再逐窗口盯进度。提出“测试测试”,即故意破坏代码以验证测试有效性,并要求Agent说明判断依据。用logbook组织从需求到上线的全流程,设置Delivery与Verify的对立立场,保留人工关口。强调对抗比循环更重要,保护完整注意力,记录思考过程,人负责问题、判断与认可。
延伸解读
“测试测试”补的是验证的可信度
文章把验证拆成两层:先看交付物是否通过,再检查测试本身是否可信。做法是故意拆掉被测功能的目标代码,重跑测试,预期应失败;若仍全绿,说明测试可能没触及要验证的行为。作者也明确边界:这只说明抓住了本次故障,不等同于完整的变异测试评估,不能据此推断整个系统没问题。
多 Agent 不是默认更优,要按任务规模选
作者指出上下文传递和沟通都有成本,多开 Agent 不会自动带来更好结果。他给出的个人经验是:按传统方式估算半小时、半天的活,一个 Agent 通常够用;接近一周量级、执行中不断遇到变化的任务,才更值得引入调度和对抗机制。这是经验判断而非固定门槛,且端侧、客户端案例不能直接套用到所有业务系统。
对抗机制防止流程顺畅地传错
文章认为对抗可能比循环更重要:只有推进机制,系统可能很顺畅地把错误往下传。因此设置 Delivery 与 Verify 的对立立场,让验证者认真找缺陷、交付者拿出解释和证据;分歧先由 Agent 讨论收敛,收敛不了由统筹者介入,再不行才升级给人。作者强调最终看运行结果和截图等证据,而不只看 Agent 是否说“一致同意”。
人工关口保留,但打断要集中
作者遇到的实际问题是 Agent 频繁停下来找人确认,任务难以持续。调整方式包括:开工前把目标、边界和交付要求谈清楚;用 Preflight 预演路径,提前暴露资源、权限和人工确认点;把确认集中到能看见结果的时候。合并等人工权限关口仍然保留,减少的是中途零碎打断,以便在更完整的结果上作决定。
Q&A
Stage 8 和 Stage 7 的主要区别是什么?
Stage 7 实现了多个 Coding Agent 并行,但仍需人工逐个窗口盯进度;Stage 8 则将完整任务交给一个统筹 Agent(Captain)调度其他 Agent,人逐步退出逐个窗口盯进度的状态,只关注统筹者的进展和结果。
什么是“测试测试”?具体怎么操作?
“测试测试”是指故意破坏被测功能的目标代码,然后重新运行相关测试,预期测试应该失败。如果功能已被破坏但测试仍全部通过,就说明测试没有触及要验证的行为,需要回头检查测试的有效性。
为什么要求 Agent 说明判断依据?
要求 Agent 交代考虑过哪些方案、最终选了哪个、为什么这么选以及拿什么证据支持,可以让人在需要介入时围绕具体分歧讨论,而不必从一大段执行记录里重新猜它为什么走到了这里。
logbook 在交付流程中起什么作用?
logbook 用于串起从需求、设计、确认、开发、验证、验证验证到上线的完整路径,明确目标、路径、约束和交付内容。它约束方案和流程,但不承载具体方案和代码,设计与实现仍在各自的工作位置。
Delivery 和 Verify 为什么要站在不同立场?
Delivery 负责推动交付,Verify 负责验证,两边各自守住不同的事情。如果所有 Agent 都把“赶紧做完”当作唯一目标,很容易一起跳过问题;让验证者认真找缺陷、交付者拿出解释和证据,分歧能推动修正和复测,使问题在交付前暴露。
多 Agent 调度适合什么样的任务?
按传统开发方式估算,半小时、半天的活通常一个 Agent 就够了;接近一周量级、执行过程中还会不断遇到变化的复杂任务,才更值得引入多 Agent 调度和对抗机制。这是个人选任务的经验,不是固定门槛。
在 AI Native 工作方式下,人还需要负责什么?
人负责问题、判断与认可:开始时谈清目标和边界,执行中让统筹者处理调度和一般分歧,必要时升级给人;最后带着证据交付,人要看运行结果和截图等证据,并亲自认可交出去的内容。架构判断、画图、抽查代码仍需自己碰。
