


生物医学影像的真正瓶颈在于数据,而非模型
内容提要
医学影像AI的瓶颈在于数据而非模型。数据困于PACS,格式繁杂、难以去标识化和跨机构共享,导致研究可复现性差。联邦学习与数据湖仓可整合影像、基因组、电子病历等多模态数据,实现统一治理与关联查询。核心结论:数据基础是医学AI的真正瓶颈,先做好数据,模型自然水到渠成。
延伸解读
数据可复现性危机
文章引用BMJ综述指出,81项深度学习与临床医生对比研究中,仅少数为前瞻性或真实临床环境测试,93%和95%的研究未提供代码和数据。这种可复现性债务直接源于影像数据难以共享和重跑。它提醒我们,模型性能的宣称若缺乏可验证的数据基础,其可信度将大打折扣。
联邦学习的实际收益与局限
EXAM研究显示,20家机构通过联邦学习在不移动患者数据的情况下训练模型,联邦模型平均AUC提升16%,泛化能力提升38%。但文章强调,协作困难更多是结构性和治理性的,而非技术性的。联邦学习适合数据法律上不能移动的场景,而数据湖仓的Delta Sharing可能更轻量。
去标识化的技术挑战
去标识化不仅涉及DICOM头部的PHI,还包括烧录在像素中的患者信息。文章提到,视觉语言模型在检测和遮蔽烧录PHI上已优于纯OCR流程,例如GPT-4o和Claude 3.7 Sonnet在MIDI-B基准上达到约100%的召回率和精确率,而Spark将1000帧的去标识化时间从105分钟缩短到6分钟。
从影像到多模态数据基础
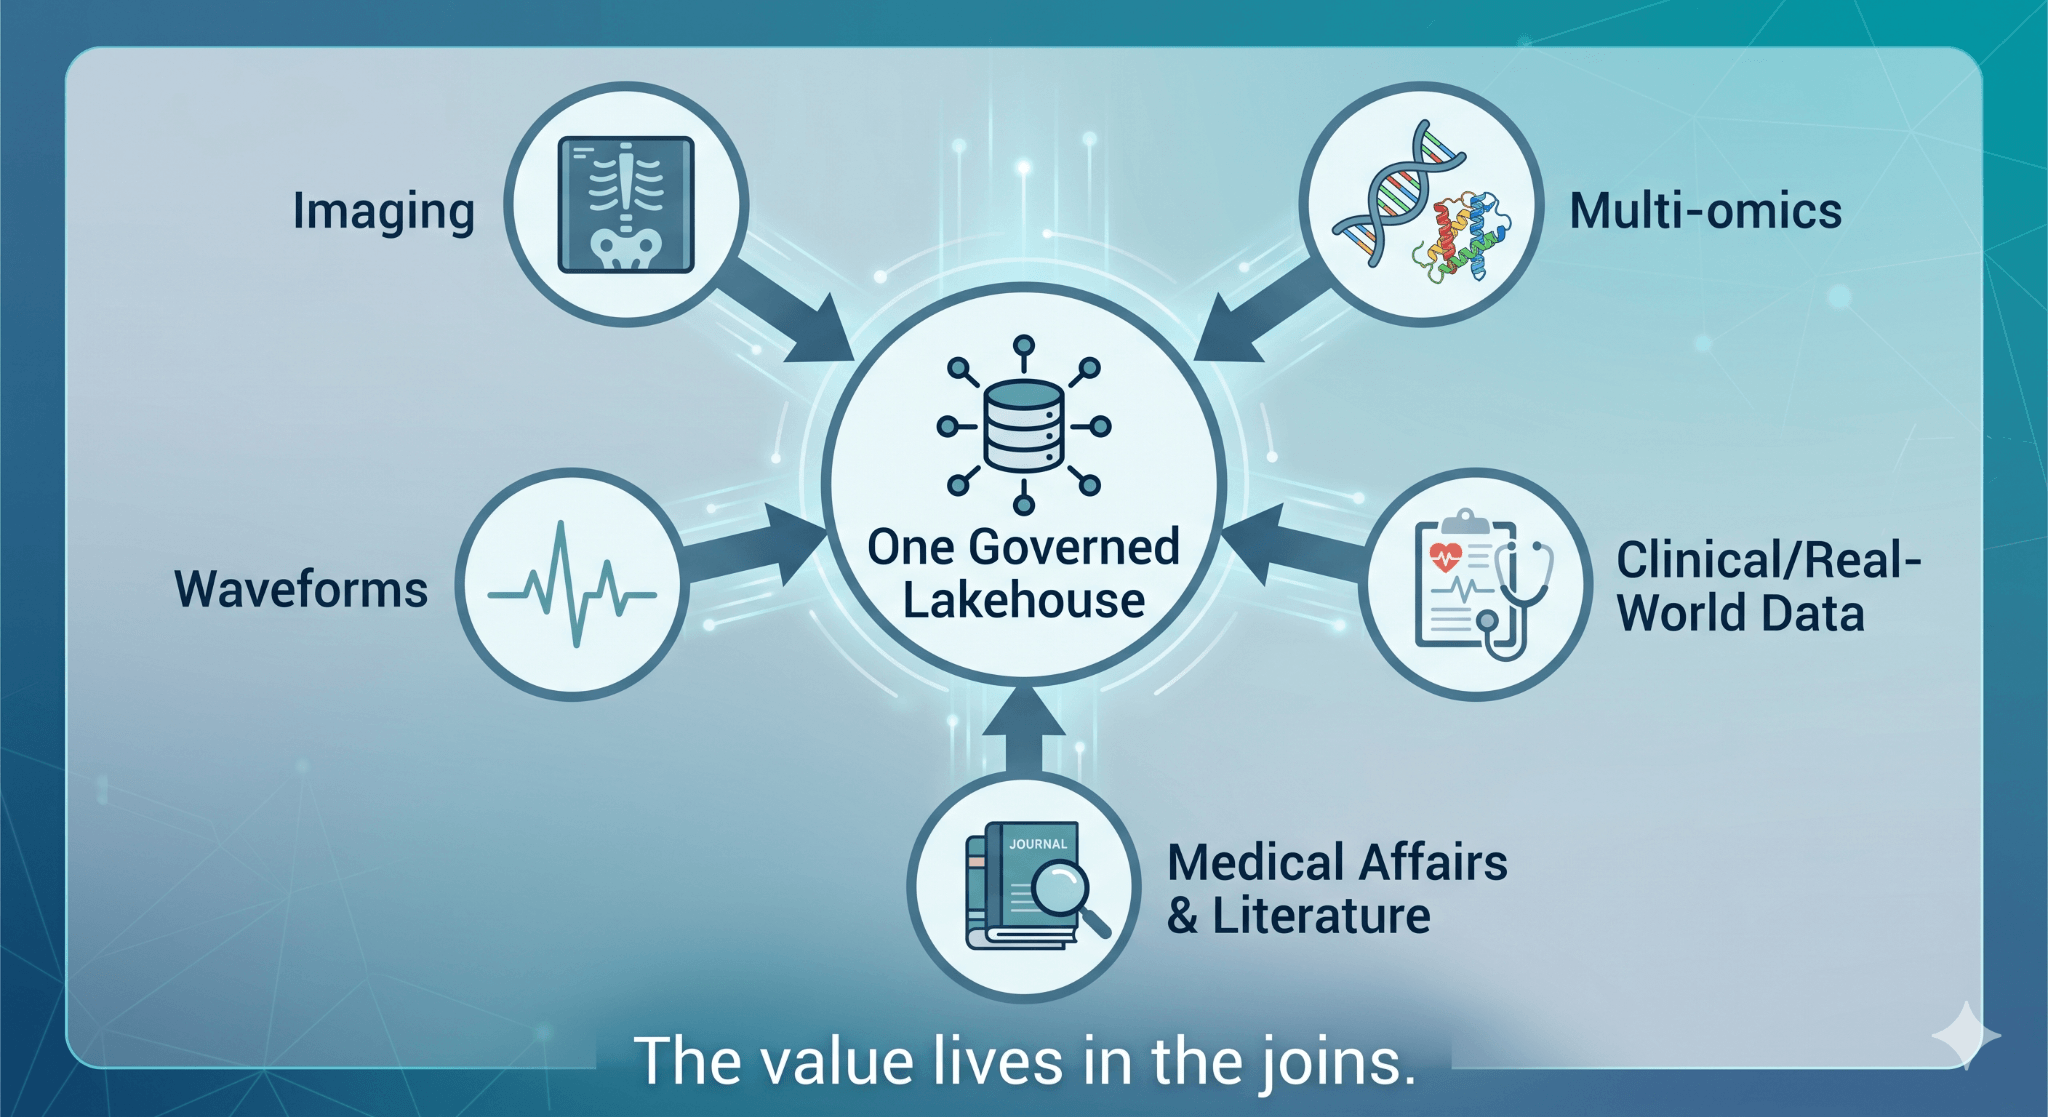
文章指出,影像只是数据问题最先显现的领域,其挑战同样存在于基因组学、电子病历等。真正的价值在于跨域关联,例如将影像与分子特征、结局数据结合。数据湖仓模式能统一治理这些多模态数据,使查询和关联成为可能,而这是AI应用的前提。
Q&A
为什么说医学影像AI的瓶颈在于数据而非模型?
因为模型本身相对容易构建,而数据却面临诸多挑战:数据锁在PACS中,格式繁杂,去标识化困难,跨机构共享不易,导致研究可复现性差。数据基础才是医学AI的真正瓶颈。
联邦学习如何帮助解决医学影像数据共享的难题?
联邦学习让各机构在本地训练模型,只共享模型权重而非原始数据。通过联邦平均、安全聚合和差分隐私,既能保护隐私,又能整合多机构数据,提升模型泛化能力。例如EXAM研究中,联邦模型比单站点模型平均AUC提升16%,泛化性提升38%。
医学影像数据有哪些独特的复杂性?
医学影像并非单一格式,而是包含多种格式和尺度(如DICOM、病理全切片图像等),数据量可达PB级。此外,不同站点、扫描仪和协议下的定量测量值(如SUV、肿瘤体积)不可直接比较,需要QIBA等标准来确保可重复性。
数据湖仓如何支持多模态医学数据的整合与查询?
数据湖仓(如Databricks)通过统一治理、分布式解析DICOM、去标识化、并与FHIR、基因组、波形等数据关联,实现影像、基因组、电子病历等多模态数据的统一治理和关联查询。例如,使用Delta Sharing和Clean Rooms可在不复制数据的情况下共享治理视图。
在医学影像AI中,去标识化面临哪些挑战?如何解决?
去标识化需处理DICOM头中的PHI和烧录在像素中的PHI(如超声图像中的患者姓名)。头部PHI可用格式保留加密处理,像素PHI则需OCR和视觉语言模型。例如,GPT-4o和Claude 3.7 Sonnet在MIDI-B基准上达到约100%的召回率和精确率,Spark可将1000帧的去标识化时间从105分钟缩短到6分钟。
医学影像AI模型在临床部署后需要注意什么?
模型在单站点表现良好,但可能在其他站点、厂商或协议下性能下降。因此需要跨站点、跨厂商的外部验证,并持续监控数据漂移。同时,应遵循FDA的PCCP和GMLP指南,将监管要求构建到数据基础中,确保模型可更新且安全。
