


MemGraph 背后论文《基于内存和MVCC 的高速可串行化》详细解析(一)
内容提要
Memgraph是一种内存型图数据库,使用OpenCypher作为查询语言。它使用链表存储多版本数据,并通过时间戳实现数据的可见性。通过条件判断,确定事务对数据的可见性。
延伸解读
原地更新与Undo Buffer的协同设计
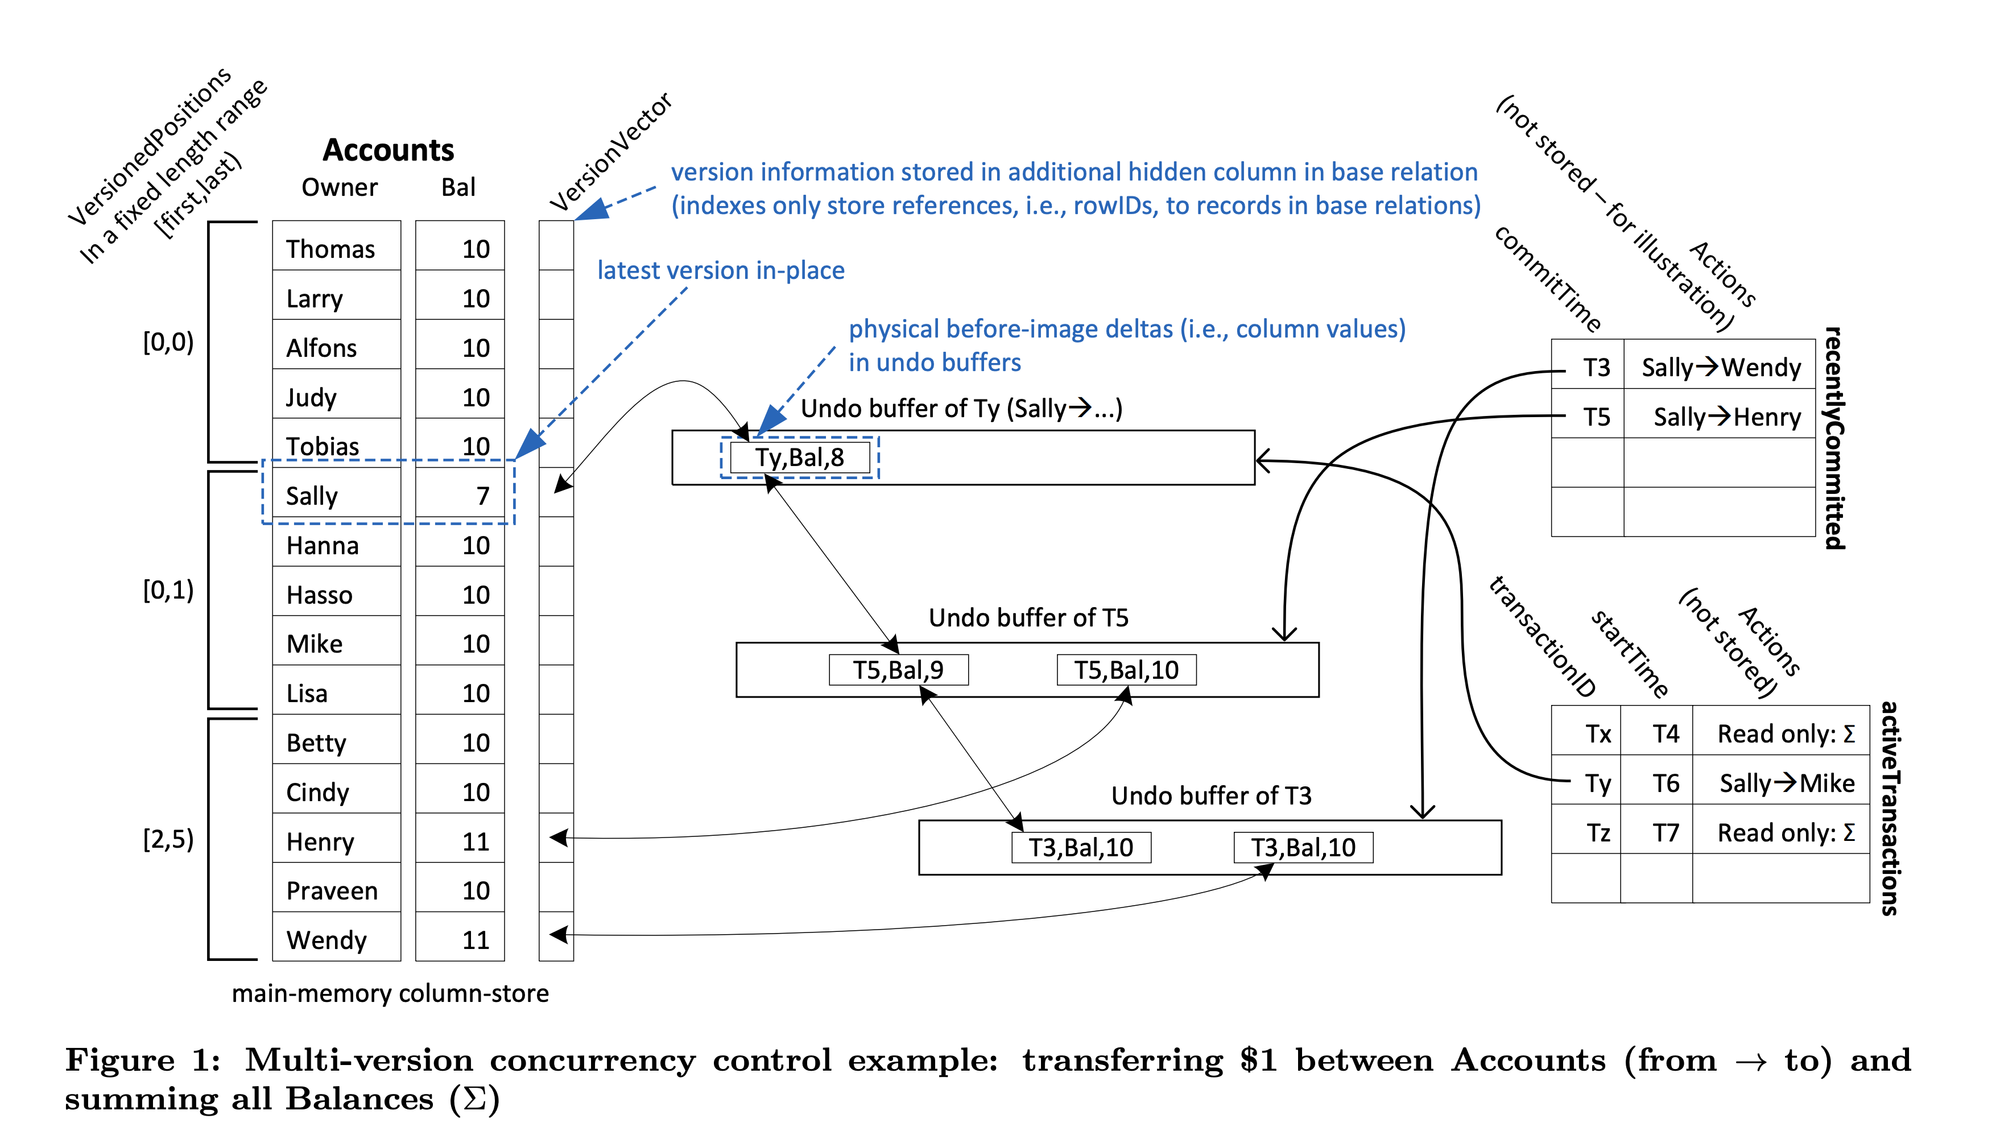
Memgraph采用原地更新数据,但将旧值保存在Undo Buffer中。这样既避免了为每个版本分配新内存,又通过链表将旧版本串联起来。Undo Buffer中的旧值有两个作用:一是作为事务回滚的undo日志,二是作为字段多版本的历史值。这种设计在保证MVCC语义的同时,减少了内存开销和拷贝成本,适合内存数据库的高性能需求。
时间戳划分与可见性判断逻辑
事务进入系统时获取事务ID和起始时间戳,提交时获取提交时间戳。事务ID从2^63开始,起始和提交时间戳从0开始,这种划分使得事务ID天然大于任何起始/提交时间戳。可见性判断时,沿着版本链表查找,直到满足三个条件之一:到达链表尾、遇到自己的事务ID、或遇到提交时间戳小于自己起始时间戳的版本。这确保了事务只能看到自己修改的数据和已提交的旧版本。
链表结构如何映射时间轴
版本链表采用头插法,表头是最新数据,表尾是最旧数据。每个节点携带时间戳(事务进行中为事务ID,提交后为提交时间戳)。通过比较事务起始时间戳与链节时间戳,可以确定事务能看到哪个版本。例如,起始时间戳为T4的事务会看到提交时间戳T3对应的值,而起始时间戳为T7的事务会看到T5对应的值。链表实际上将时间轴分段,每段对应一个可见版本。
Q&A
Memgraph 是什么类型的数据库?它使用什么查询语言?
Memgraph 是一个内存型图数据库,使用 OpenCypher 作为查询语言,主打小数据量、低延迟的图场景。
Memgraph 的内存结构实现灵感来自哪篇论文?
Memgraph 的内存结构实现灵感主要来自论文《Fast Serializable Multi-Version Concurrency Control for Main-Memory Database Systems》。
Memgraph 如何存储多版本数据并控制可见性?
Memgraph 使用列存、复用 Undo Buffer 数据结构和双向链表来存储多版本数据,并通过时间戳实现数据的可见性。具体来说,更新在原地进行,旧值保存在 Undo Buffer 中,并通过链表连接,链表头由 VersionVector 维护。
Memgraph 中事务的可见性判断条件是什么?
事务访问数据时,会沿着链表查找,直到满足以下条件之一:1) v.pred == null(链表到头或无多版本);2) v.pred.TS == T(访问自己更新的数据);3) v.pred.TS < T.startTime(访问已提交的老版本数据)。
Memgraph 中事务的时间戳是如何分配的?
每个事务进入系统时获取两个时间戳:transactionID(从 2^63 开始自增)和 startTime-stamp(从 0 开始自增)。提交时获取 commitTime-stamp,与 startTime-stamp 共用一个自增计数器。
Memgraph 如何确保事务能看到自己的更新?
通过可见性判断条件中的 v.pred.TS == T,即当链表节点的 timestamp 等于当前事务的 transactionID 时,事务会停止查找并看到自己更新的值。
