


气隙隔离,数据不暗:Bright Machines 如何在不开放工厂的情况下为客户提供实时工厂仪表板
内容提要
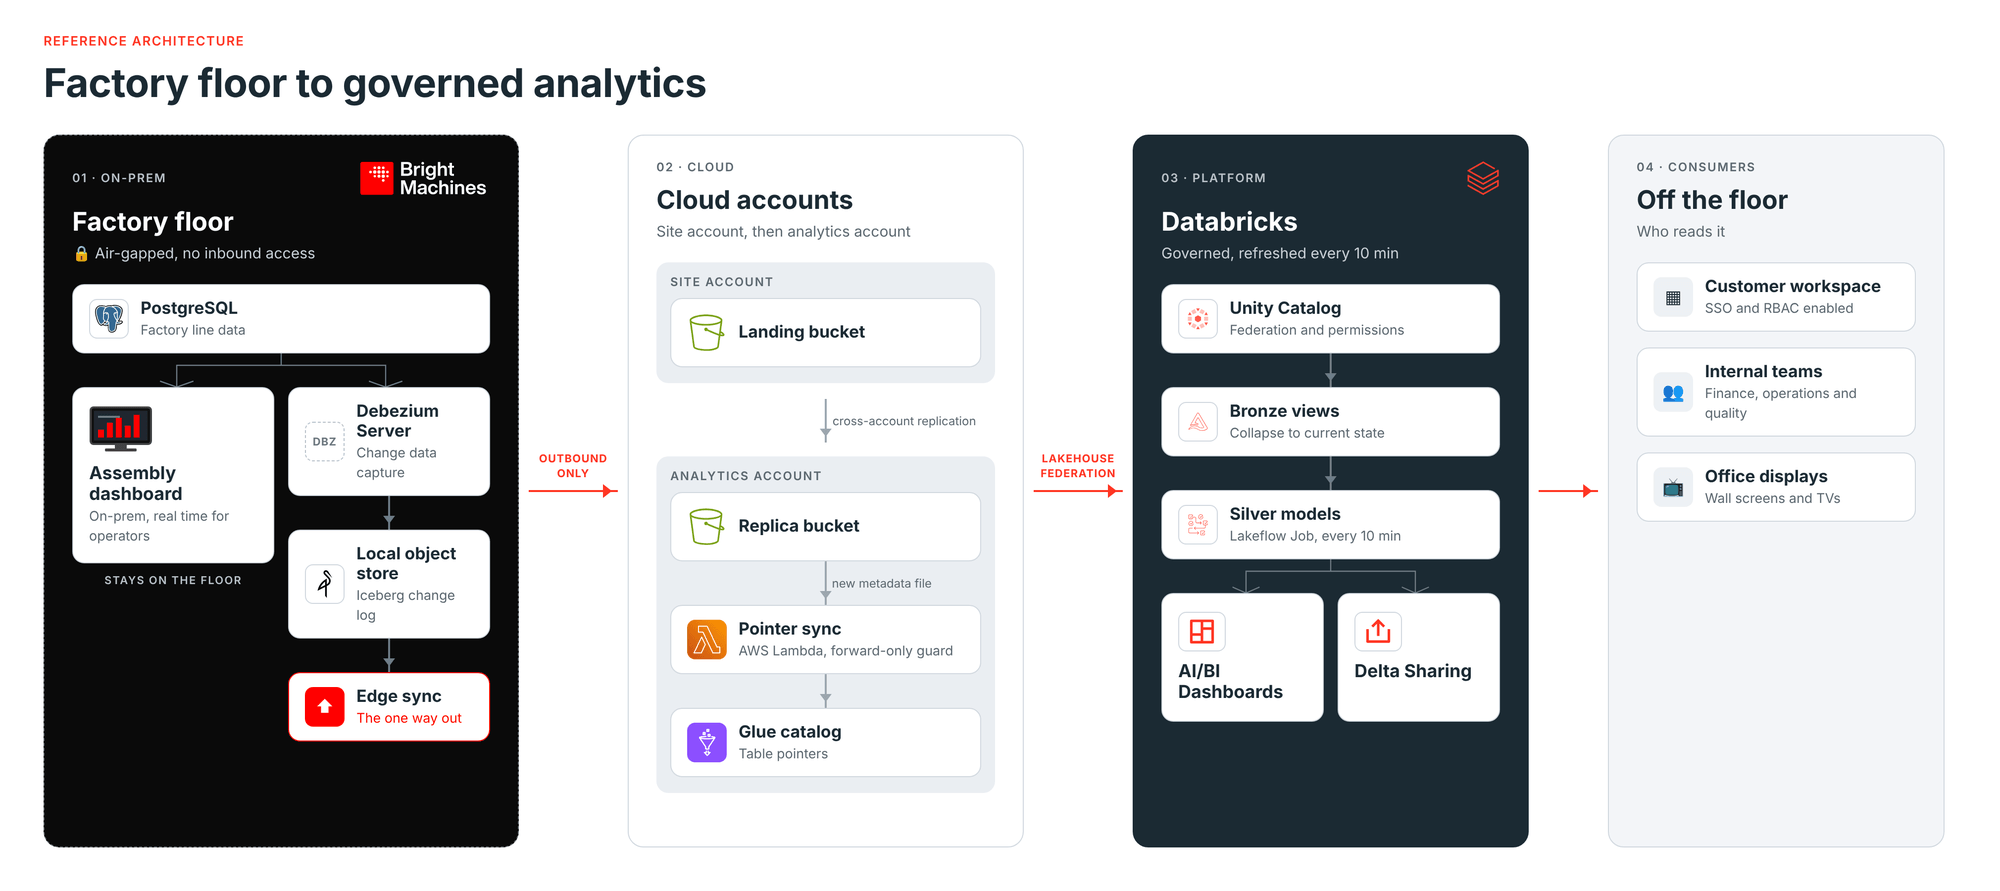
Bright Machines 为气隙工厂设计数据共享方案:在工厂边缘用 Debezium 捕获 PostgreSQL 变更并写入 Apache Iceberg,数据经唯一可审计的出站路径传出,再由 Unity Catalog 联邦读取,无需入站访问。数据约1–2分钟可查,仪表板每10分钟刷新,客户按角色查看受治理数据,首个客户仪表板约两个月上线。
延伸解读
为何选择边缘捕获而非直接拉取
文章指出,直接拉取方案需要从云端到工厂数据库的网络路径,并在数据所在账户之外运行摄取,违背了“数据可推出、外部不可进入”的威胁模型。Bright Machines 因此翻转方向:在工厂边缘用 Debezium 捕获变更,写入本地 Iceberg,再经唯一出站路径推送。这一选择牺牲了搭建速度,但换来了与工厂现有安全模型一致的可审计性,也避免了在客户账户外处理原始数据。
心跳机制解决“无数据”与“管道故障”的混淆
换班时产线停止,没有新行写入,这与管道中断在行数上表现相同。Bright Machines 让 Debezium 每五分钟更新每个源库的一行心跳表,该更新走与生产数据相同的路径。Lakeflow 作业首先检查心跳,若任一超过三十分钟未更新则任务失败、作业变红,仪表板继续显示最后有效数据,而不是把陈旧数据当作当前数据展示。
规模瓶颈在对象数量而非字节量
文章提到每天移动几百 GB 数据,但表现为数十万个小对象,因此每个设计决策最终都围绕对象速率而非字节数展开。这对类似气隙数据共享场景有直接提示:当变更日志以大量小文件形式落地时,复制、注册和指针推进的复杂度会随对象数增长,容量规划不能只看总数据量。
上线节奏与治理验证
方案分四步推进:概念验证产线试点、最高价值产线投产、与旧快照路径并行逐行核对、客户仪表板硬切换。概念验证由两名工程师约六周完成,首个客户可见仪表板在启动后约两个月上线。文章还提到,联邦表治理的严格程度在切换时造成过麻烦,但正是现在依赖的同一严格性,说明治理验证应在上线前而非事后补做。
Q&A
Bright Machines 如何在不开放工厂入站访问的情况下,让客户看到实时工厂仪表板?
Bright Machines 在工厂边缘用 Debezium 捕获 PostgreSQL 变更,写入本地 Apache Iceberg 变更日志,再通过唯一可审计的出站路径将对象同步到云账户,最后由 Unity Catalog 联邦读取 AWS Glue 中的 Iceberg 表,在 Databricks 中提供仪表板,全程无需入站访问。
工厂数据从产生到在 Databricks 中可查询需要多长时间?仪表板刷新频率是多少?
稳态下,生产线上提交的一行数据在 1 到 2 分钟内即可在 Databricks 中查询。Silver 模型和仪表板每 10 分钟刷新一次。需要实时视图的操作员继续使用本地装配仪表板。
客户可以通过哪些方式访问工厂数据?权限如何控制?
客户可以通过两种方式访问:一是带有基于角色权限的 AI/BI 仪表板,集成 Bright Machines 的 SSO 联邦;二是通过 OpenSharing 将零拷贝的受治理 silver 表发布给拥有 Databricks 账户的客户。权限由 Unity Catalog 管理,确保客户只能看到其角色允许的表和仪表板。
为什么 Bright Machines 放弃了最初的九服务管道架构?新架构解决了哪些问题?
最初的九服务管道架构复杂且存在多个问题,包括需要从云端拉取数据(违反无入站访问原则)、治理难以证明、新鲜度不足等。新架构采用边缘变更数据捕获和 Unity Catalog 联邦,保持了无入站连接、单一可审计出站路径、分钟级新鲜度,并且所有接触原始工厂数据的组件都在自有环境内,治理严格可审计。
如何确保数据管道在生产线停机时不会误报为故障?
Bright Machines 使用心跳机制:Debezium 每 5 分钟更新每个源数据库中的一行心跳表,无论生产线是否运行。Lakeflow 作业的第一个任务检查心跳,如果任何心跳超过 30 分钟未更新,则任务失败,整个作业变红,仪表板继续显示最后已知的良好数据,而不是将陈旧数据呈现为当前数据。
该方案的实施周期和团队规模是怎样的?
概念验证在一条复制生产线上进行,由两名工程师耗时约六周完成。首个客户可见的仪表板在项目启动后约两个月上线。实施分四个阶段:概念验证线试点、最高价值生产线投产、与旧快照路径并行运行校验行级一致性、最终硬切换客户仪表板。
该架构是否支持其他云平台(如 Azure 或 Google Cloud)?
是的。云特定部分仅包括边缘同步目标、跨账户复制和目录跳转。Databricks 侧的所有组件在任何云上都是相同的,因此迁移到其他云只需更改少量资源,而非重建。
