


把 Ascend 310P3 切进 Kubernetes:HAMi vNPU 硬切实战
内容提要
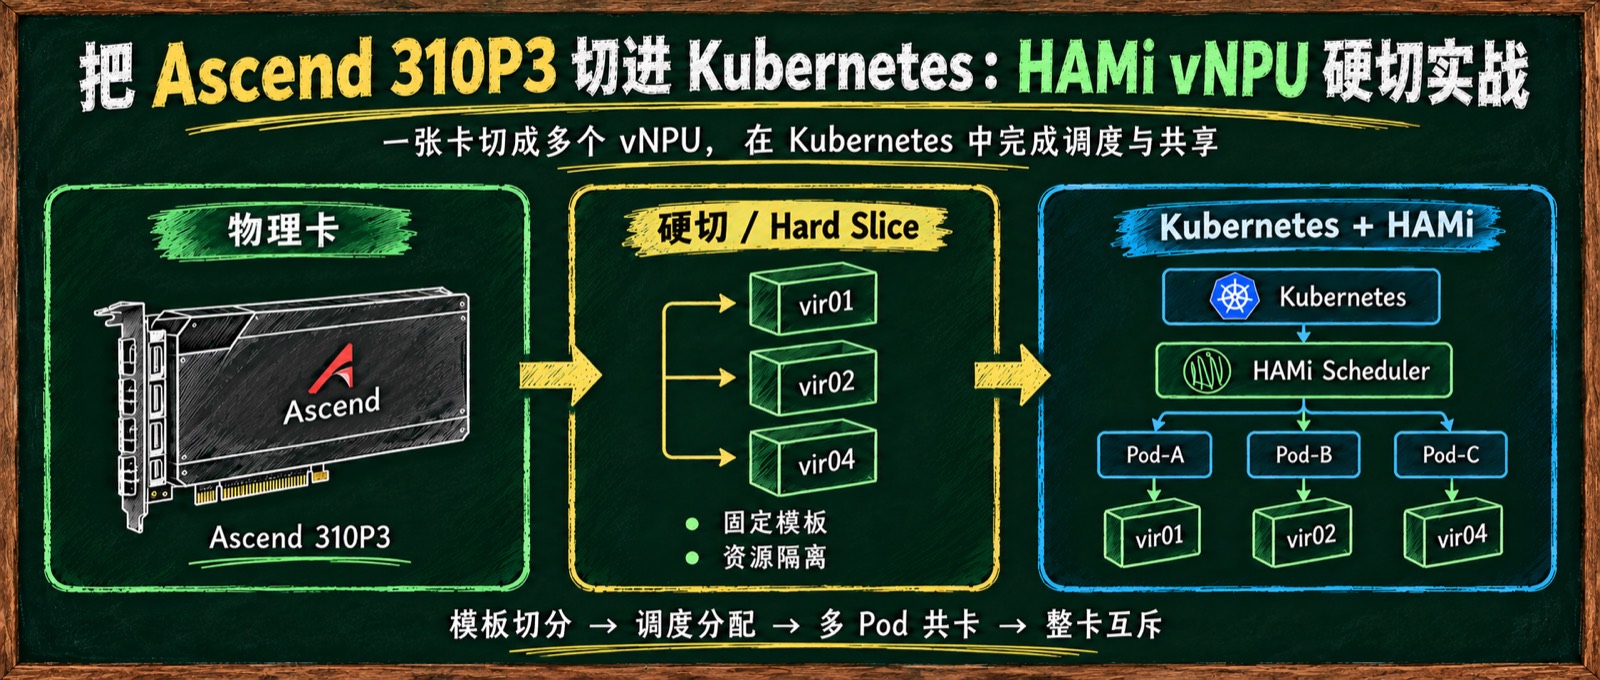
本文介绍在 Ascend 310P3 上使用 HAMi 2.10 实现 vNPU 硬切分并接入 Kubernetes。310P3 仅支持从固定模板 vir01/02/04 中选择,HAMi 根据 Pod 显存请求匹配最小模板,由调度器分配设备,device-plugin 与 Ascend Runtime 负责暴露 vNPU。实测验证了模板匹配、超限回退整卡、多 Pod 共卡、整卡与切片互斥、残留 vNPU 清理,以及 Pod 内运行 AscendC 负载和调度监控指标。
延伸解读
版本兼容性提醒
文章实测环境为 Ascend Driver 22.0.4,而 ascend-device-plugin v1.4.1 官方部署文档要求 Ascend Driver ≥ 25.5。作者明确说明该组合低于官方要求,实测结果仅对应本文环境,不代表官方支持或推荐。读者若在相近旧驱动上复现,需自行承担兼容性风险,并注意后续升级可能带来的行为变化。
模板匹配与整卡回退逻辑
310P3 硬切并非任意比例,而是从 vir01/02/04 固定模板中选择。HAMi 根据 Pod 显存请求匹配满足条件的最小模板,例如 1024 MiB 匹配 vir01,4096 MiB 匹配 vir02,7000 MiB 匹配 vir04。当请求超过最大模板 12288 MiB 时,webhook 会将其提升为整卡可调度显存 21527 MiB,转为整卡申请,而非创建更大 vNPU。
残留 vNPU 的排查与清理
删除 Pod 后 vNPU 不一定立即释放,可能留下 Container ID 为 000000000000 的残留实例,占用显存导致后续 Pod 创建失败。判断方法是同时查看 npu-smi info -t info-vnpu 和 npu-smi info,对比 HAMi 播报容量与硬件剩余显存。清理可重启 device-plugin 触发回收,或使用 npu-smi set -t destroy-vnpu 手动销毁。
监控指标的含义与局限
HAMi 暴露的 hami_vgpu_memory_allocated_bytes 表示调度分配量,而非 Pod 实时使用量。例如三个 Pod 分别显示 3072、6144、12288 MiB 换算后的字节数,对应模板配置值。宿主机物理卡 Memory-Usage 不会按相同幅度增长,因此不能用它反推单个硬切 Pod 的实时显存。旧驱动下 vNPU 内部统计与物理卡统计口径不同,需注意区分。
Q&A
HAMi 在 Ascend 310P3 上如何根据 Pod 的显存请求选择 vNPU 模板?
HAMi 会根据 Pod 的显存请求,从芯片支持的固定模板(vir01/02/04)中选择能够满足请求的最小模板。例如申请 1024 MiB 会匹配 vir01(3072 MiB),申请 4096 MiB 匹配 vir02(6144 MiB),申请 7000 MiB 匹配 vir04(12288 MiB)。admission webhook 会将 Pod 中的显存值调整为所选模板的配置值。
为什么一张 Ascend 310P3 物理卡在 Kubernetes 中显示为 7 个可调度资源?
因为 HAMi/device-plugin 按最小 vNPU 模板(vir01=3072 MiB)折算可调度资源份额。310P3 的 memoryAllocatable 为 21527 MiB,计算 floor(21527/3072)=7,因此向 Kubernetes 上报 huawei.com/Ascend310P: 7。这代表可调度的虚拟设备数量,并非 7 张物理 NPU。
当 Pod 申请的显存超过最大 vNPU 模板时,HAMi 会如何处理?
如果申请的显存超过最大模板 vir04(12288 MiB),HAMi 会将其回退为整卡申请。例如申请 13000 MiB 时,webhook 会将显存提升为整卡可调度显存 21527 MiB,Pod 内看不到 ASCEND_VNPU_SPECS,npu-smi 显示完整的物理 310P3。但若卡上已有切片,同样的请求会因 CardInsufficientMemory 保持 Pending。
多个 Pod 能否共享同一张 Ascend 310P3 卡?容量耗尽时会怎样?
可以。多个 Pod 可以同时申请 vNPU 切片并共享同一张物理卡,HAMi 会分配相同的物理设备 UUID,每个容器内看到独立的 vNPU 实例。当容量耗尽时,例如 8 个 Pod 各申请一个 vir01,只有 7 个能 Running,第 8 个会 Pending,并报错 CardTimeSlicingExhausted。
整卡 Pod 和 vNPU 切片 Pod 能否同时运行在同一张 Ascend 310P3 上?
不能。HAMi 2.10 中整卡与切片是双向互斥的。如果整卡 Pod 先运行,再创建切片 Pod,切片 Pod 会 Pending 并报 CardInsufficientMemory;反之,如果切片 Pod 先运行,再申请整卡,整卡 Pod 也会 Pending 并报同样错误。调度器通过设备显存记账阻止两类工作负载同时使用同一张卡。
删除 Pod 后 vNPU 没有释放导致新 Pod 创建失败,如何排查和清理?
排查方法:对比 npu-smi info -t info-vnpu 和 npu-smi info,若 vNPU 条目的 Container ID 为 000000000000 且剩余显存低于 HAMi 播报容量,则存在残留 vNPU。清理方式:重启 device-plugin 触发回收(kubectl -n kube-system rollout restart daemonset/hami-ascend-device-plugin),或手动销毁(npu-smi set -t destroy-vnpu -i 7 -c 0 -v VNPU_ID)。
在 vNPU 切片内可以运行真实的 AscendC 负载吗?如何验证?
可以。在 vir04 容器中通过 ACL 初始化设备并申请约 6 GiB 内存,npu-smi 显示显存分配和释放正常。编译并运行 CANN 自带的 AscendC 基础算子(加法和矩阵乘),输出正确结果,宿主机采样到 20% 的 AICore 利用率,证明任务进入 AI Core 执行。
HAMi 调度侧提供了哪些监控指标来观察 vNPU 分配情况?
HAMi scheduler 在 9395 端口暴露 Prometheus 指标,可通过 NodePort 31993 访问。关键指标包括:hami_gpu_shared_count(共享设备数量)、hami_resource_quota_used(资源配额使用量)、hami_vgpu_memory_allocated_bytes(Pod 维度的显存分配量,单位为字节)。这些指标反映调度分配量,而非实时使用量。
