


Bland 发布 Tofu-1:面向通话场景的全双工语音到语音模型
内容提要
Bland发布研究预览版全双工语音模型Tofu-1,面向嘈杂通话场景,可直接以音频完成听、思考与回复,无需转写文本。该模型支持说话人追踪、噪声分离和情绪识别,可被中途打断,并能边处理任务边对话。Bland未公开架构、参数量、延迟和定价,仅称筛测中超过92%的人无法辨认为AI。目前仅限企业封闭预览,目标行业包括银行、医疗、保险和政府。
延伸解读
全双工架构的取舍:保留音频信息,但透明度不足
Tofu-1 采用全双工语音到语音架构,直接处理音频,避免级联架构中转写文本造成的信息损失,从而保留语气、犹豫和背景声。这对嘈杂通话场景有实际意义。但 Bland 未公开模型架构、参数量和延迟,读者难以评估其技术成熟度。与公开延迟数据的竞品相比,Tofu-1 的实时性能仍是未知数,企业选型时需谨慎。
“电视测试”演示仅为示意,实际抗噪能力待验证
Bland 用“电视测试”展示模型在背景语音干扰下跟踪通话者的能力,但明确标注演示为示意性内容,并非模型实录输出。这意味着该能力尚未得到真实输出验证。对于医院、车载等强噪声场景,实际表现可能因环境而异。读者应关注后续是否有真实录音或第三方测试来佐证其噪声分离和说话人追踪效果。
封闭企业预览:目标行业明确,但关键信息缺失
Tofu-1 目前仅限有限企业封闭预览,目标行业包括银行、医疗、保险和政府,报名需填写月度通话量。Bland 称将于 1 月开放,但未公布定价、参数量和延迟。唯一公布的性能数据是自报的“超过 92% 的人无法辨认为 AI”,缺乏独立验证。企业在评估时需注意这些信息缺口,并考虑与已公开延迟和工具调用得分的竞品进行对比。
Q&A
Bland Tofu-1 是什么?主要用在哪些场景?
Tofu-1 是 Bland 发布的研究预览版全双工语音到语音模型,目标场景是行驶中的汽车、医院病房和信号微弱的线路上的通话。它能在通话中直接以音频完成听、思考与回复,无需转写文本。
Tofu-1 和传统的级联式语音智能体有什么区别?
大多数语音智能体采用级联架构:先语音转文本,交给语言模型处理,再转回语音。Tofu-1 直接聆听音频,保留语气、犹豫、背景声等信息给模型使用,中间不需要转写文本。
Tofu-1 具备哪些音频理解能力?
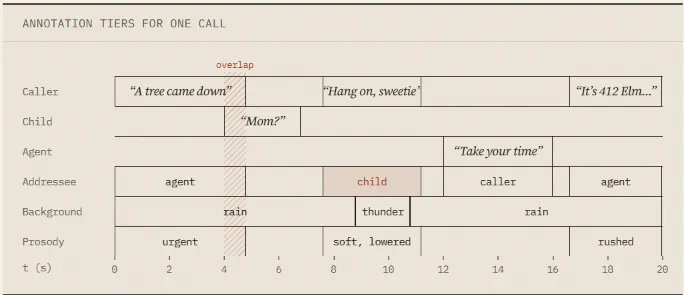
Bland 列出了三项音频能力:说话人追踪(区分不同说话人并判断对谁说)、噪声分离(从哭闹的孩子、电视、车流、医院对讲机或按键音中分离语音)、副语言信息(听出犹豫、沮丧和急迫的情绪)。
Tofu-1 的全双工和“边说边想”具体指什么?
通话者可以在 Tofu-1 说到一半时打断或纠正它。它在处理请求的同时会让对话继续推进,只有任务真正完成后才报告结果,绝不提前声称任务已完成。
Bland 的“电视测试”是什么?
电视测试只问一个问题:模型能否在忽略另一场景语音的同时,跟住通话者?电视音频往往比通话者更响。Bland 标注其电视测试演示为示意性内容,并非模型实录输出。
如何获取 Tofu-1?目前开放给哪些行业?
Tofu-1 目前仅限企业封闭研究预览,Bland 将银行、医疗、保险和政府列为目标行业。报名表单要求填写月度通话量,选项从不足 1,000 次到 50,000 次以上。Bland 称将于 1 月开放。
Tofu-1 公布了哪些性能数据?与其他全双工模型相比如何?
Bland 未公开架构、参数量、延迟和定价,唯一公布的数字是自报数据:在筛测中超过 92% 的人无法辨认出它是 AI。竞品如 OpenAI GPT-Live-1 和 NVIDIA Nemotron 则公开了延迟和工具调用得分,但基准版本不同,不能直接比较。
