


使用$x$T框架建模超大图像
内容提要
研究人员提出了$x$T框架,以更有效地处理大图像。该方法通过嵌套标记化将图像分割成小块,结合区域编码器和上下文编码器,保持细节和全局信息,避免传统方法中的信息损失。在多个计算机视觉任务中表现出色,推动了科学研究和医疗诊断的发展。
延伸解读
传统方法的局限与$x$T的突破
处理大图像时,传统方法要么下采样要么裁剪,这会导致信息丢失或上下文缺失。$x$T通过嵌套标记化将图像分层分割,结合区域编码器和上下文编码器,在保持局部细节的同时整合全局信息,避免了传统方法中的信息损失。
嵌套标记化:分层处理图像
嵌套标记化将图像分割成区域,再进一步细分为子区域,直到适合区域编码器处理。这种分层方法允许在不同尺度上提取局部特征,类似于先看城市地图的区、街道,再关注具体建筑,既见树木又见森林。
区域与上下文编码器的协同
区域编码器独立处理每个区域,生成详细表示;上下文编码器则整合这些表示,捕捉长距离依赖。两者结合,使模型既能关注局部细节,又能理解整体上下文,从而在多个计算机视觉任务中取得优异表现。
实际影响与未来方向
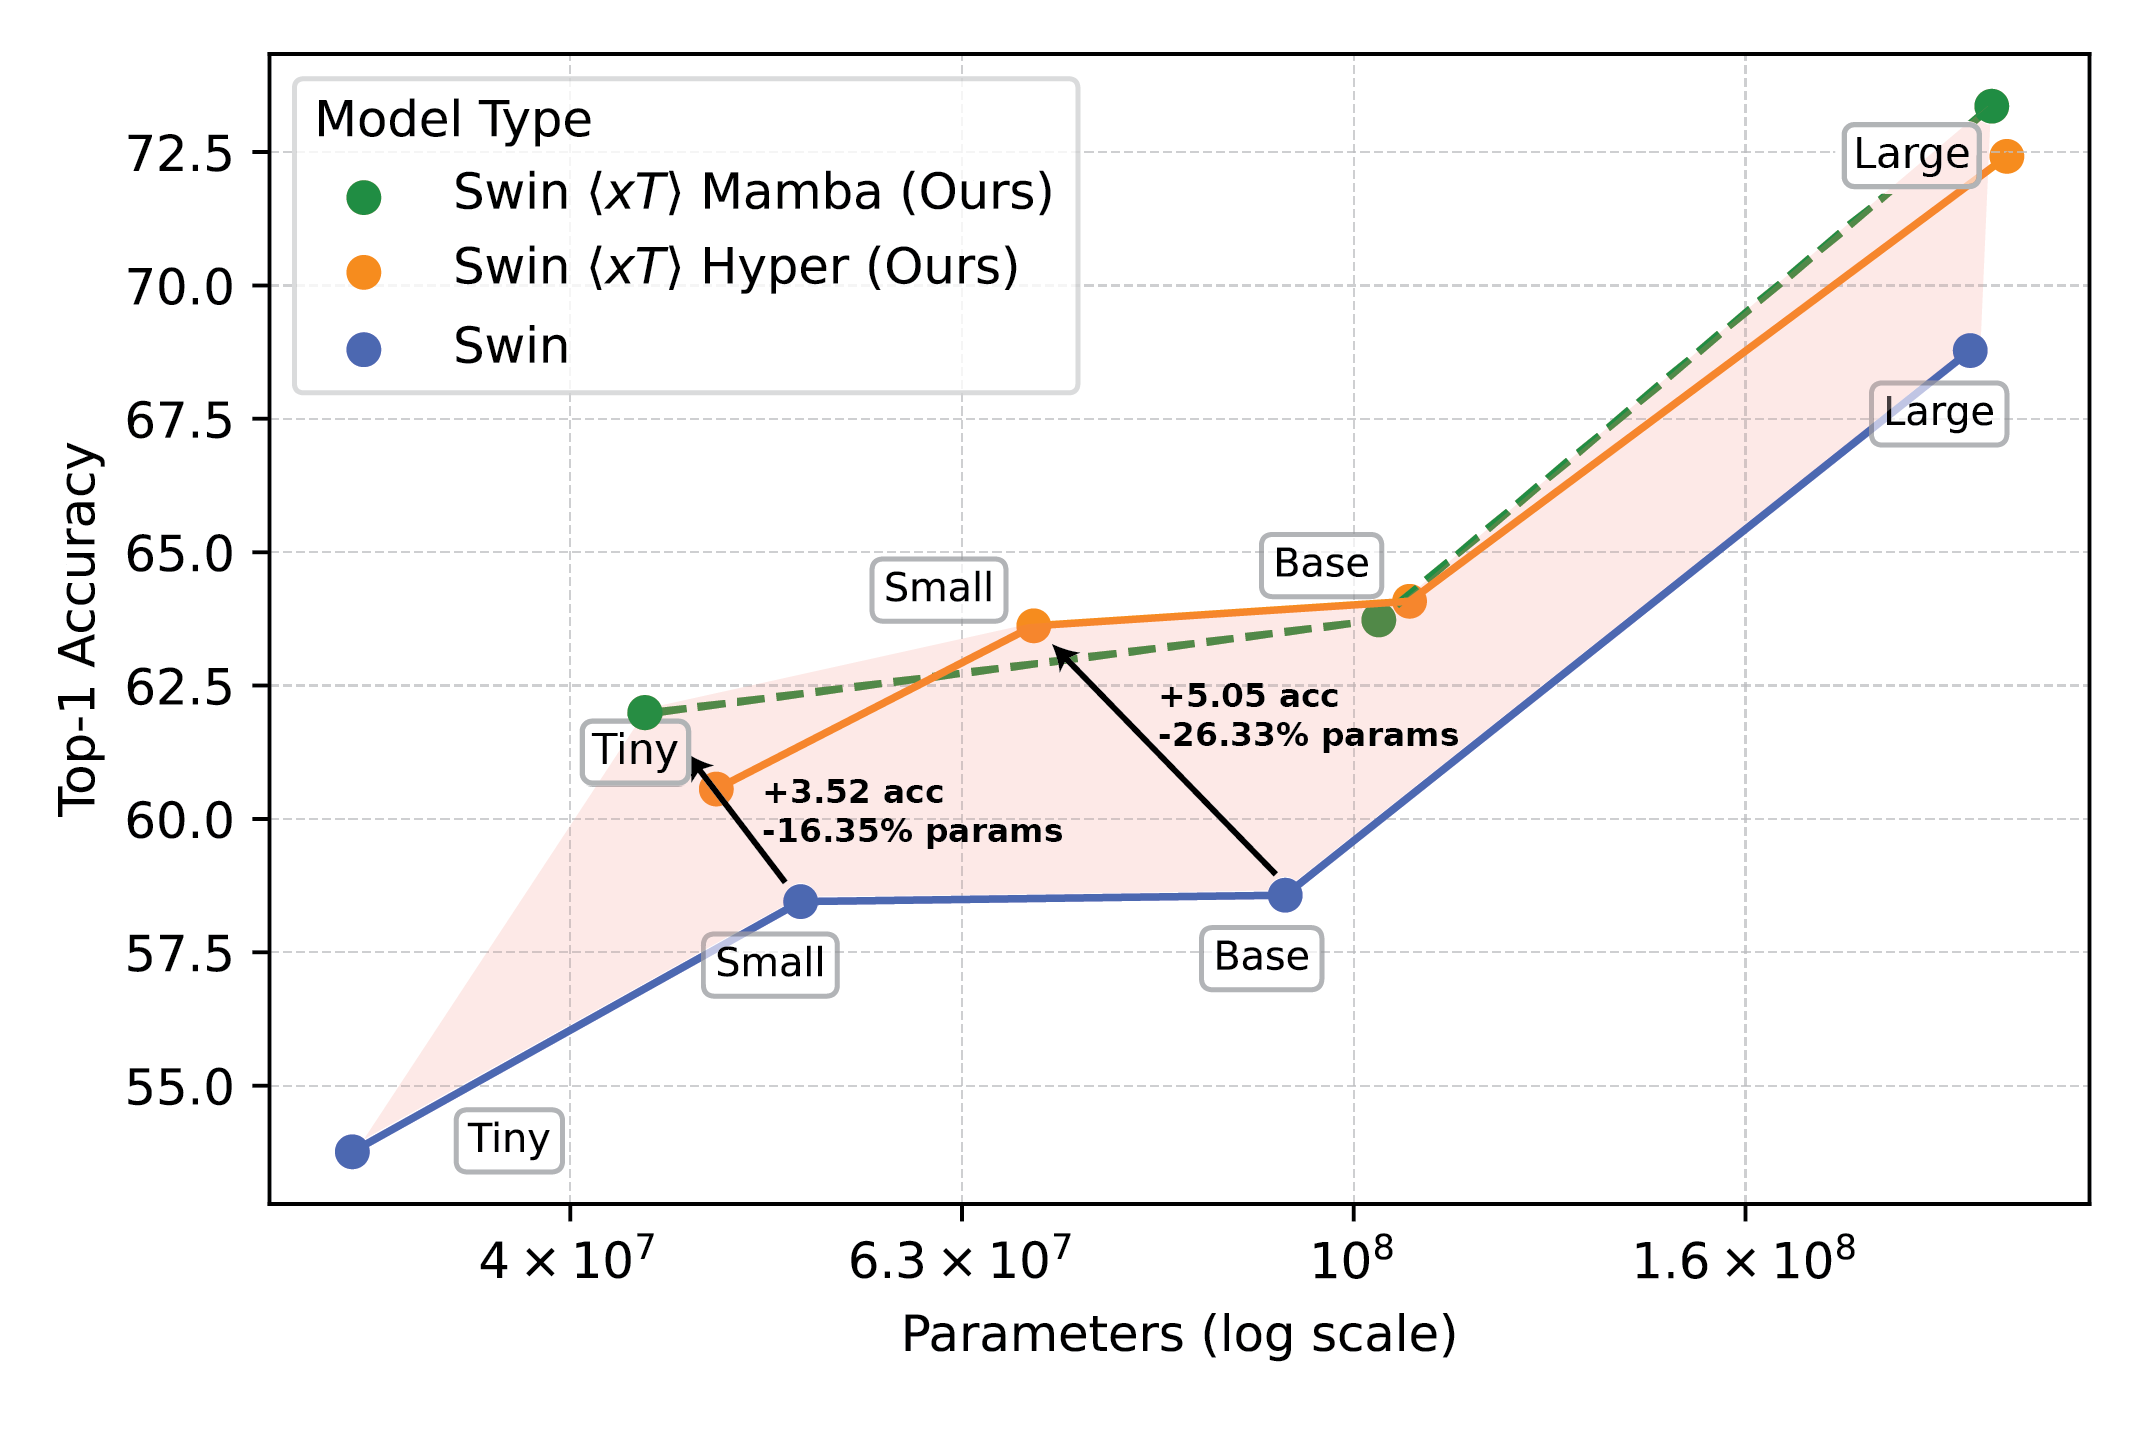
$x$T能处理高达29,000 x 25,000像素的图像,在准确性和内存使用上优于现有基线,为科学研究和医疗诊断等需要大图像分析的领域提供了新工具。研究人员正进一步扩展该框架,以处理更大更复杂的图像。
Q&A
什么是$x$T框架,它的主要功能是什么?
$x$T框架是一种新方法,用于更有效地处理超大图像,通过嵌套标记化将图像分割成小块,结合区域编码器和上下文编码器,保持细节和全局信息。
$x$T框架如何处理大图像以避免信息损失?
$x$T通过嵌套标记化将图像分割成小块,并结合区域编码器和上下文编码器,确保在提取局部特征的同时保持全局信息。
$x$T框架在计算机视觉任务中的表现如何?
$x$T在多个计算机视觉任务中表现出色,能够处理高达29,000 x 25,000像素的图像,并在准确性和内存使用方面优于现有的最先进基线。
$x$T框架的嵌套标记化有什么优势?
嵌套标记化允许在不同尺度上提取局部特征,同时保持全局信息,使得处理大图像时能够更好地理解细节与整体关系。
$x$T框架如何结合区域编码器和上下文编码器?
区域编码器负责将独立区域转换为详细表示,而上下文编码器则整合这些表示,以获取整体视角,从而更全面地理解图像。
$x$T框架对科学研究和医疗诊断有什么影响?
$x$T框架的应用能够帮助科学家和医生更好地分析大图像,从而在气候变化监测和疾病早期诊断中提供更全面的信息。
