


Vec-Tok-VC+: 双重训练策略下基于渐进式损失约束和残差增强的鲁棒零样本语音转换 | INTERSPEECH2024
内容提要
西工大音频语音与语言处理研究组与喜马拉雅合作提出了鲁棒零样本语音转换模型Vec-Tok-VC+,通过渐进式损失约束和残差增强方法解决了不匹配问题和语义信息损失,提升了转换的自然度和相似度。该模型在实验中表现优于其他模型。
延伸解读
训练与推理不匹配的解决思路
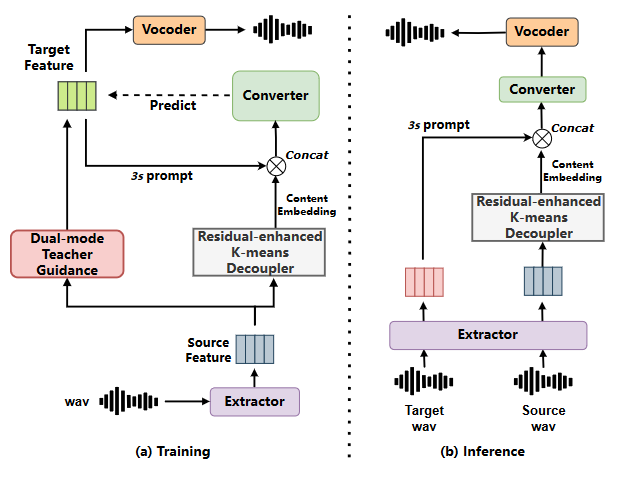
零样本语音转换中,训练时模型重建同一语句,而推理时需转换不同语句的说话人,这种不匹配会损害性能。Vec-Tok-VC+通过教师指导的双模式训练策略,在训练中模拟推理时的转换过程,使模型更适应实际转换场景。消融实验表明,去除教师模块后性能下降,验证了该策略的有效性。
残差增强解耦如何提升自然度
传统K-Means量化在解耦内容与音色时,会损失部分语义和发音细节,导致转换语音自然度不足。Vec-Tok-VC+引入残差增强的K-Means解耦器,通过两级聚类(1024类和256类)分别捕捉主要内容和细节残差,补充了韵律和发音变化信息。消融实验显示,去除残差聚类后自然度显著降低,说明该设计对保持语音自然度至关重要。
多码本渐进式约束的作用
转换器隐层从底层到顶层信息丰富度递增,Vec-Tok-VC+利用这一特点,在隐层中引入多码本渐进式损失约束,使用不同粒度的K-Means聚类(2048、4096、8192类)生成目标离散索引,分别约束第2、4、6层输出,使模型由粗到细逐步拟合目标语音。消融实验表明,去除该约束会导致自然度和相似度下降,证实其有助于提升转换质量。
模型鲁棒性与跨语种表现
Vec-Tok-VC+在跨语种零样本转换中虽性能有所下降,但仍优于对比模型,显示出对多语种场景的适应能力。此外,实验发现模型对带噪源语音也表现出鲁棒的转换能力,这得益于残差增强解耦和教师指导训练对信息损失的减轻。这些特性使其更接近实际部署需求,但跨语种性能下降仍是未来可改进的方向。
Q&A
Vec-Tok-VC+模型的主要创新点是什么?
Vec-Tok-VC+模型通过双模式训练策略结合渐进式损失约束和残差增强方法,解决了训练和推理之间的不匹配问题,减轻了语义信息损失,提升了转换的自然度和相似度。
Vec-Tok-VC+在实验中表现如何?
在实验中,Vec-Tok-VC+在自然度和相似度方面均优于其他对比模型,显示出其在零样本语音转换中的有效性。
零样本语音转换的主要挑战是什么?
零样本语音转换的主要挑战在于对未见说话人音色的建模以及解耦源语义内容的过程。
Vec-Tok-VC+模型如何处理语义信息损失?
该模型通过残差增强的K-Means聚类来编码内容的残差信息,从而减轻解耦过程中的语义信息损失。
Vec-Tok-VC+模型的训练数据来源是什么?
模型的训练数据包括19,000小时的中英语音数据,涵盖开源英文数据集LibriTTS、Gigaspeech,以及内部收集的中文有声书数据集。
Vec-Tok-VC+模型的应用场景有哪些?
该模型可应用于隐私保护、电影配音等场景,旨在将源说话人的语音转换为任意目标说话人的音色,同时保留语言内容。
