


迭代器与生成器:实现内存高效处理
内容提要
Python迭代器和生成器可实现内存高效的数据处理。以日志文件为例,列表推导会一次性加载全部记录导致内存溢出,而生成器函数和生成器表达式每次只处理一条记录,保持惰性求值。建议用文件对象逐行读取,将解析、过滤等步骤写成生成器,仅在输出时按固定大小分批物化,并用tracemalloc测量峰值内存验证惰性。
延伸解读
惰性求值必须贯穿整个管道
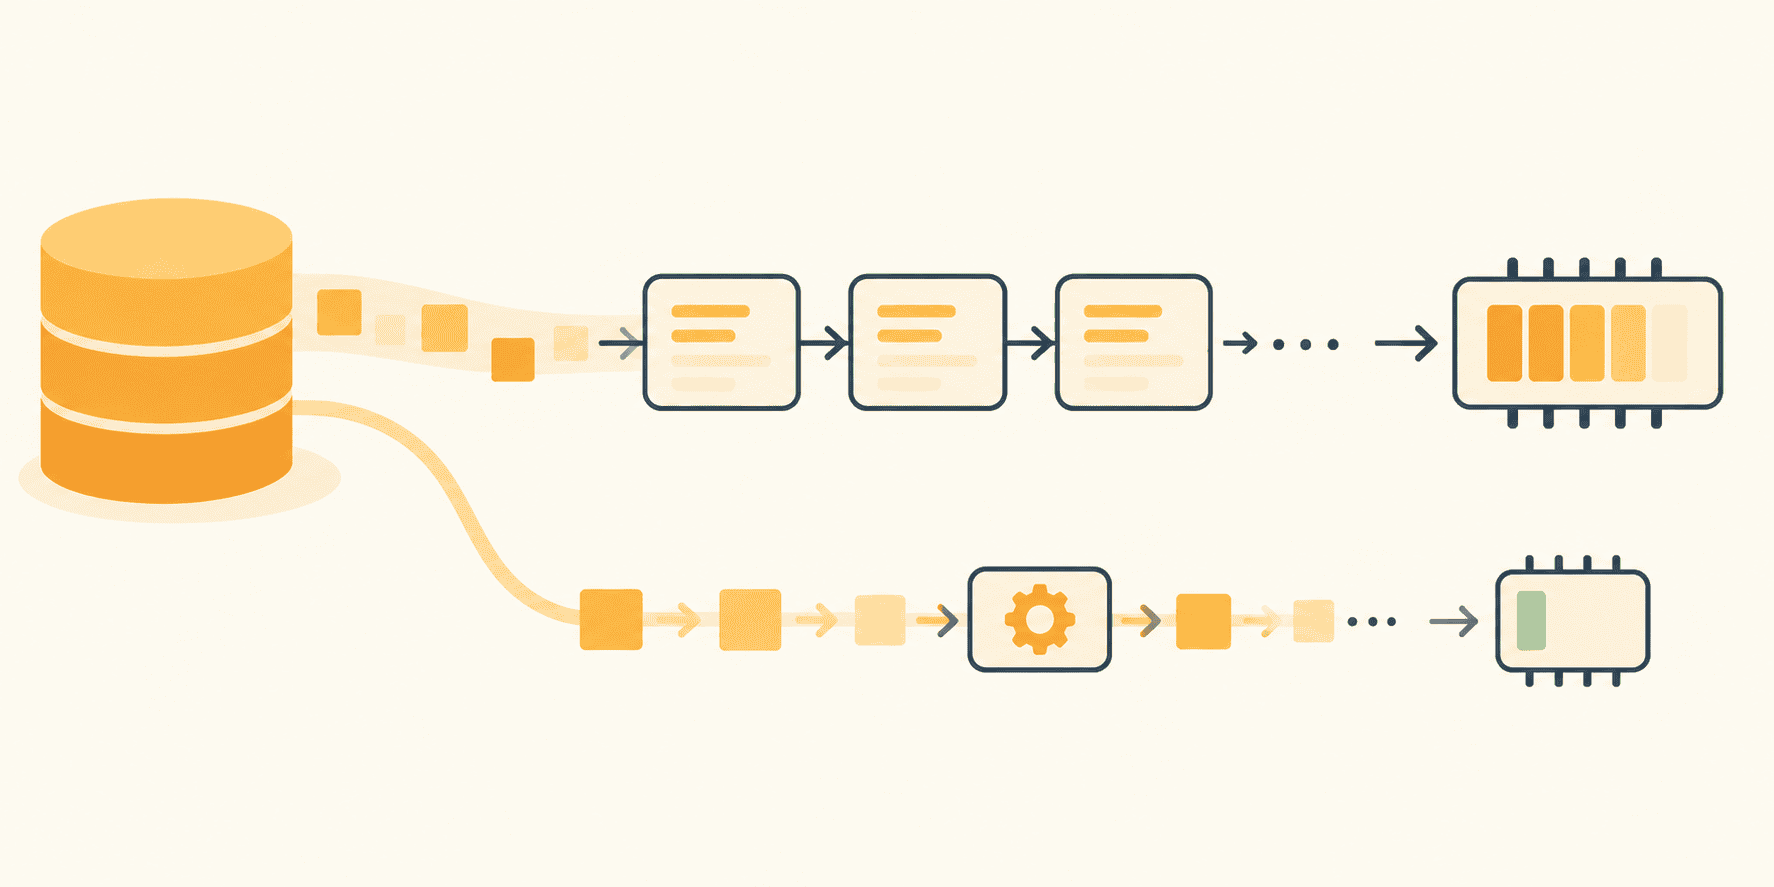
文章强调,生成器管道中只要有一个环节提前物化数据,整个内存优化就会失效。例如,在生成器链中调用 list()、sorted() 或构建字典累积,都会将流式数据重新变成完整列表。因此,从文件读取到最终输出,每一步都应保持惰性,避免中间步骤引入急切求值。
用 tracemalloc 验证内存峰值
文章建议使用 tracemalloc 测量峰值内存,而不是仅看当前内存。峰值决定了进程在容器限制或 OOM killer 下的生存能力。通过对比急切版本和流式版本的峰值,可以确认管道是否真正惰性。但需注意,tracemalloc 只跟踪 Python 分配器,C 扩展或系统缓存不在其视野内。
在边界处按固定大小批量物化
流式处理并非完全避免物化,而是在输出边界按选定大小分批。文章推荐使用 itertools.batched(Python 3.12+)或基于 islice 的配方,每次只取固定数量的记录组成元组,处理完即释放。这样内存占用与文件大小无关,只与批次大小有关,且函数名应明确表示这是有意为之的物化点。
识别无法流式处理的任务
文章指出,某些任务本质上需要全部数据,例如全局排序、精确去重或计算百分位数。这些操作无法通过生成器管道解决,强行流式只会把内存问题推迟到排序或去重步骤。此时应考虑近似算法或外部磁盘排序工具,而不是在管道末尾添加 sorted() 或累积字典。
Q&A
为什么用列表推导处理大日志文件会导致内存溢出?
列表推导会一次性构建包含所有记录的列表,例如 `records = [parse(line) for line in f]` 会立即将文件中的每一行解析并存入内存。当文件达到 9GB 时,所有记录同时存在,导致 MemoryError。
Python 的迭代器协议是如何支持惰性流式处理的?
迭代器协议要求对象实现 `__iter__()` 和 `__next__()` 方法。`__iter__()` 返回迭代器本身,`__next__()` 每次产生下一个元素,直到没有元素时引发 `StopIteration`。迭代器是一个只能前进的游标,不需要一次性加载所有数据,因此可以逐条处理大文件。
如何用生成器函数构建多阶段数据处理管道?
将每个处理步骤写成包含 `yield` 的生成器函数,例如 `read_lines` 逐行读取文件,`parse_records` 解析每行并 yield 字典,`only_level` 过滤特定级别。这些阶段通过生成器表达式连接,每次只传递一条记录,保持整个管道惰性。
生成器表达式和列表推导在内存使用上有什么区别?
列表推导用方括号,会立即构建完整列表,占用大量内存;生成器表达式用圆括号,返回一个生成器对象,每次请求时才计算一个元素,内存占用恒定。例如 `(r for r in errors if ...)` 不会一次性生成所有结果。
如何用 tracemalloc 验证管道是否真正惰性?
使用 `tracemalloc.start()` 开始跟踪,运行管道后调用 `tracemalloc.get_traced_memory()` 获取当前和峰值内存,最后 `tracemalloc.stop()`。峰值内存是关键指标,惰性管道的峰值应远低于急切版本,且不随文件增大而显著增长。
在管道中哪些操作会破坏惰性并导致内存问题?
常见破坏惰性的操作包括:`list(rows)` 将整个流物化为列表;`sorted(rows)` 需要所有数据才能排序;用字典累积所有记录(如按 request_id 去重);以及某些库调用如 `json.dumps(list(rows))` 或构建 DataFrame 时内部物化。这些操作会使内存占用随数据量增长。
如何安全地在管道末端进行批量物化?
使用 `itertools.batched()`(Python 3.12+)或基于 `islice` 的自定义函数,按固定大小(如 1000)分批取出记录。每批是一个元组,处理完后立即释放,内存占用恒定。批量大小应显式指定,且上游保持惰性。
