
帧、镜头与场景:为AI工作流构建视频结构
内容提要
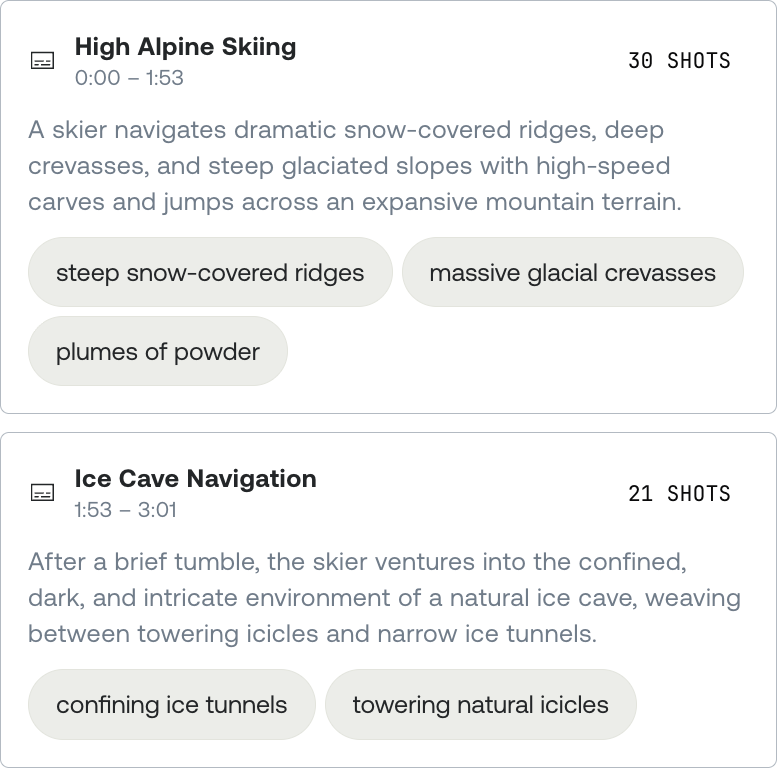
本文以滑雪影片《The Ultimate Run》为例,介绍视频AI的分层处理工作流:帧处理单幅画面,镜头识别画面切换,场景聚合语义段落,关键时刻和章节面向观众。核心原则是按需选取最小视频片段,避免逐帧分析的高成本,并根据内容类型灵活组合信号。
延伸解读
分层处理:从帧到章节的粒度选择
文章以滑雪影片为例,说明视频AI工作流需根据问题选择最小分析单元。帧适合单幅画面判断,镜头识别视觉切换,场景聚合语义段落,关键时刻和章节面向观众。这种分层避免了逐帧分析的高成本,同时确保模型获得足够上下文。读者可借鉴此思路,在设计视频分析流程时先明确问题类型,再选取对应粒度,而非盲目处理所有帧。
内容类型决定信号组合
文章强调,不同视频内容需要不同的信号组合。例如,快节奏滑雪影片依赖镜头变化和视觉信号,而播客等语音为主的内容则更依赖转录文本。工作流应自适应内容类型,而非固定模式。这提示开发者,在构建视频AI应用时,需根据内容特征动态调整分析策略,以平衡准确性与效率。
检索粒度:没有通用答案
文章指出,嵌入检索同样面临粒度选择:返回整个视频、场景、镜头还是单帧,取决于具体需求。粗粒度适合推荐,细粒度适合精确定位。没有 universally correct 的检索粒度,需根据应用场景权衡。读者在设计视频搜索功能时,应明确用户意图,选择既能理解又足够精确的检索单元。
Q&A
视频AI处理中,帧、镜头和场景分别代表什么?
帧是单幅画面,用于回答单个瞬间的问题;镜头是两次剪辑之间的连续镜头,用于识别画面切换;场景是语义上相邻镜头的聚合,用于定位完整的叙事段落。
为什么视频AI工作流要避免逐帧分析?
逐帧分析成本高、速度慢,因为大部分帧不包含新信息。例如一小时30帧/秒的视频有108,000帧,全部传给视觉模型会浪费资源。应选取最小必要片段,只提供能改变答案的信息。
在视频AI中,什么时候应该使用镜头(shot)而不是帧(frame)?
当需要识别画面切换或视觉状态变化时使用镜头。镜头能捕捉到固定采样可能跳过的短暂角度、跳跃或地形变化,提供有序的边界和代表图像。
场景(scene)和章节(chapter)在视频AI工作流中有何不同?
场景描述媒体中语义上属于一起的片段,基于视觉和叙事边界;章节则面向观众导航,将视频划分为命名部分,其边界取决于用户想用结果做什么。一个片段可以同时是场景、属于某章节并包含关键时刻。
视频AI工作流如何组合使用帧、镜头、场景等构建块?
工作流通常从最便宜的信号开始缩小搜索范围,再按需添加细节。例如缩略图选择先用镜头划分视觉状态,再用帧提供候选图像;关键时刻发现先用镜头创建候选范围,再用转录和帧评估。
视频检索中,嵌入(embeddings)的粒度选择为什么重要?
嵌入用于按语义查找相关内容,但粒度选择影响结果可用性。返回整个视频可能不够精确,返回单帧可能缺乏上下文。需要根据用途选择合适粒度,如资产、转录范围、视觉跨度或多模态块。
