


反超Gemini之后,Karpo新作再开源,浏览器Agent速效双赢
内容提要
MachinePulse AI 开源决策模型 Karpo Decision 31B,专为 Agent 提供高频低延迟决策,单次前向推理即可输出候选概率,速度比 Gemini 快近 6 倍,成本极低。团队还开源了 karpo-browser 浏览器框架、27B Act 模型及评测集 KBB,采用 System 1 与 System 2 分工,在网页任务上兼顾成功率、速度与成本,并支持多尺寸模型部署。
延伸解读
决策模型为何独立成层
文章指出,Agent 每次选工具、筛结果都调用通用大模型逐字生成答案,既慢又费 Token。Karpo 将这类高频判断交给专门模型,单次前向推理直接输出候选概率,输出 Token 数为 0。这提示开发者:在 Agent 工作流中,可把“判断”与“生成”拆开,让通用模型负责规划与复杂推理,决策模型处理琐碎选择,从而降低延迟与成本。
System 1 + System 2 的分工价值
karpo-browser 采用快慢双模型架构:通用大模型负责理解需求、拆解任务,Karpo Decision 27B Act 负责页面上的点击、输入等动作决策。实测中约 78% 的网页操作由决策模型完成,却只占运行耗时的 14% 和模型成本的 13%。这说明将高频操作下沉到专用小模型,能在保持成功率的同时显著压缩开销,为浏览器 Agent 的规模化部署提供参考。
开源与评测集降低落地门槛
MachinePulse 不仅开源了 0.8B 到 31B 共 6 款决策模型,还开放了 karpo-browser 框架、27B Act 模型权重及 KBB 评测集。KBB 覆盖 584 个真实网站、23,075 步操作,支持离线回放测试每一步动作选择。对开发者而言,这意味着无需从零搭建浏览器 Agent,可通过 MCP 接入现有工具链,并利用评测集验证决策质量,减少自研试错成本。
泛化与校准比单项分数更关键
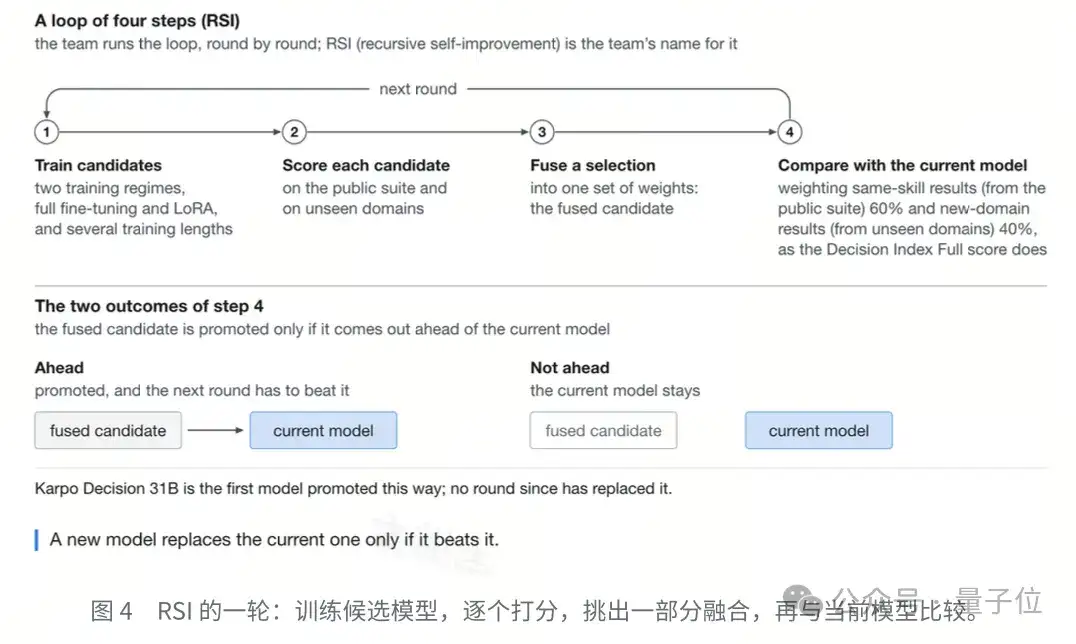
文章提到,Karpo 训练中曾出现公开测试成绩上升、陌生领域准确率下降的偏科苗头。团队通过 RSI 框架和模型融合,将陌生领域准确率从 70.7% 回升至 72.3%,且参数量与推理开销不变。同时,RLCD 训练使校准误差降至 2.3%,让模型输出的概率更可信。这提醒读者:评估决策模型时,除看榜单分数,还应关注跨场景泛化能力和置信度校准,以便设置合理的自动执行阈值。
Q&A
Karpo Decision 31B 是什么?它主要解决什么问题?
Karpo Decision 31B 是 MachinePulse AI 开源的一款决策模型,专为 Agent 提供高频、低延迟的决策能力。它通过单次前向推理直接输出候选选项的概率,无需逐字生成答案,从而让 Agent 的每一步判断更快、更省成本。
Karpo Decision 31B 在速度和准确率上有什么具体表现?
在《城市扫描仪》挑战中,Karpo 仅用 2.6 秒完成 36 场活动的筛选,准确率 100%,而 Gemini 3.5 Flash 用了 14.96 秒,Karpo 快近 6 倍。在 Decision Index 评测总榜上,它以 73.9 的 Full 分荣登榜首,校准误差仅 2.3%。
karpo-browser 框架是如何工作的?它采用了什么架构?
karpo-browser 采用 System 1 + System 2 的快慢双模型分工架构。System 2(通用大模型)负责理解需求、拆解任务和规划;System 1(Karpo Decision 27B Act 模型)负责在网页上执行具体操作,如选择输入框、点击按钮等。框架本身负责读取网页、执行操作并处理异常。
使用 Karpo 的决策模型能节省多少成本?
根据 JevBench 的 GPU 成本估算,Karpo 每 1000 次决策仅需约 0.025 美元(约 0.17 元),相当于 1 美元可运行近 4 万次决策。在浏览器任务中,单任务模型成本仅 0.096 美元(约 0.64 元),是 Claude Fable 5.2 + Claude Code 方案成本的十三分之一。
Karpo Decision 31B 如何实现一次推理输出概率?
Karpo 设计了专门的 Readout Head,为候选选项安排编码,并在输入后放置读取标记。模型读完输入后,Readout Head 在该位置为各选项打分并转换为概率,整个过程只需一次前向推理,输出 Token 数为 0。同时,Branch Attention 机制支持 256K 上下文,将共享内容只计算一次,各题独立作答,提升效率。
Karpo 模型在泛化能力方面做了哪些优化?效果如何?
团队引入 RSI(递归自我改进)训练框架,通过 Model Fusion 将不同 Checkpoint 的权重平均,融合早期模型的泛化能力和后期模型的专精能力。融合后,公开测试成绩保持 75.1,陌生领域准确率从 70.7% 提升到 72.3%,且模型结构、参数量和推理开销不变。
Karpo 开源了哪些模型和工具?开发者如何获取?
MachinePulse 开源了 0.8B、2B、4B、9B、12B 和 31B 共 6 款 Karpo Decision 全尺寸模型,以及 Karpo Decision 27B Act 模型、karpo-browser 框架和评测集 KBB。开发者可以在 Hugging Face 和 GitHub 上获取相关资源。
