


赛义德的快艇比喻说对了一半:若美国全面暂停前沿AI研究,刹住的是自己
内容提要
文章借美国新当选穆斯林参议员赛义德的“快艇拖滑水者”比喻,讨论美国全面暂停前沿AI研究的影响。作者认为该比喻只说对一半:美国封锁蒸馏与推理过程确实会拖慢中国,但中国仍可依靠人力标注、海量用户数据、更聪明的模型及开源推理链追赶;真正被拖慢的反而是美国自身,开放思维链还可能成为行业标准。
延伸解读
比喻的政治效力与政策风险
赛义德的“快艇拖滑水者”比喻之所以能换来选票,是因为它把复杂的AI竞争简化为一个直观画面:美国加速反而拖快中国,停下来就既安全又爱国。文章指出,选民关心的是饭碗和电费,不需要懂蒸馏或思维链。但比喻好记不等于政策可行,全面暂停前沿AI研究的一刀切,管的人省事了,代价却由美国自己的公司、工程师和投资人承担。
封锁蒸馏:门关上了,但窗户还开着
美国通过喊人、立规矩、藏过程、罚钱封号四招,大幅提高了蒸馏门槛。Anthropic公告称可扒走的数据少了90%到99%,推理内容掉了10倍到100多倍。但文章认为封锁改变的是获取下一颗“开心果”的边际成本,而非彻底封死。中国仍可依靠人力标注、海量用户数据、更聪明的模型以及开放推理链追赶,只是过程更曲折、成本更高。
高端标注差距与追赶的现实路径
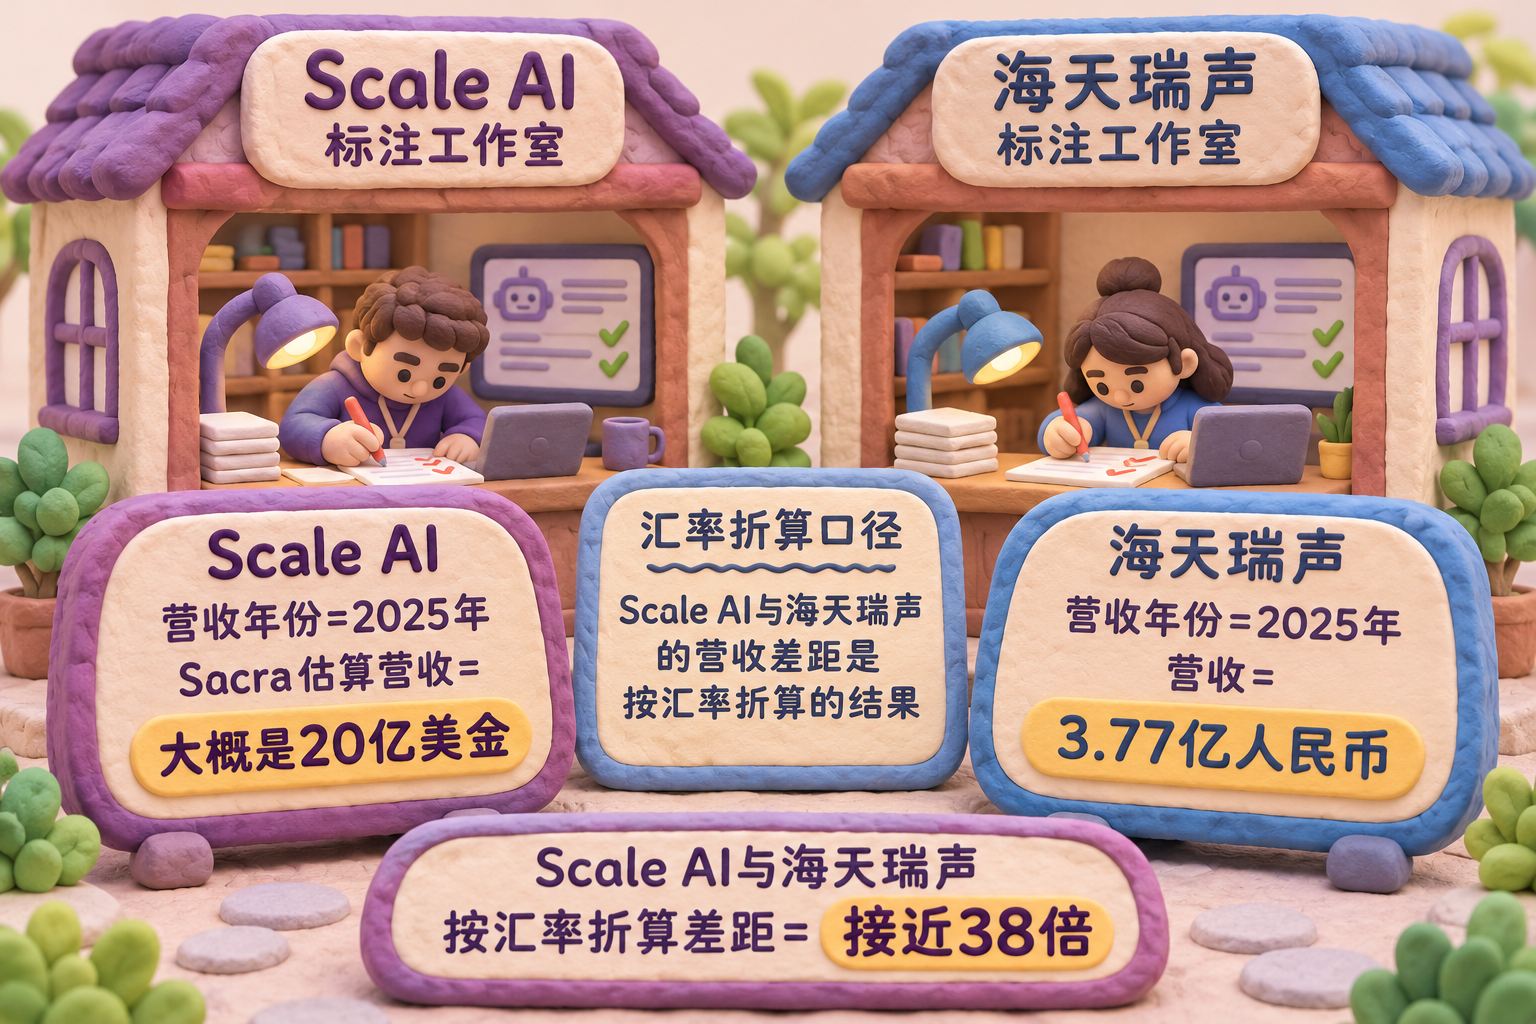
文章对比中美标注行业:美国Scale AI 2025年营收约20亿美元,中国最大标注公司海天瑞声约3.77亿元人民币,差距接近38倍;高端专家标注公司如Surge AI收费更高。中国高端数据公司UniPat和Humanlaya刚起步。但中国有组织人力标注的优势,且美国数据公司仍在向中国实验室出售训练数据,中国头部6家实验室一年在美国数据商身上花约5亿美元。
开放思维链可能反向成为标准
美国闭源模型藏起推理过程,而DeepSeek、Kimi、智谱GLM等中国模型大多开放推理链,权重也开源。文章认为,如果用的人多了,开放推理链可能成为事实上的行业标准,届时美国新公司反而可能去蒸馏中国模型。已有迹象:Cursor的Composer 2被发现在接口中标注kimi-k2p5;日本乐天Rakuten AI 3.0和Sakana AI的Namazu也被指基于DeepSeek开源模型。
Q&A
赛义德是谁?他提出的快艇比喻具体是什么意思?
赛义德是美国新当选的穆斯林联邦参议员,他在竞选时主张全面暂停前沿AI研究。他用快艇拖滑水者比喻中美AI竞争:美国是快艇,中国是后面的滑水者,美国跑得越快,中国模仿得越快,所以美国应该停下来。
美国采取了哪些措施来防止中国公司蒸馏其大模型?效果如何?
美国主要采取四招:喊人(政府点名中国公司)、立规矩(API条款禁止开发竞争模型)、藏过程(隐藏推理过程,只给摘要)、罚钱封号(封禁批量账号并收费)。效果上,Anthropic公告称蒸馏者能扒走的数据减少了90%到99%,推理内容掉了10倍到100多倍。
中国在AI追赶中手里有哪些牌?
中国至少有四张牌:一是大量受过教育的人力可组织起来做标注;二是海量用户行为数据可作为现成题库;三是现有模型已足够聪明,能用于数据清洗和强化学习;四是现成的壳子(如泄露的源码)可借鉴。
为什么说开放的思维链可能成为行业标准?
因为中国主要模型(如DeepSeek、Kimi、GLM)的推理链大多开放,而美国闭源模型隐藏推理过程。如果开放推理链被广泛使用,就可能成为事实标准,甚至美国新公司也可能去蒸馏中国公司的推理链。已有案例:Cursor的Composer 2被发现在接口中标注kimi-k2p5。
文章认为美国全面暂停前沿AI研究最终会拖慢谁?
文章认为,美国全面暂停前沿AI研究最终拖慢的是美国自己。因为蒸馏的门美国公司已自己封上,数据封不死,中国仍可追赶;而一刀切暂停只会让美国自己的公司、工程师和投资人承担代价。
中国在高端数据标注方面与美国差距有多大?
差距很大。美国占全球数据标注市场约30%-40%,头部公司Scale AI 2025年营收约20亿美元,而中国最大标注公司海天瑞声2025年营收仅3.77亿人民币,相差近38倍。高端标注公司如Surge AI收费是Scale的2-5倍,中国刚起步。
