从 AI 编码到团队交付:企业 AI-Native 的落地路径
内容提要
企业引入AI编码后,瓶颈从写代码转向需求、协作与验收。文章提出AI-Native落地路径:以Token治理保障接入与度量,用Spec明确意图与责任,建设Agent可读的上下文,将执行、验证和异常处理接成闭环,并沉淀为团队可复用能力。落地分两条线:AI-Native产研与Agentic业务职能,共享底座,先试点再扩大自主范围。
延伸解读
AI-Native 不只是工具升级
文章指出,AI-Native 体现为产品、组织和认知方式的变化。产品探索从模型能力边界出发,组织围绕人与 Agent 的组合分工,判断依靠一手信息和亲自验证。这意味着企业引入 AI 编码工具后,若只关注编码速度,可能忽略需求、协作与验收等环节的瓶颈。真正的转型需要从这三个维度同步推进,而非仅采购工具。
Token 治理:从投入可见到产出可衡量
Token 治理是 AI-Native 落地的基础主线。文章建议先记录速度、质量、自主程度和成本四类基线,并统一接入、管理订阅资源、降低配置门槛、建设管理视图。关键是将 Token 消耗与任务完成、返工等产出关联,避免单纯追求调用量或代码量。成本、使用率与质量需一起观察,才能推动预算分配和流程优化。
Spec 与 Agent Readable:明确意图与上下文
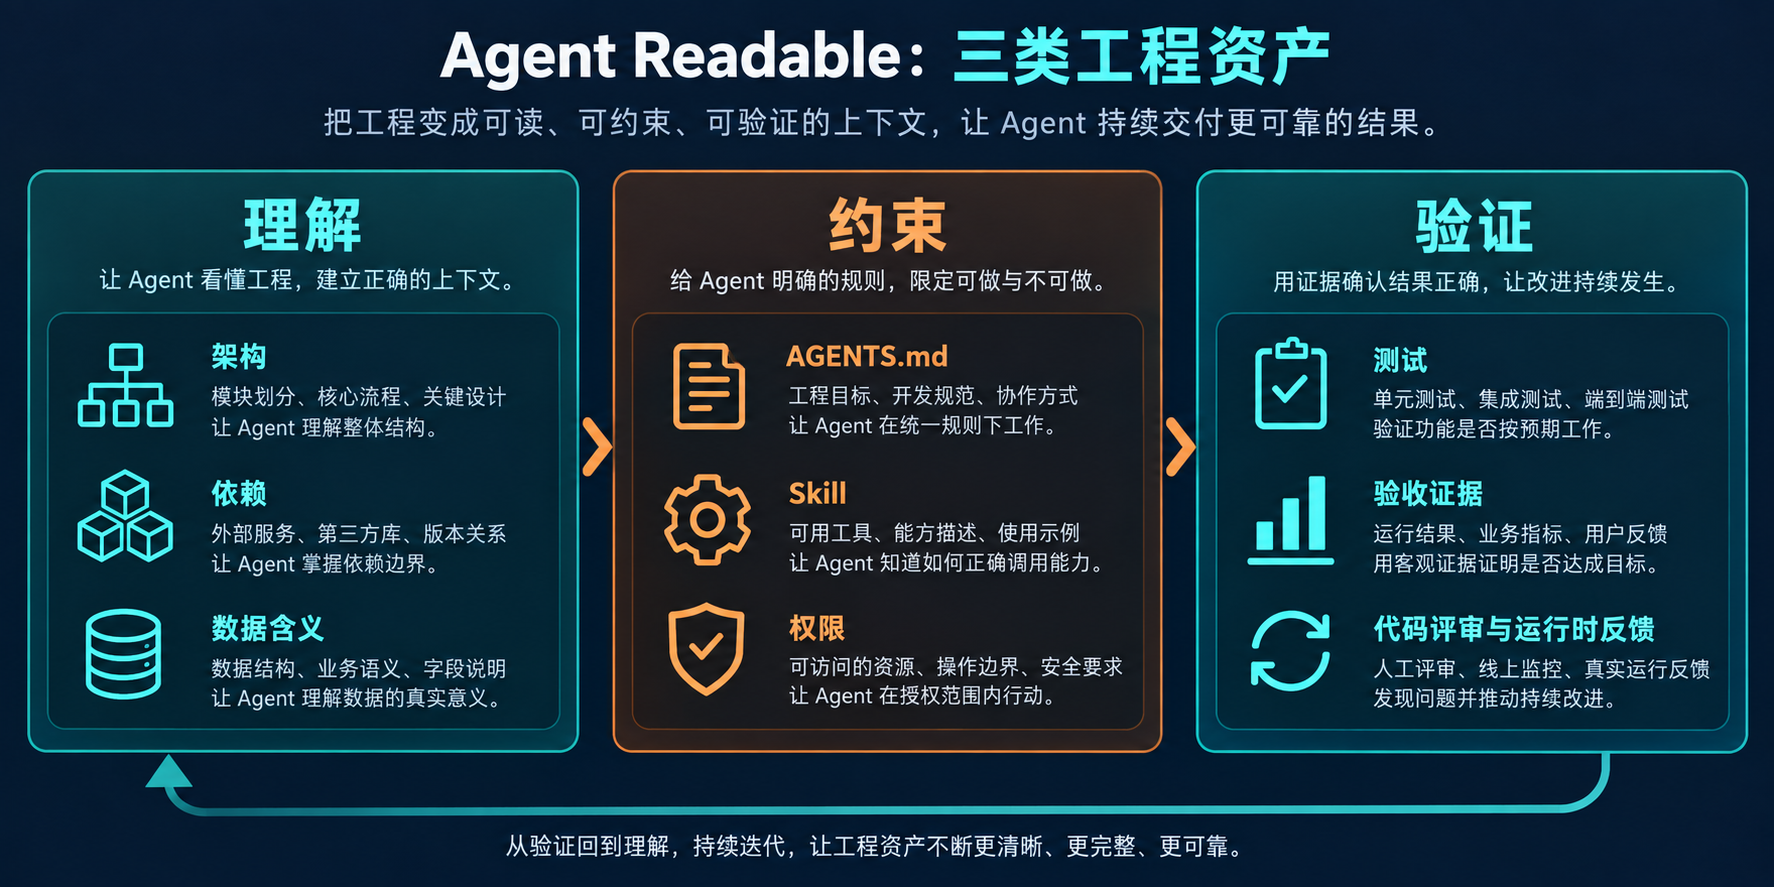
Spec 将业务决策转化为可追溯的交付依据,包含目标、规则、约束、验收标准和待决事项,并与代码一起版本化。Agent Readable 则要求代码、数据和流程能被 Agent 理解和使用,通过理解资产、约束资产和验证资产沉淀工程能力。两者结合,可减少需求歧义和重复解释,让 Agent 在授权范围内执行并验证结果。
闭环与试点:控制自主执行的风险
扩大 Agent 执行范围需要闭环设计,包括编码前后检查、异常升级、重试上限和人工介入节点。文章建议先选择一个依赖清楚、验收可执行的仓库和一类边界明确的任务,用一个月左右试点,记录基线、补齐基础、连接闭环并评估复用。只有收益和质量得到验证,再逐步扩大自主权限,避免盲目推进导致审核和返工成本上升。
Q&A
企业引入AI编码后,为什么交付流程反而出现新的瓶颈?
因为编码速度提升后,原来被掩盖的需求、协作与验收问题会显现出来。例如产品口径未定、Agent不了解服务间隐含依赖、测试通过但验收标准遗漏关键场景,导致等待、返工和协作成本增加。
AI-Native在企业内部有哪两条落地线?它们的关系是什么?
两条线是AI-Native产研(Vibe Coding的工程化)和Agentic业务与职能。它们用户和交付物不同,但共享底座,包括模型接入与Token治理、Agent Readable上下文、权限与审计、测试与评审、知识治理。应分别试点、共享底座,再通过统一指标比较交付价值。
Token治理应该关注哪些指标,如何避免只优化Token消耗?
Token治理应关注使用覆盖、资源消耗和交付质量三个视角。避免只把Token消耗、AI生成代码占比或PR数量当作成绩,而应关联任务是否完成、是否返工,逐步从“花了多少Token”走到“完成一个合格任务花了多少总成本”。
一份可用于执行的Spec至少应包含哪些内容?
至少应包含:目标与非目标、业务规则(术语、指标口径、权限和异常场景)、工程约束(接口兼容性、依赖关系、性能及数据边界)、验收标准(什么证据能证明任务完成)、待决事项(哪些问题仍需确认及由谁决定)。Spec应与代码一起版本化。
如何让Agent读懂项目并保持上下文有效?
需要建设三类工程资产:理解资产(项目为什么存在、模块协作、关键依赖)、约束资产(AGENTS.md、Skill等规则)、验证资产(测试、验收样例、检查脚本)。同时企业数据需要语义与权限,知识要有生命周期,从执行中发现经验,验证后沉淀,失效后退出活跃上下文。
自主执行闭环中,必须定义哪些停止或升级条件?
必须明确:需求或权限不清楚时向谁升级;连续验证失败时最多重试多少轮;时间或费用达到上限时如何停止并交接;涉及高影响变更时在哪个节点由人决定;执行失败后如何保留现场、恢复状态或回滚。
企业如何开始一个AI-Native试点?
先选择一个依赖相对清楚、验收能够执行的仓库,以及一类边界明确的任务,用一个月左右试点。按四件事推进:记录现状(任务范围、责任人、质量基线)、补齐基础(Spec、上下文入口、测试与权限边界)、连接闭环(编码前后检查、人工升级和停止条件)、评估与复用(比较周期、质量和总成本,复制有效经验)。
