

从零学习 Hypothetical Document Embeddings (HyDE) - 1
内容提要
这篇论文介绍了一种评估RAG技术的方法,提到HyDE和LLM re-rank可以提高检索精度。RAG是一种基于检索的生成式模型,结合了检索和生成的优点。HyDE是一种基于RAG的模式,通过比较真实文档和假设文档的差异来提高模型的泛化能力。将HyDE和RAG结合可以提高生成性能和可靠性。
延伸解读
HyDE 如何弥补 RAG 的检索短板
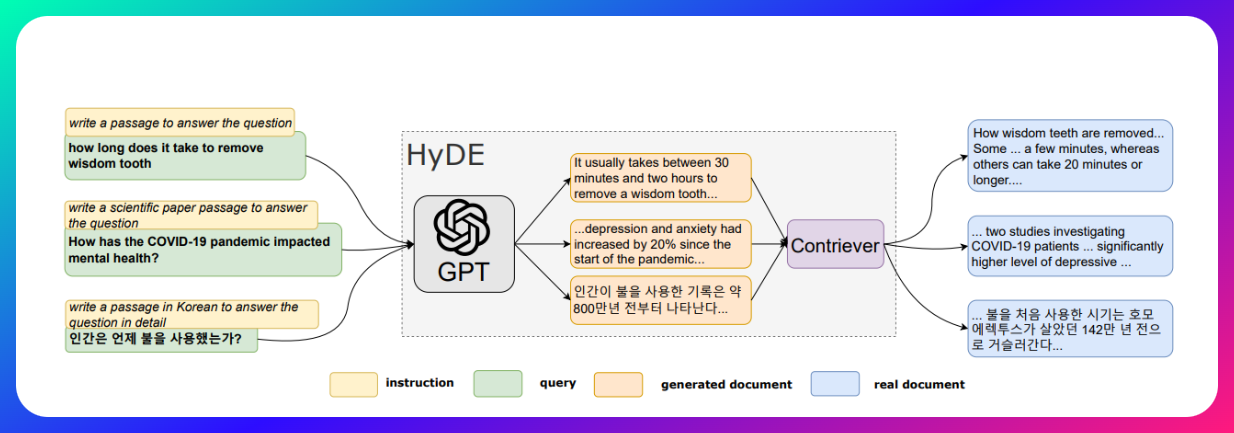
当用户提问与知识库表述不一致时,传统 RAG 可能检索不到相关信息。HyDE 通过 LLM 先生成假设文档,再用其嵌入进行检索,从而跨越表述差异。这种方法不依赖知识库中存在完全匹配的文本,而是利用生成内容捕捉语义,帮助 RAG 处理知识库中不存在的数据,提升泛化能力。
HyDE 与 RAG 的协同效应
HyDE 生成的文档向量富含语义和上下文信息,能提升 RAG 生成内容的相关性和连贯性。同时,RAG 借助外部知识库增强事实性,HyDE 则通过语义约束进一步确保输出可靠。两者结合,既扩展了知识边界,又提高了生成结果的准确性,尤其适合问答系统和对话系统等场景。
从概念到实践:HyDE 的实现路径
文章指出,HyDE 的工程实现未必复杂,可借助 LangChain 等框架快速搭建。后续将以 LangChain 为例演示实际应用,甚至可能从零手搓。对于开发者而言,理解 HyDE 的流程——LLM 生成假设文档、嵌入检索、再生成答案——是落地关键,而框架能降低实现门槛。
Q&A
HyDE是什么,它如何提高RAG模型的性能?
HyDE(Hypothetical Document Embeddings)是一种基于RAG模型的模式,通过生成假设文档并与真实文档比较,来提高模型的泛化能力和生成性能。
RAG模型的基本组成部分是什么?
RAG模型由检索器和生成器两部分组成,检索器从知识库中检索信息,生成器负责生成答案。
HyDE如何处理知识库中不存在的数据?
HyDE通过生成假设文档,帮助RAG模型处理知识库中不存在的数据,从而提高模型的准确性和可靠性。
RAG模型与传统大语言模型相比有什么优势?
RAG模型结合了检索和生成的优点,能够动态从外部知识库中检索信息,提高生成内容的准确性和可靠性。
HyDE的核心思想是什么?
HyDE的核心思想是通过对比真实文档和假设文档的差异,学习出更好捕捉文本语义和上下文信息的文档向量表示。
这篇文章将如何展示HyDE的实际应用?
文章将以LangChain为例,演示如何在实际应用中使用HyDE。
