


提示工程
内容提要
提示工程在不更新模型权重的前提下,通过提示引导大语言模型行为。基础方法包括零样本和少样本提示,示例选择与顺序影响显著。进阶方法包括指令提示、自洽采样、思维链、自动提示设计,以及检索增强和外部工具调用,可提升推理与知识任务表现。
延伸解读
提示工程为何依赖实验
文章指出提示工程是一门经验科学,不同模型对同一提示的效果差异很大,因此需要大量实验和启发式方法。这意味着没有通用的最佳提示,必须针对具体模型反复调整。同时,提示工程的目标是对齐和模型可控性,而非更新权重。
少样本提示的偏差与应对
少样本提示虽常优于零样本,但示例的选择和顺序会显著影响性能,甚至导致结果从接近随机到接近最优。文章提到多数标签偏差、近因偏差和常见词偏差。为减少偏差,可校准标签概率,或选择语义相似、多样且随机的示例。
思维链的适用条件与扩展
思维链通过生成推理步骤提升复杂推理任务的表现,但主要对参数量较大的模型(如超过500亿)效果明显,简单任务提升有限。自洽性采样可进一步通过多数投票提高准确率。此外,思维链可与外部检索结合,如Self-Ask、IRCoT和ReAct,以迭代方式获取信息。
检索增强的局限与工具调用
检索增强能引入最新或私有知识,但效果依赖检索和生成的质量。文章提到,即使通过搜索获取最新信息,模型在训练截止后的问题上表现仍较差,说明上下文信息与内部知识可能存在冲突。工具调用如Toolformer可让模型使用计算器、搜索等API,但尚不支持链式或交互式工具使用。
Q&A
什么是提示工程?它的核心目标是什么?
提示工程(Prompt Engineering),也称为上下文提示(In-Context Prompting),是指在不更新模型权重的情况下,通过设计提示来引导大语言模型(LLM)的行为,以获得期望的输出。其核心目标是实现对齐(alignment)和模型可控性(steerability)。
零样本提示和少样本提示有什么区别?
零样本提示是直接将任务文本输入模型并请求结果;少样本提示则提供一组高质量的演示(每个演示包含输入和期望输出),让模型更好地理解人类意图和期望的答案标准。少样本提示通常比零样本提示性能更好,但会消耗更多token,且当输入输出文本较长时可能触及上下文长度限制。
在少样本提示中,示例的选择和顺序为什么重要?有哪些技巧?
示例的选择和顺序会显著影响模型性能,可能导致从接近随机猜测到接近最先进水平的变化。选择示例时,可以选用与测试样本语义相似的示例(如通过k-NN聚类),或使用基于图的方法选择多样且具代表性的示例,或通过对比学习训练嵌入来选取示例。顺序方面,一般建议保持示例多样、与测试样本相关,并随机排序以避免多数标签偏差和近因偏差;当验证集有限时,可选择使模型预测不过于不平衡或过度自信的顺序。
思维链(CoT)提示是什么?它有哪些主要类型?
思维链(Chain-of-Thought, CoT)提示通过生成一系列短句逐步描述推理逻辑(即推理链或理由),最终得出答案。主要类型包括:少样本CoT,即用少量包含高质量推理链的演示来提示模型;零样本CoT,即使用“Let's think step by step”等自然语言语句鼓励模型先生成推理链,再以“Therefore, the answer is”提示输出答案。CoT对复杂推理任务和大模型(如超过500亿参数)效果更明显,简单任务提升有限。
自洽性采样(Self-Consistency Sampling)是如何工作的?
自洽性采样是使用温度大于0采样多个输出,然后从中选择最佳候选。选择标准因任务而异,通用方法是多数投票。对于易于验证的任务(如带单元测试的编程问题),可以直接运行解释器并用单元测试验证正确性。
检索增强是如何帮助大语言模型处理知识任务的?
检索增强通过先对知识库进行检索,然后将检索到的内容作为提示的一部分,帮助模型完成需要最新知识(超出预训练时间截止)或内部/私有知识库的任务。例如,使用Google搜索获取文档,提取文本并分割成段落,按TF-IDF余弦相似度排序,将最相关的段落用于提示中生成答案。这种方法可以提升开放域问答等任务的准确性,但性能仍受检索和生成步骤质量的影响。
自动提示设计有哪些方法?
自动提示设计将提示视为可训练参数,在嵌入空间通过梯度下降优化,如AutoPrompt、Prefix-Tuning、P-tuning和Prompt-Tuning。此外,APE(Automatic Prompt Engineer)通过搜索模型生成的指令候选池,根据评分函数选择最佳候选;还有augment-prune-select三步骤自动构建思维链提示,以及基于聚类技术采样问题并生成推理链的方法。
Toolformer是什么?它是如何训练使用外部工具的?
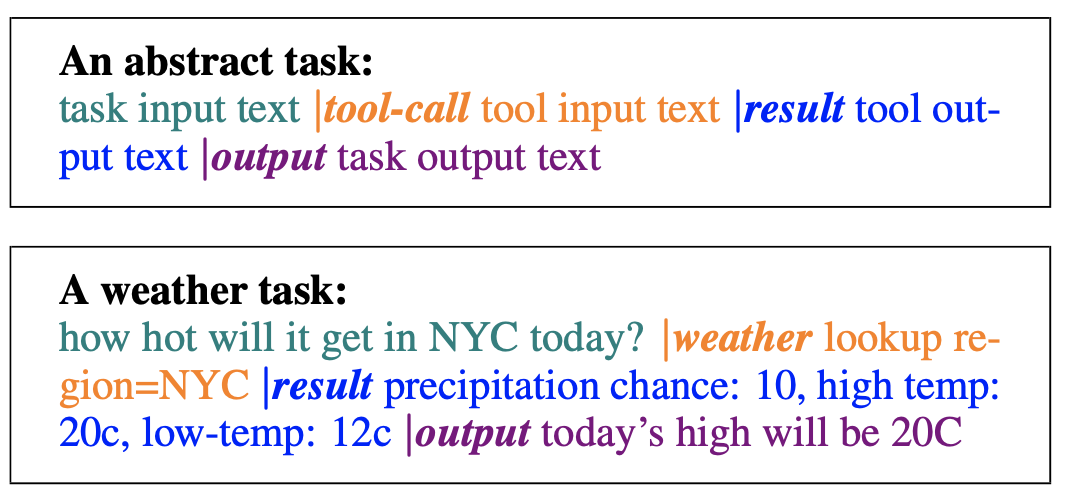
Toolformer是一个能以自监督方式使用外部工具(通过简单API)的语言模型,每个API只需少量演示。其工具箱包括计算器、问答系统、搜索引擎、翻译系统和日历。训练过程:首先用预训练LM通过少样本学习标注数据集中的潜在API调用;然后基于API调用是否有助于模型预测未来token进行过滤(计算有无API结果时的损失差,保留超过阈值的调用);最后在标注数据集上微调LM。推理时,解码直到模型产生“→” token,表示接下来期望API响应。
