
部署前规划你的工业物联网数据表规模
原文英文,约200词,阅读约需1分钟。
📝
内容提要
该文介绍TimescaleDB连续聚合的刷新机制,重点讲解失效跟踪、回看窗口及两个偏移量参数,用于处理迟到数据,避免聚合桶数据过期。
🔎
延伸解读
连续聚合刷新机制的核心:失效跟踪
TimescaleDB 连续聚合通过失效跟踪记录哪些聚合桶需要刷新。当底层数据发生变更时,系统会标记相关桶为失效,后续刷新仅处理这些桶,而非全量重算。这能显著降低计算开销,但要求正确配置刷新策略,否则失效桶可能长期未更新,导致查询结果滞后。
回看窗口与迟到数据处理
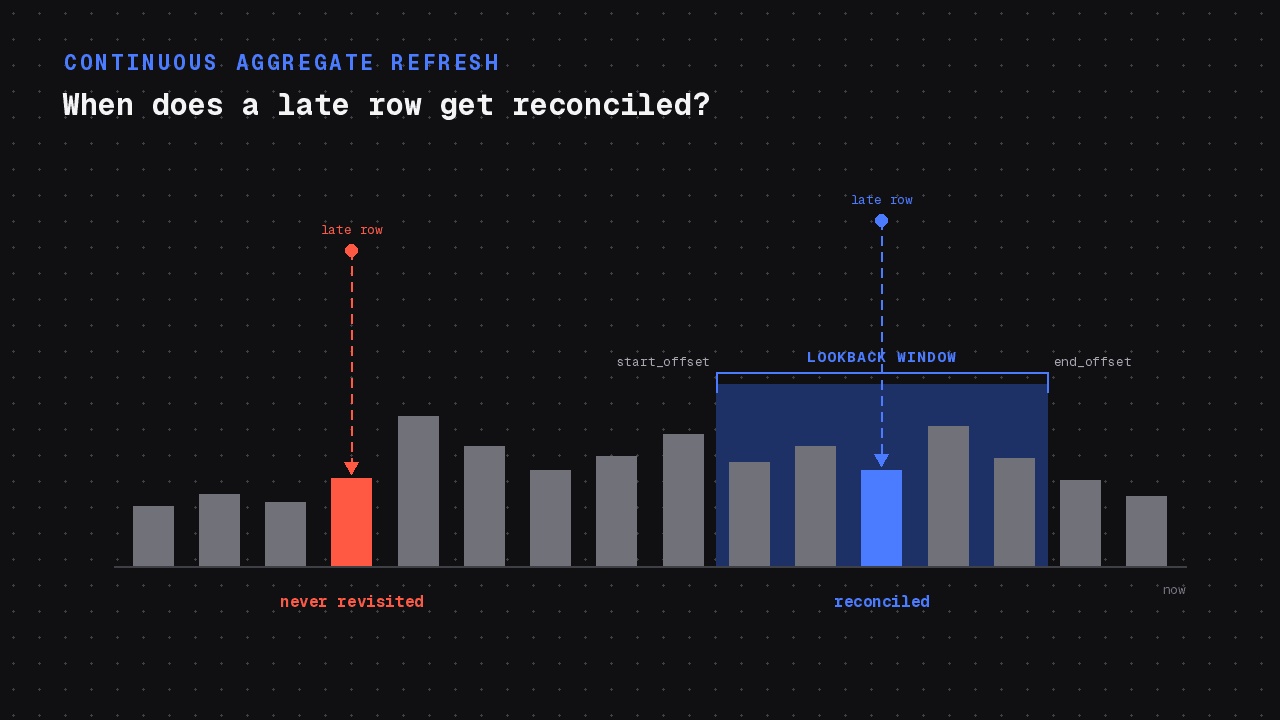
回看窗口定义了刷新时重新计算的时间范围,用于捕获迟到数据。若窗口设置过小,迟到数据可能被遗漏,造成聚合结果不准确;设置过大则增加刷新负担。需要根据数据到达延迟的分布来权衡,确保覆盖绝大多数迟到情况。
两个偏移量参数的作用与配置
文章提到两个偏移量参数,用于控制刷新边界,避免聚合桶数据过期。它们通常与回看窗口配合,调整刷新起点和终点,以平衡实时性与资源消耗。合理设置可减少不必要的重算,同时保证迟到数据被及时纳入。
❓
Q&A
TimescaleDB连续聚合的刷新机制中,失效跟踪是如何工作的?
失效跟踪用于记录哪些聚合桶因底层数据变更而需要刷新,确保连续聚合能及时更新。
什么是回看窗口?它在处理迟到数据时起什么作用?
回看窗口定义了在刷新连续聚合时,需要重新计算的时间范围,以覆盖可能迟到的数据,避免聚合桶数据过期。
连续聚合刷新中的两个偏移量参数分别是什么?它们如何防止聚合桶数据过期?
两个偏移量参数用于调整刷新时考虑的时间边界,确保迟到数据能被纳入聚合,从而防止聚合桶数据过期。
TimescaleDB连续聚合如何处理迟到数据?
通过失效跟踪、回看窗口和两个偏移量参数,连续聚合能识别并重新计算受迟到数据影响的聚合桶,保持数据最新。
为什么连续聚合需要刷新?不刷新会有什么问题?
连续聚合需要刷新以反映底层数据的变化,否则聚合桶中的数据会过期,导致查询结果不准确。
在工业物联网场景中,连续聚合的刷新机制如何帮助处理高频传感器数据?
连续聚合的刷新机制能高效处理高频传感器数据,通过失效跟踪和回看窗口确保聚合结果及时更新,支持实时监控和分析。
🏷️
