

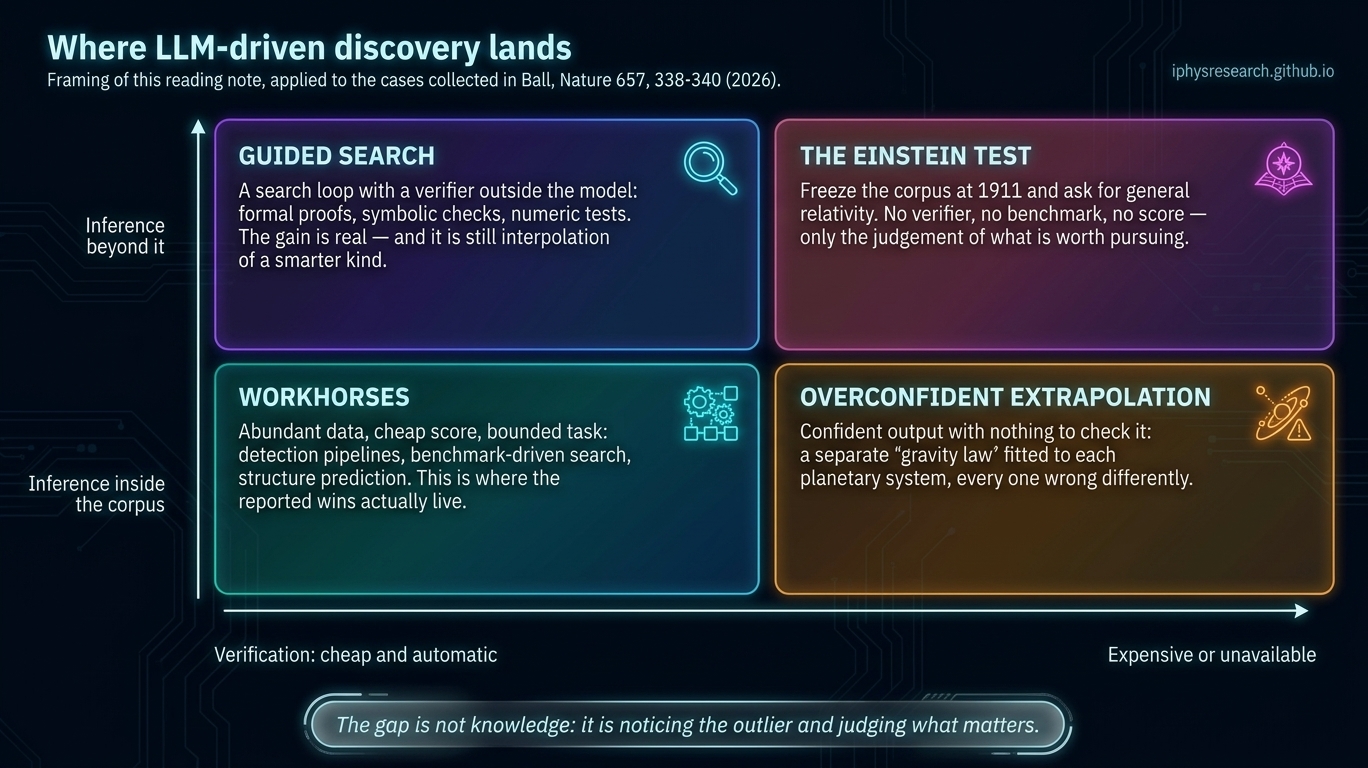

爱因斯坦测试究竟在测试什么
内容提要
Philip Ball在《自然》综述中指出,“爱因斯坦测试”类实验(用截止某年数据训练模型,检验其能否重推相对论)结果几乎全为负面。核心限制在于LLM缺乏溯因推理,只能归纳;虽能生成大量理论,却无法判断哪个正确或重要,且倾向平均掉关键“离群值”。作者认为应明确LLM边界,目标应是融合物理世界与数学结构的“数理世界模型”。
延伸解读
溯因推理:LLM 缺失的关键一跃
文章指出,爱因斯坦式的突破依赖溯因推理——从个别现象跳到原因,而非从数据中归纳规律。LLM 擅长归纳,却缺乏这种“跳跃”机制。因此,模型失败并非因为知识不足,而是推理类型不匹配。这解释了为何即使训练数据截止到 1911 年,模型也难以重推广义相对论。理解这一限制,有助于我们更准确地定位 LLM 在科研中的角色。
验证与重要性:两个不对称的瓶颈
文章强调两个结构性难题。一是验证不对称:模型能生成大量理论,却无法判断哪个正确或值得检验。数学因可逐步检查而部分缓解,但物理等领域缺乏这种验证器。二是重要性判断:LLM 没有“哪个定理有趣”的概念,而辨别何者重要恰是专家能力的关键。这两个瓶颈共同限制了 LLM 做出变革性发现的可能性。
离群值被平均掉:发现机制的冲突
科学突破常源于对细微差异的关注——那个不拟合的离群值。但 LLM 的训练目标是最小化平均误差,天然倾向于平滑掉离群值。文章以普朗克和爱因斯坦为例,说明概念性坚持比数据拟合更重要。这意味着,当前优化预测精度的范式,可能系统性地抑制了产生突破所需的那种注意力。
走向数理世界模型:缺失的拼图
文章引述 Mullainathan 的观点:模型不仅需要知识语料,还需要真实世界的数据(物理世界是什么样的)以及“数学空间”(如何操作数学对象)。这两者在当前时代均属滞后。作者由此指向“数理世界模型”的目标——融合物理结构与数学结构,使两者相互约束。这比单纯扩大语料或提升预测精度更接近突破所需的基础。
Q&A
爱因斯坦测试具体是怎么做的?
爱因斯坦测试是指用截止到某个年份(如1911年)的数据训练语言模型,然后看它能否独立推导出广义相对论。多个团队进行了类似尝试,例如使用1930年或更早数据训练模型,检验其能否重新发现图灵机、哥德尔不完备定理或中微子等后续概念。
为什么说LLM无法像爱因斯坦那样做出突破性发现?
核心原因在于LLM缺乏溯因推理能力,只能进行归纳。突破性发现需要从个别现象跳跃到其原因的创造性 leap,而LLM擅长从大量数据中归纳规律,却无法完成这种逆向推理。因此它们只能生成统计上最可能的答案,而非识别出问题本身是错的。
LLM在科学实验中具体失败的表现有哪些?
例如Mullainathan的模型为每个行星系统推导出不同的错误引力定律,未能发现万有引力定律;Hla的Machina Mirabilis偶尔有直觉闪光,但多数时候只是鹦鹉学舌,缺乏对世界的内部表征;Levine的1930模型会泄漏1930年之后的信息,因为日期过滤不干净。
LLM在验证和判断重要性方面存在什么不对称?
LLM可以生成大量候选理论,但缺乏判断哪个正确或值得检验的依据,这是验证的不对称。同时,LLM没有工作概念来判断哪个数学定理有趣或重要,而辨别重要性正是专家能力的重要部分。预测准确性可测量因而被优化,重要性不可测量则被忽视。
为什么LLM容易忽略科学发现中的关键离群值?
科学变革常源于对细微差异(离群值)的关注,但LLM的训练目标是最小化平均误差,这导致它们倾向于平滑掉离群值。例如普朗克坚持黑体辐射公式的精确匹配而提出量子假设,而LLM的机制会平均掉这类异常。
作者认为LLM在科学中应该朝什么方向发展?
作者认为应明确LLM的能力边界,目标应是构建“数理世界模型”——融合物理世界结构与数学对象操作的系统,而非单纯扩大语料或提升预测精度。这需要真实世界数据和数学空间,以约束对数学对象的操作。
