


Amazon API Gateway WebSocket API 的多区域灾难恢复
内容提要
本文介绍为 Amazon API Gateway WebSocket API 构建多区域灾难恢复的设计模式:采用主备双区域架构,通过 Route 53 DNS 故障转移、DynamoDB 全局表跨区域复制状态、Lambda 金丝雀健康探测及客户端指数退避重连,实现区域故障时自动切换并恢复会话。核心是将应用状态与连接分离,以用户 ID 而非连接 ID 存储状态,使客户端重连后能恢复上下文。
延伸解读
状态与连接分离:故障恢复的关键
WebSocket 连接是持久且绑定区域的,区域故障会切断所有连接。本文的核心设计是将应用状态与连接分离,以用户 ID 而非连接 ID 存储状态。这样客户端重连后,即使连接 ID 改变,也能通过用户 ID 恢复会话上下文。这种模式适用于实时拍卖、协作编辑等共享状态场景,但需注意 DynamoDB 全局表异步复制可能导致故障前瞬间写入丢失,对多数应用可接受。
健康探测与故障转移的自动化机制
方案使用 Lambda 金丝雀每分钟探测 WebSocket 端点,发送心跳并发布 CloudWatch 指标。连续两次失败触发告警,Route 53 健康检查将主区域标记为不健康并切换 DNS。故障恢复同样自动:主区域恢复后金丝雀成功,告警清除,流量切回。生产环境建议采用非对称阈值:故障转移用低阈值(两次)快速切换,故障恢复用高阈值(五次以上)防止抖动。DNS TTL 设为 60-120 秒平衡传播速度与查询效率。
客户端重连策略:避免惊群效应
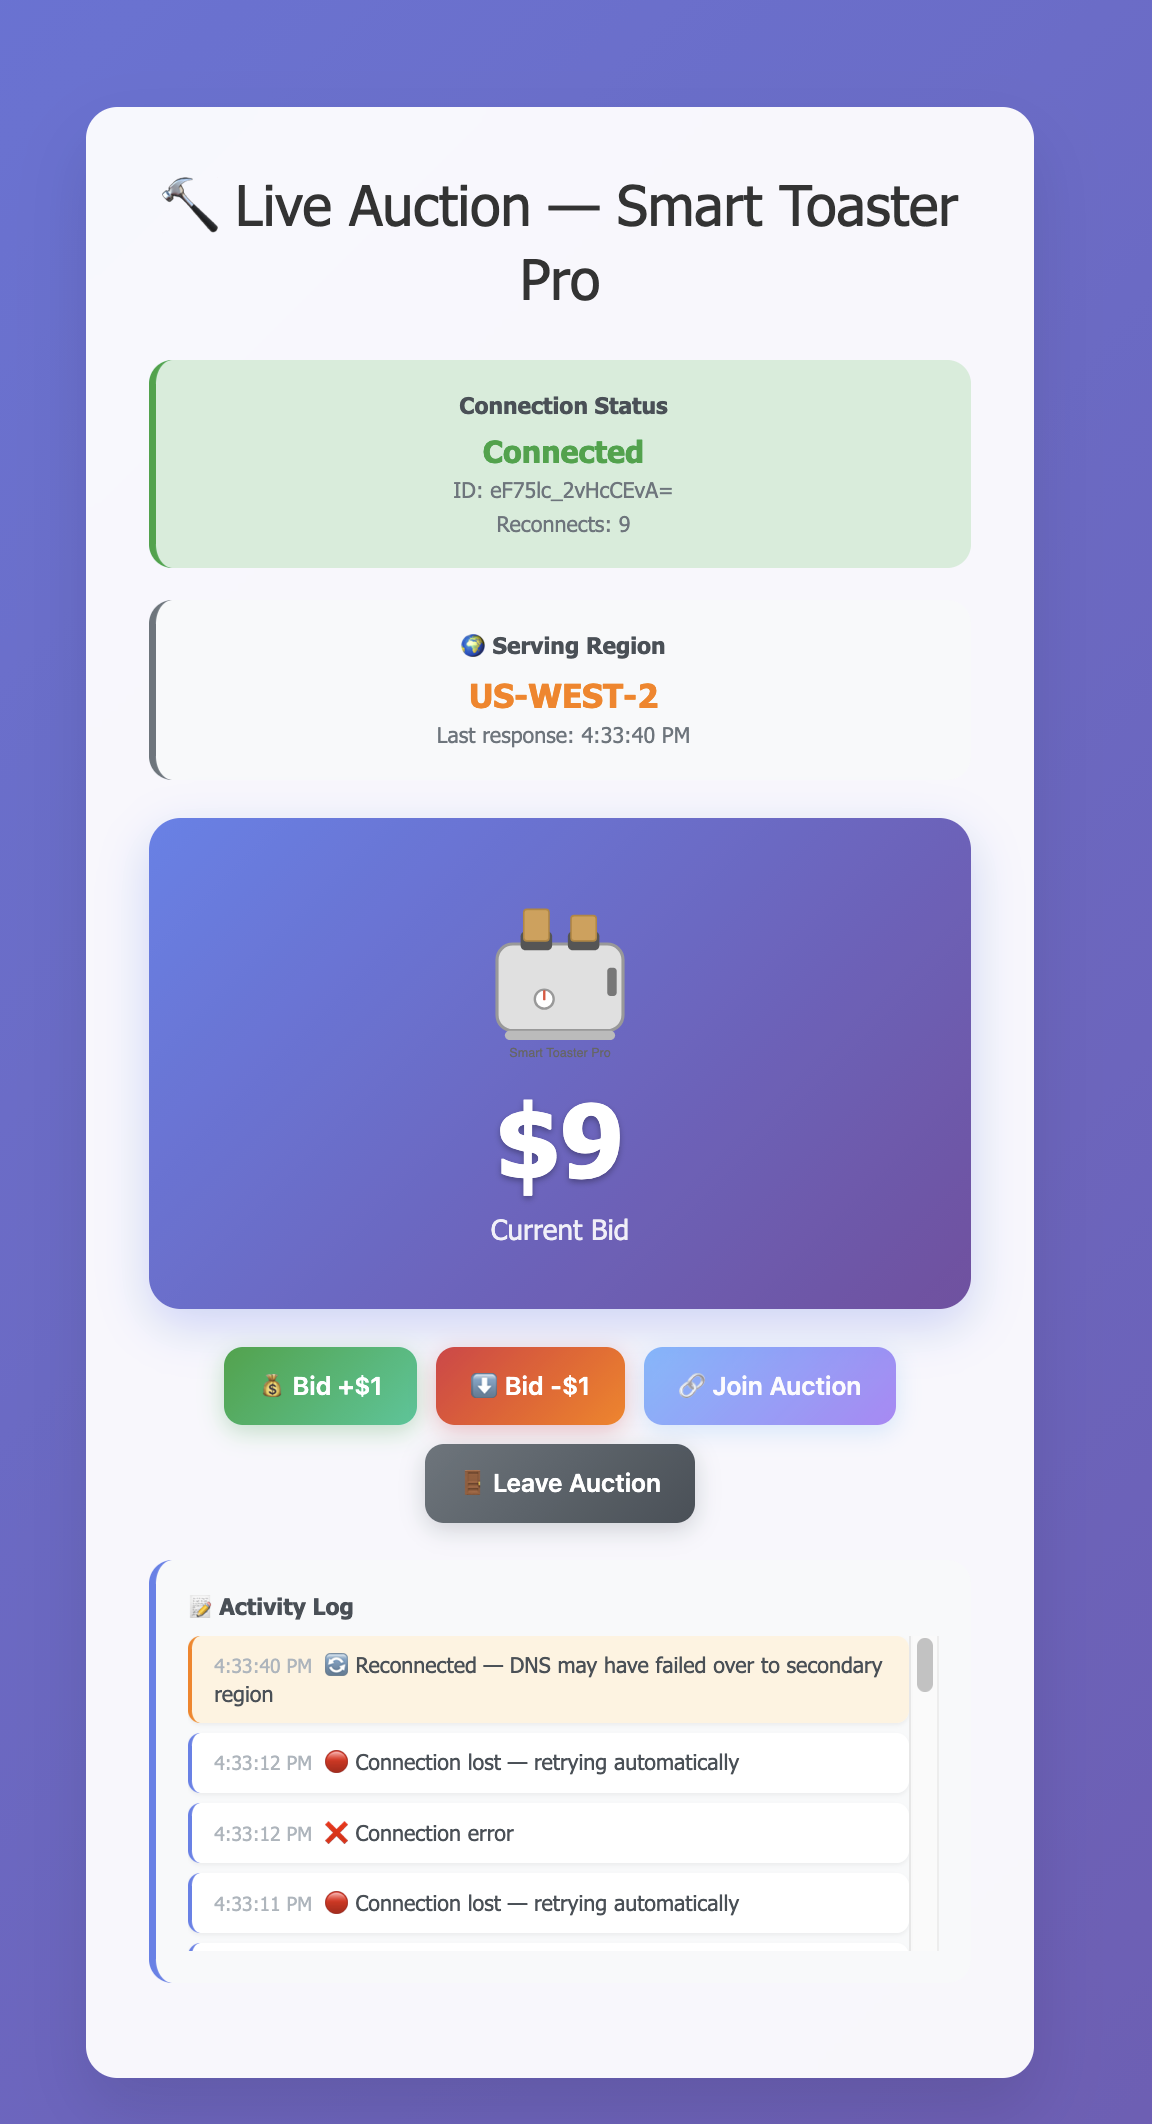
客户端通过心跳检测连接状态,连续两次未收到预期 pong 即强制关闭并重连。重连采用指数退避与完全抖动,间隔随尝试次数翻倍并随机化,防止大量客户端同时重试压垮备用区域。重连成功后,客户端请求最新状态并从 DynamoDB 副本恢复。由于使用同一自定义域名,客户端无需感知当前区域,服务器在响应中返回区域信息供 UI 或日志使用。
生产环境注意事项与替代方案
生产应用需考虑两点:一是重新认证,WebSocket API 在 $connect 路由认证,需在两个区域部署 Lambda 授权器;二是状态恢复,从验证令牌中提取用户 ID(如 sub 声明)作为状态键。若使用关系数据库,可选用 Aurora 全局数据库实现亚秒级复制,但故障转移需提升只读副本为主库,通常增加 1-2 分钟恢复时间,且可基于 CloudWatch 告警自动执行。
Q&A
WebSocket API 在区域故障时面临什么特殊挑战?
WebSocket 连接是持久性的,并且绑定到特定的 AWS 区域。区域故障会切断所有活动连接。对于维护共享状态的应用(如实时拍卖或协作编辑器),用户不仅失去连接,还会丢失会话上下文。
如何实现 WebSocket API 的多区域灾难恢复?
采用主备双区域架构:在两个区域部署相同的 WebSocket API 栈,通过 DynamoDB 全局表共享应用状态,使用 Route 53 故障转移路由策略将流量导向主区域,当主区域不健康时自动切换到备用区域。客户端通过同一域名重连并恢复状态。
如何自动检测区域故障并触发故障转移?
使用一个 canary Lambda 函数每分钟探测主区域的 WebSocket 端点,发送心跳并验证响应,将结果发布为 CloudWatch 自定义指标。CloudWatch 告警在连续两次不健康数据点后触发,关联的 Route 53 健康检查将主区域标记为不健康,从而将 DNS 解析切换到备用区域。
客户端在故障转移后如何恢复会话状态?
客户端使用指数退避和完全抖动策略重连到同一自定义域名,Route 53 将其解析到当前健康的区域。重连后,客户端发送 getState 消息从备用区域的 DynamoDB 副本获取最新应用状态。状态以用户 ID(而非连接 ID)为键存储,因此重连后能恢复上下文。
为什么需要将应用状态与连接分离?
WebSocket 连接是持久性的,但连接 ID 在每次重连时都会改变。将状态以用户 ID 为键存储在 DynamoDB 全局表中,而不是绑定到连接 ID,这样客户端在故障转移后重连到不同区域时,仍能恢复其会话数据,确保体验不中断。
故障转移后客户端如何避免惊群效应?
客户端使用指数退避与完全抖动进行重连。重连间隔随尝试次数加倍,并加入随机抖动,将重连尝试分散到不同时间,防止大量客户端同时重试导致备用区域过载。
如何模拟故障转移进行测试?
将主区域 Lambda 函数的预留并发设置为零,阻止其处理请求。大约两分钟后,canary 检测到连续两次探测失败,Route 53 将主区域标记为不健康,DNS 开始解析到备用区域。客户端检测到连接断开,使用指数退避重连,最终连接到备用区域并恢复状态。
