

使用 nodejs 写爬虫 (一): 常用模块和 js 语法
内容提要
本文是 Node.js 爬虫系列教程第一篇,介绍常用模块与必备 JS 语法。常用模块包括:fs-extra 提供 promise 化文件操作;superagent 模拟 HTTP 请求,自动序列化并管理 cookies;cheerio 实现服务端 jQuery 式 HTML 解析;log4js 提供日志分级与文件输出;sequelize 用于数据库持久化;chalk 为输出添加颜色;puppeteer 操控无头浏览器抓取 JS 渲染内容。语法重点讲解 async/await 并发处理及正则表达式提取信息。
延伸解读
模块选择与适用场景
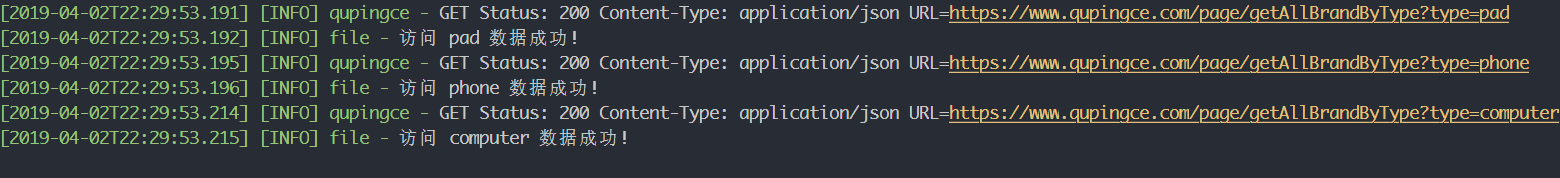
文章介绍了多个 Node.js 爬虫常用模块,各有侧重。superagent 适合模拟 HTTP 请求,自动处理序列化和 cookies;cheerio 用于服务端解析静态 HTML;puppeteer 则能操控无头浏览器抓取 JS 渲染内容,如 SPA 页面。fs-extra 和 log4js 分别处理文件操作与日志记录,sequelize 用于数据库持久化。读者可根据目标网站类型和项目需求组合使用。
async/await 并发陷阱
文章通过测试代码指出,在 for 循环中使用 await 会顺序执行,耗时约 3 秒;而 forEach 中调用 async 函数不会等待,任务并发执行,耗时极短。若需等待多个并发任务完成,应使用 Promise.all 收集结果。这提醒开发者注意 async/await 在循环中的行为差异,避免误用导致性能或逻辑问题。
正则表达式提取信息
文章以从图片 URL 中提取文件名为例,展示了正则表达式的实用场景。通过 match 方法和捕获组,可以精准提取所需部分。在爬虫中,常需从 cheerio 获取的文本中进一步提取信息,正则表达式是强有力的工具。文章建议参考廖雪峰的教程入门,但未深入语法细节。
Q&A
Node.js 爬虫常用哪些模块?
常用模块包括:fs-extra(文件操作)、superagent(HTTP 请求)、cheerio(HTML 解析)、log4js(日志)、sequelize(数据库持久化)、chalk(终端着色)、puppeteer(无头浏览器)。
superagent 有什么特点?
superagent 是 Node.js 的 HTTP 客户端,能根据响应 content-type 自动序列化,自动缓存和发送 cookies,API 链式调用,异步接口返回 Promise,还支持插件集成。
cheerio 在爬虫中有什么用?
cheerio 用于服务端解析 HTML,提供类似 jQuery 的 API,可以方便地获取和操作 DOM 元素,从网页源代码中提取信息。
log4js 有哪些功能?
log4js 是 Node.js 日志库,支持自定义 appender(输出目标)、日志分级、滚动日志、自定义输出格式,可通过组合 appender 实现不同目的的 logger。
puppeteer 能解决什么问题?
puppeteer 可以操控无头浏览器,抓取通过 JavaScript 渲染的内容(如 SPA 页面),在页面元素出现时获取渲染后的 HTML,解决传统爬虫无法获取动态内容的难题。
使用 async/await 时如何实现并发?
在 for 循环中使用 await 会顺序执行,耗时累加;要实现并发,应直接调用返回 Promise 的函数(如使用 forEach 或 map),或使用 Promise.all 等待多个任务完成。
如何用正则表达式从 URL 中提取文件名?
可以使用正则表达式匹配并提取。例如,对于 URL '/GetFile/getUploadImg?fileName=9b1cc22c74bc44c8af78b46e0ca4c352.png',使用正则 /\/GetFile\/getUploadImg\?fileName=(.+)\..+/ 并调用 match 方法,即可提取出文件名 '9b1cc22c74bc44c8af78b46e0ca4c352'。
