


Shift-JIS / UTF-8 乱码解读:或许还能再读懂一点
内容提要
本文介绍了文字化け(乱码)问题及解决方法。通过解码工具,可以还原乱码。文章详细介绍了Shift-JIS和UTF-8字符编码结构,以及解码过程。通过假设和推理,逐步缩小候选字符范围,最终得到正确结果。提供了辅助解码工具,根据候选字符还原乱码。
延伸解读
解码工具差异:1字节与2字节处理
文章指出,不同解码工具对无法解码数据的处理方式不同,分为“1字节类”和“2字节类”。前者遇到无效数据时跳过1字节继续解码,后者则跳过整个无效序列。这导致同一乱码在不同工具中产生不同结果,且占位符“�”可能代表1字节或2字节。因此,使用辅助工具时需注意其处理方式,必要时尝试另一种模式。
假设推理:逐步缩小候选范围
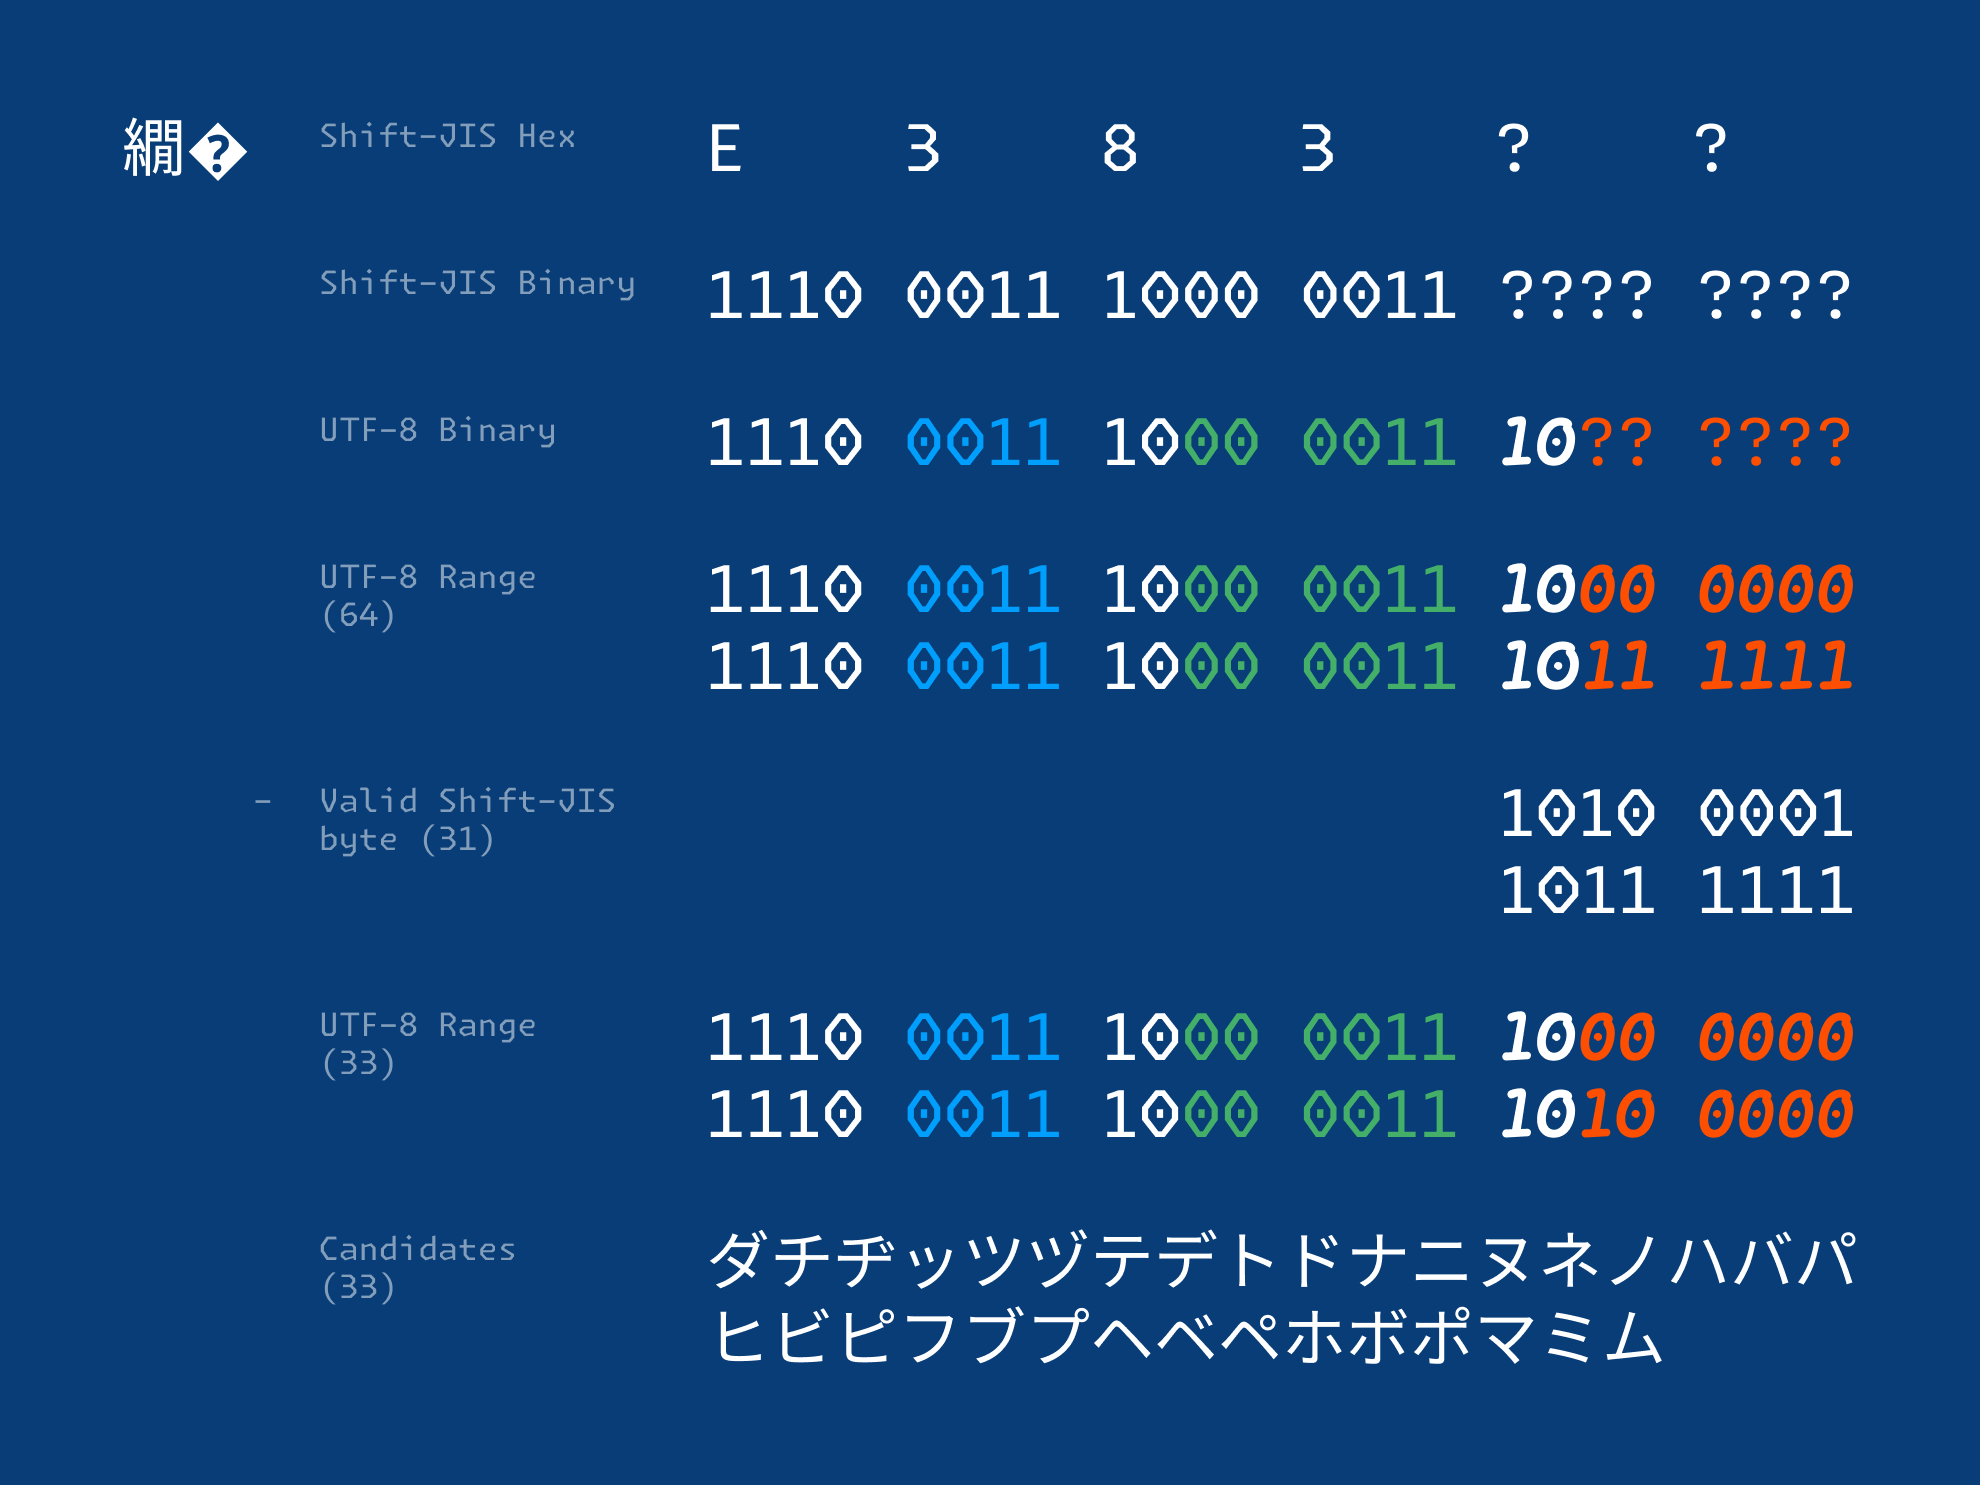
文章通过四个假设逐步缩小候选字符:首先假设原数据是有效UTF-8,将丢失数据从8位减至6位,候选从无限降至64个;其次假设原文是日语,排除非日语字符;然后通过反向编码验证,排除无法还原乱码的候选;最后可选假设不使用难读汉字,进一步限定为JIS第一水準汉字。这些假设基于编码规则,有效提高了恢复准确率。
编码结构:Shift-JIS与UTF-8的差异
Shift-JIS字符由1或2字节组成,字节值范围有限;UTF-8则使用1至4字节,覆盖U+0000至U+10FFFF。当Shift-JIS编码的字符串被误用UTF-8解码时,若找不到对应字符,就会产生乱码。理解这两种编码的字节结构,有助于分析乱码成因,并为后续解码提供基础。
Q&A
什么是文字化け?
文字化け是信息交换中常见的问题,通常由于字符编码不匹配导致的乱码现象。
Shift-JIS和UTF-8有什么区别?
Shift-JIS编码的字符由1或2个字节组成,而UTF-8的编码范围更广,使用1到4个字节。
如何解码文字化け?
可以通过假设和推理逐步缩小候选字符范围,使用辅助解码工具来还原乱码。
解码工具的不同会影响结果吗?
是的,不同的解码工具可能会对相同的文字化け产生不同的结果,需要根据工具的特性进行调整。
文字化け的常见原因是什么?
文字化け通常是由于Shift-JIS编码的字符串在UTF-8中找不到对应字符导致的。
如何使用假设来恢复乱码?
可以假设原数据是有效的UTF-8数据,或假设原字符串是日语,从而缩小候选字符范围。
