

我把八种内网穿透都跑了一遍,发现「哪个最快」是个伪问题
内容提要
作者实测八种内网穿透工具后认为,“哪个最快”是伪问题:中继式工具延迟仅差26毫秒,吞吐都受链路限制,真正的分水岭在于是否需要自备公网机器。边缘托管方案如cloudflared无需自备机器,但国内首字节延迟达1–3秒;rathole最省内存;chisel可伪装HTTPS,穿透仅放行80/443端口的网络;nps虽star数多,但已停更且有RCE漏洞历史。选型应依据实际场景与代价,而非star数。
延伸解读
先分清三类工具,再谈选型
文章把内网穿透工具分为中继式、边缘托管和组网式三类,并指出它们解决的是不同问题。中继式需要自备公网机器,换来稳定和可控;边缘托管无需自备机器,但控制权在厂商手中;组网式则是把设备拉进虚拟局域网,并非端口映射。混在一起按 star 排序没有意义,因为比较的前提就不成立。
中继式之间,速度差异可忽略
实测中,中继式工具的 TTFB 集中在 9–35 毫秒,最大差距仅 26 毫秒,人几乎无法感知;吞吐也都接近跨境链路天花板。作者因此认为“哪个最快”是伪问题,真正该问的是是否需要一台公网机器、内存是否吃紧、网络是否只放行 80/443 等约束条件。
托管式省机器,但代价在体验和控制权
cloudflared 无需自备机器,一条命令即可使用,但国内首字节延迟达 1–3 秒,吞吐也明显下降;localtunnel 依赖的公共服务端在测试中连不上,用户毫无办法。这揭示了托管式的本质:省去运维一台机器的麻烦,同时把控制权和稳定性交给厂商,适合临时使用而非长期方案。
star 数是存量,维护状态才是关键
nps 拥有超过 3.4 万 star,功能实测也在中游,但最后一次提交停在 2024 年 5 月,且有过高危 RCE 漏洞历史。作者强调“能用”和“该用”是两回事:star 反映历史积累,不能代表当前维护状态。选型时应查看最近提交时间和漏洞记录,而非只看榜单排名。
Q&A
内网穿透工具中,中继式和边缘托管的核心区别是什么?
中继式需要自备公网机器(VPS)运行server端,流量全过中继,稳定可控但需运维;边缘托管用厂商边缘节点当中继,无需自备机器,但控制权在厂商,国内访问延迟高。
为什么说“哪个内网穿透最快”是个伪问题?
因为中继式工具之间的延迟差距仅26毫秒(9ms到35ms),人感知不到;吞吐都受限于链路天花板(直连7.8Mbps,中继式6.87-7.47Mbps),拉不开差距。真正该问的是是否需要公网机器、资源占用和场景适配。
cloudflared临时隧道在国内使用有什么缺点?
国内首字节延迟中位数1.1秒,p95接近3秒,是直连的约50倍;吞吐从7.8Mbps降到2.29Mbps。因为流量走境外边缘节点,绕地球一圈,所以“国内快”是假的。
在只放行80和443端口的网络里,应该用哪个内网穿透工具?
用chisel或wstunnel。它们把流量封装在WebSocket里,走80/443端口,看起来像普通HTTPS流量,穿透性强。虽然chisel延迟稍高(35ms),但在受限网络里能连上比快26毫秒重要得多。
nps工具虽然star数多,为什么选型时要谨慎?
nps有34k星,但最后一次提交停在2024-05-30,停更约一年半,且历史上有高危RCE漏洞。功能虽能用(TTFB 24ms,单流7.06Mbps),但无法指望它修复下一个漏洞。star数是存量,维护状态才是关键。
通过内网穿透传大文件时,为什么单线程速度上不去?怎么解决?
因为链路限速是按单条连接(per-flow)的,单流顶到约7.8Mbps就受限。开多线程(如4流)能叠加到约15Mbps。用aria2、axel等多线程下载器或rsync并行传输,可以直接把吞吐翻倍。
内存吃紧的小机器上,推荐用哪个内网穿透工具?
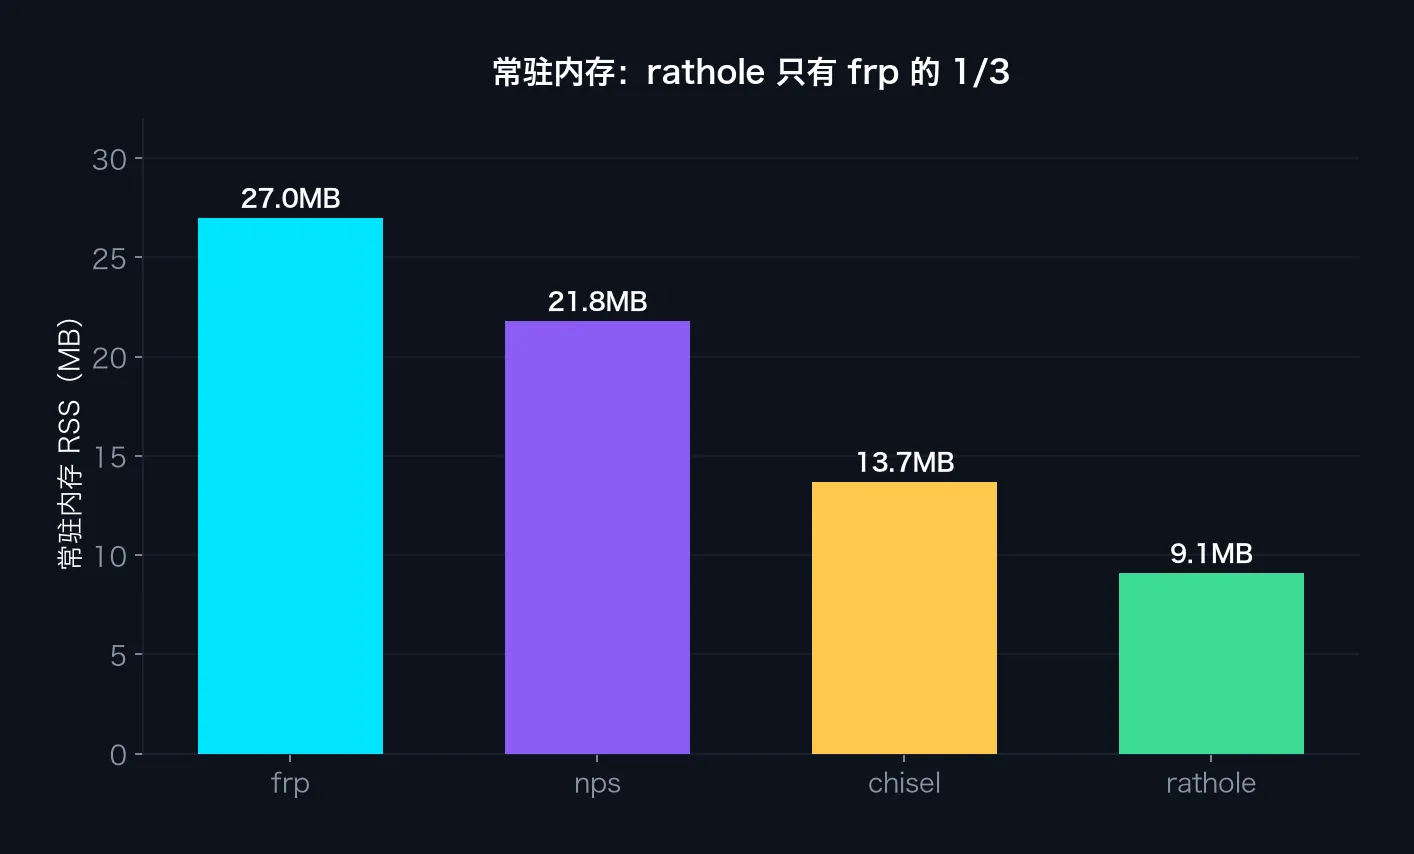
推荐rathole。它用Rust编写,常驻内存仅9.1MB,是frp(27MB)的三分之一,且实测最稳。在2C2G的小机器上,这18MB的差距很关键,尤其还要跑其他服务时。
