


不想维护搜索爬虫,怎么每天跟踪关键词排名?用 SERP API 做一个 SEO 监测脚本
内容提要
文章介绍如何用 AceDataCloud Google SERP API、Python 和 SQLite 搭建关键词排名监测脚本,无需自行维护搜索爬虫。关键在于固定国家、语言、页码等搜索口径,并区分“找到”“未命中”“请求失败”三种状态,未命中不记为固定名次。脚本保存原始结果与历史记录,可通过 cron 每日运行;应先看成功率再比较排名,以免误读趋势。
延伸解读
先定义“排名”再谈涨跌
文章强调监测的是指定国家、语言和本次返回的自然搜索结果中的域名位置,而非所有用户看到的唯一排名,也不含广告位或地图位。若今天查美国英语、明天查英国英语,两天的值不能连成趋势线。固定搜索口径是让历史记录可比的前提,否则数据看似连续,实际口径已变。
未命中不等于第十一名
返回十条结果却没找到目标域名时,文章建议记为 not_found_in_response,位置留空,不写 0 或 999,也不参与平均排名计算。因为只能确认它不在本次返回集合内,无法知道集合之外的具体名次。把未命中与请求失败分开记录,才能避免把接口异常误读成排名下滑。
域名匹配与子域名口径
示例用 URL 的 hostname 做匹配,而非字符串包含,避免 notexample.com 被误认作 example.com。默认允许 shop.example.com 命中 example.com;若只关心主站应改为严格相等,若关注单篇文章还需增加路径规则。文章提醒不要未经约定就把全站最好位置当成某个页面的位置。
先看成功率再看排名
文章建议查看结果时先确认成功率,再比较排名;只有两次都命中且搜索条件相同,才比较位置差。若返回数量突然从十条变成两条,还要先排除返回集合变化的影响。脚本有意不自动重试,让失败先被看见,再按服务限流规则增加有上限的退避,比无限重复请求更可控。
Q&A
不想自己维护搜索爬虫,怎么每天跟踪关键词排名?
可以用 AceDataCloud Google SERP API 获取搜索结果,用 Python 脚本解析目标域名的位置,并用 SQLite 保存历史记录,再通过 cron 每天定时运行。这样无需维护页面选择器、代理和异常重试,只需维护监测规则和历史数据。
用 SERP API 监测排名时,搜索口径为什么要固定?
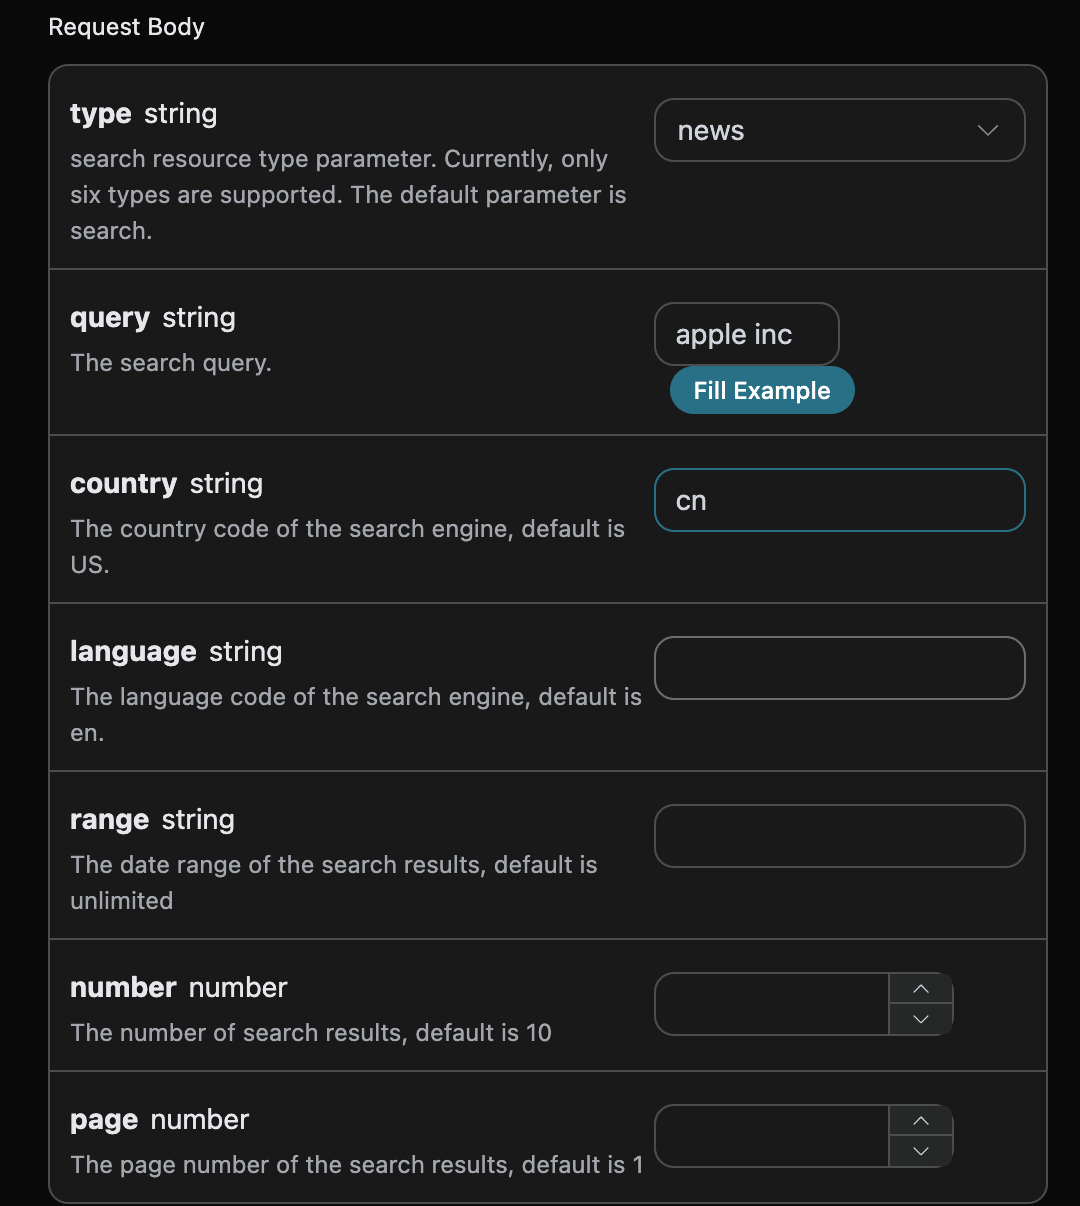
因为排名依赖国家、语言、页码等条件,不同口径的结果不可比。文章建议固定 type=search、country=us、language=en、page=1、number=10,并随记录保存这些条件,避免今天查美国英语、明天查英国英语却连成一条趋势线。
接口返回了结果但没找到自己的域名,应该记成第几名?
不能记成固定名次,也不能补成第十一名。应记为 not_found_in_response,位置写空值,不写 0 或 999,也不参与平均排名计算。你只知道它没出现在本次返回集合里,不知道集合外的位置。
脚本里域名匹配怎么做才不容易误判?
应使用 URL 的 hostname 进行匹配,而不是字符串包含判断,否则 notexample.com 可能被误认为 example.com。示例中 hostname 等于目标域名或以“.目标域名”结尾即命中,因此子域名 shop.example.com 可以命中 example.com;若只关心主站可改为严格相等。
每天自动跑脚本后,看数据时应该先看什么?
先看成功率,再看排名。只有两次都命中且搜索条件相同,才能比较位置差;今天没命中只能说本次结果未检出。若返回数量突然从十条变成两条,还要先排除返回集合变化的影响。
这个排名监测脚本能证明页面修改导致排名上升吗?
不能。脚本不承诺改善 SEO,也不推断某次页面修改导致了排名变化。它只提供能追溯、能区分失败与未命中的观察基础;更长期的判断需要结合内容改动、站点指标和连续观测一起分析。
