为什么模型版本管理不足以支撑生产级AI
内容提要
AI应用部署不能只依赖模型版本管理,检索、提示词、工具接口等组件可独立变更,需用版本化发布清单统一管理。应建立评估门禁,测试完整链路而非仅模型;按真实负载压测,区分首字延迟与总时长;将成本与遥测绑定同一发布版本;通过金丝雀发布和可回滚路由控制风险,并确保回滚恢复兼容依赖。核心是让值班工程师能定位问题发布并恢复已知良好版本。
延伸解读
发布清单:定义原子发布单元
文章指出,AI应用部署不能只依赖模型版本管理,因为检索、提示词、工具接口等组件可独立变更。建议使用版本化发布清单,记录release_id、模型、提示词、检索索引、嵌入、运行时配置等引用,确保这些组件作为整体被测试和发布。清单不是追求完全可复现,而是明确测试过的组合,并在请求开始时一致地解析。
评估门禁:测试完整链路而非仅模型
评估应针对产品问题,如答案是否引用可访问来源、反映正确版本、拒绝编造。使用版本化数据集,包含普通问题、历史失败、模糊请求、缺失证据和越权尝试。结合确定性检查(模式、工具参数、引用ID、权限)和语义判断(评分标准、人工复核)。门禁必须运行完整路径(检索、生成、输出验证),并按长输入、语言、产品版本等切片检查。
负载测试:区分首字延迟与总时长
LLM工作负载不能仅用每秒请求数描述,需测试输入输出长度、并发和到达突发的分布,包括冷热缓存。流式响应要分开测量首字延迟、后续令牌节奏和总完成时间,队列时间也重要。批处理可提高吞吐但增加用户可见延迟,需对实际调度器进行基准测试。GPU利用率是诊断信号,不是产品目标。
回滚与金丝雀:路由决策与依赖兼容
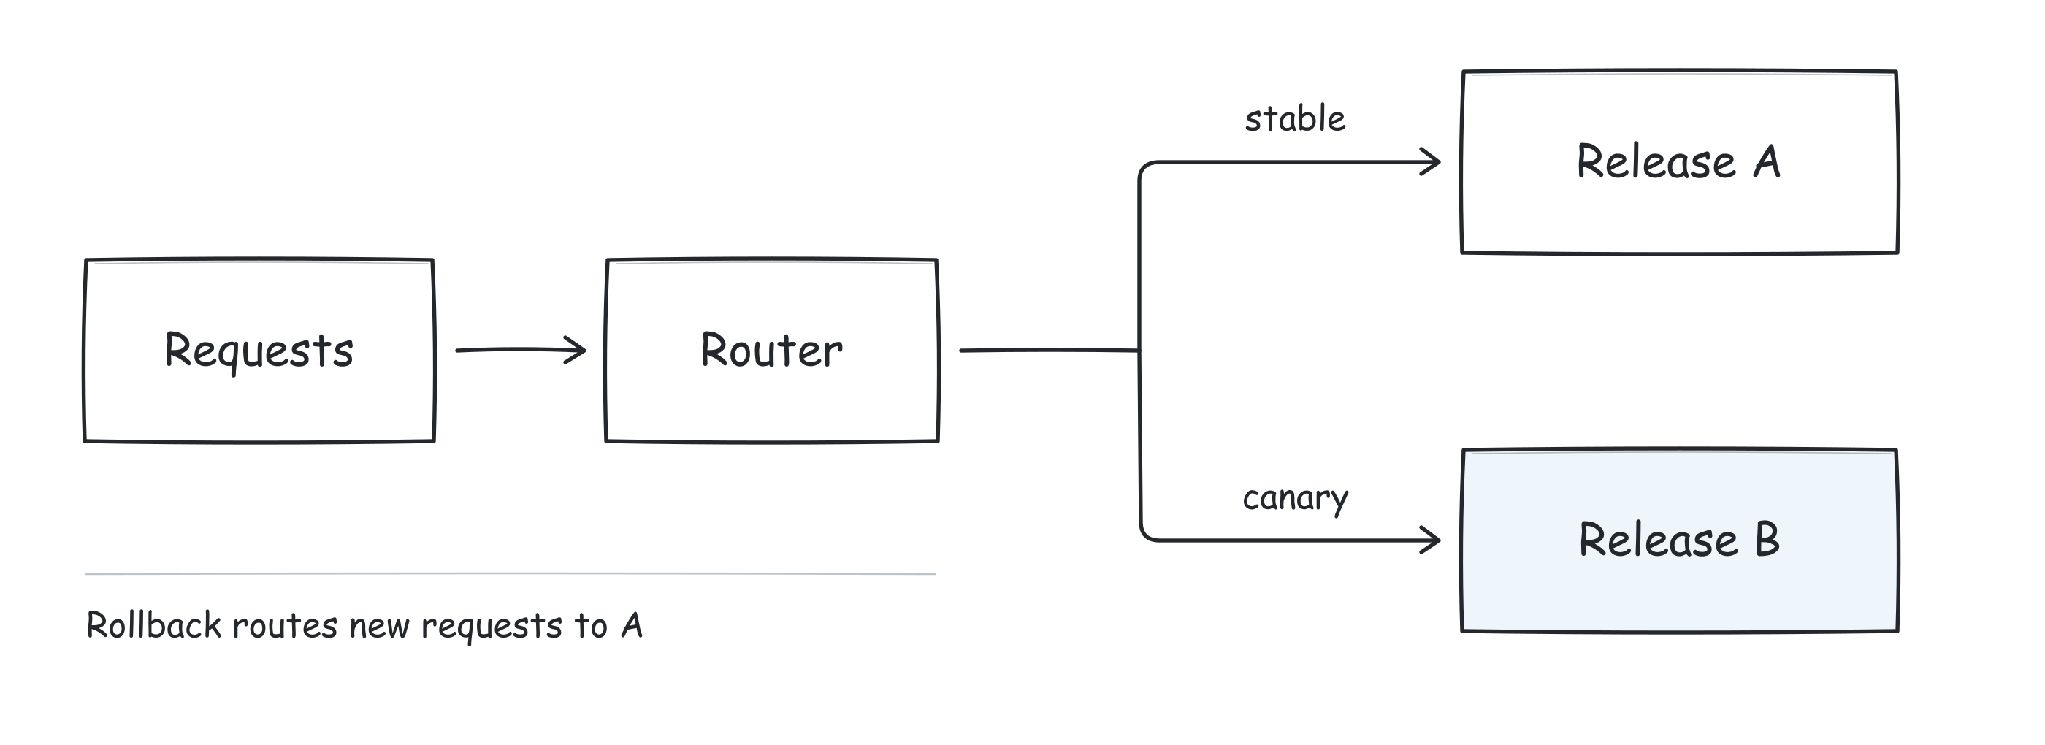
金丝雀发布通过限制暴露和创建对比来降低风险,但需谨慎选择分配方式(如对话需稳定分配)。回滚不仅是恢复旧模型权重,还需恢复兼容依赖,如检索索引版本,并处理缓存、进行中请求和工具副作用。定义停止条件、观察要求和恢复流程,确保值班工程师能定位问题发布并恢复已知良好版本。
Q&A
为什么仅靠模型版本管理不足以支撑生产级AI应用?
因为AI应用的行为还受检索、提示词、工具接口、预处理、服务设置等多个组件影响,这些组件可以独立变更,仅管理模型版本无法覆盖所有可能影响行为的变更。
生产级AI应用应该用什么来定义一次发布?
应该使用版本化的发布清单(release manifest),其中包含release_id、app_revision、model_revision、prompt_revision、retrieval配置、runtime_revision、evaluation_suite等,确保所有必须协同工作的组件被统一版本化。
评估门禁应该测试什么?
评估门禁应测试完整链路,包括检索、生成和输出验证,而不仅仅是模型本身。同时要按有意义的切片(如长输入、多语言、产品版本、稀疏证据请求)检查结果,并设定明确的接受标准。
如何对LLM工作负载进行负载测试?
应测试输入长度、输出长度、并发和到达突发的分布,包括冷热缓存行为。对于流式响应,要区分首字延迟、后续令牌节奏和总完成时间,并关注队列时间。使用端到端追踪,避免简单相加各阶段p95。
为什么回滚不仅仅是恢复旧模型权重?
因为回滚必须恢复兼容的依赖,如检索索引、缓存等。如果候选版本覆盖了检索索引,仅回滚应用镜像可能仍会读取新索引。需要保留兼容的索引版本或设计可逆迁移,并处理进行中的请求和工具副作用。
如何将成本和遥测与发布版本关联?
在追踪和结构化请求事件中记录发布标识,一起跟踪质量信号、延迟分布、错误、令牌使用和回退率。计算每个成功任务的成本,将失败尝试计入分子,并比较相似工作负载。
