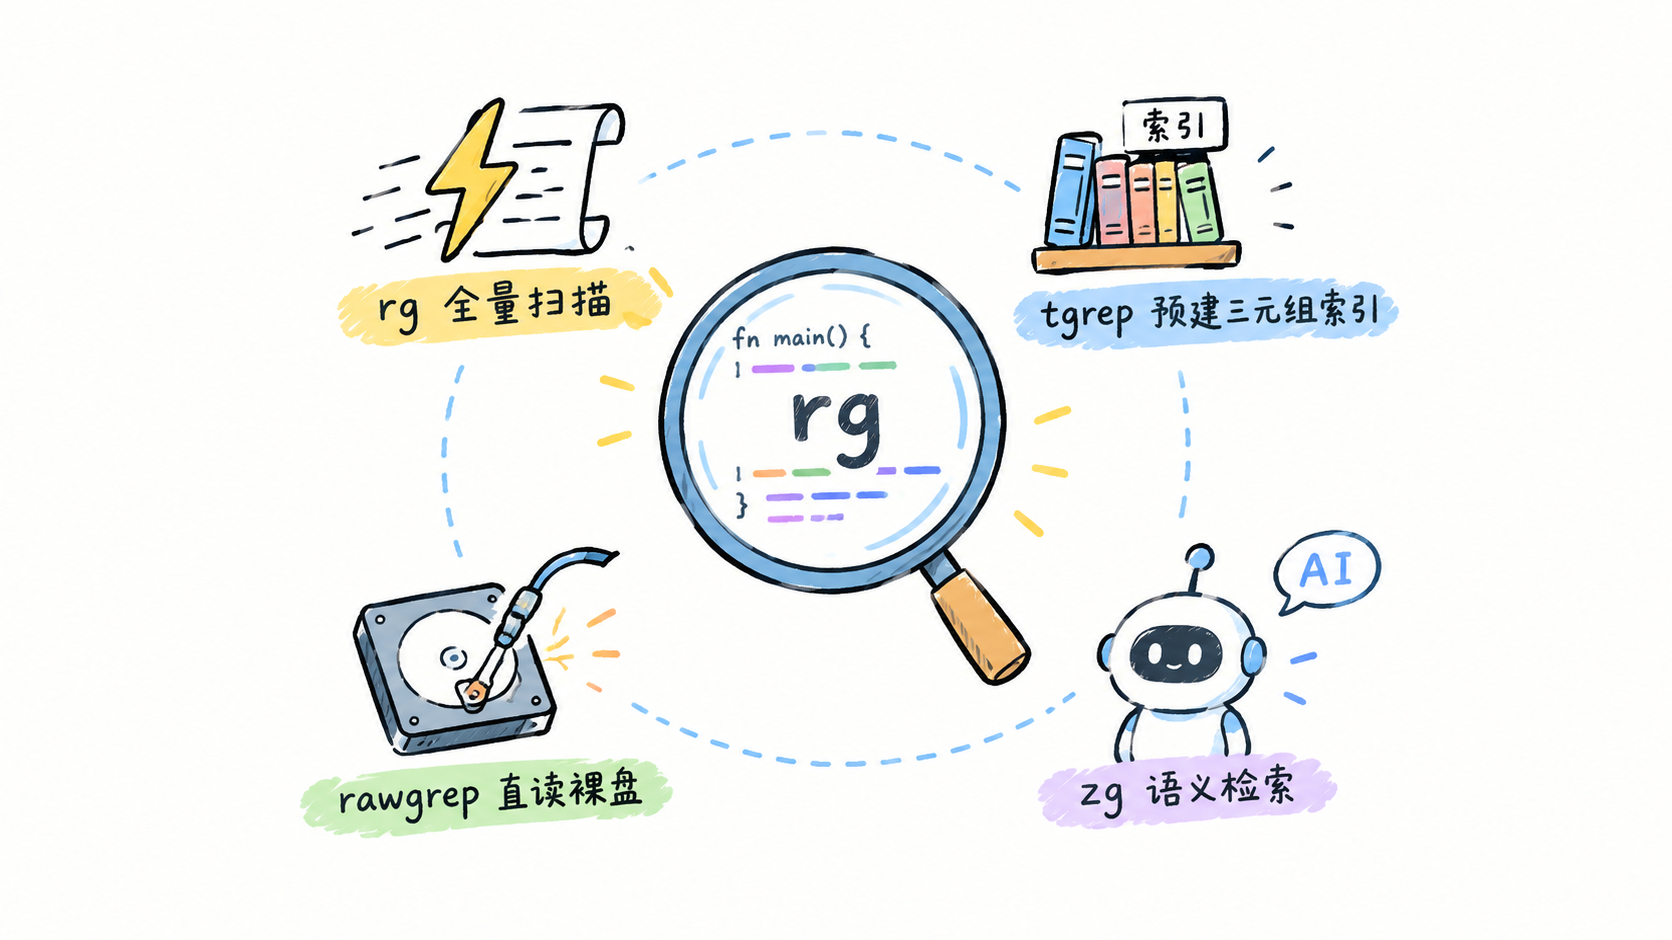

grep 工具大盘点:rg、tgrep、rawgrep、zg
内容提要
文章盘点了四款代码搜索工具:ripgrep(rg)依靠全量扫描和极快算法,仍是日常默认选择;tgrep 通过预建三元组索引,在超大仓库中实现秒级搜索,已被 Copilot CLI 采用;rawgrep 绕过文件系统直接读取裸盘,仅限 Linux 且需 root 权限;zg 融合 ripgrep、BM25 与向量检索,面向 AI Agent 提供语义搜索。Claude Code、Codex、Pi 等主流编程助手底层均使用 ripgrep。
延伸解读
从全扫到索引:搜索范式的转变
文章对比了rg的全量扫描与tgrep的索引预建。rg每次搜索都需读取所有文件,耗时与总字节数成正比;而tgrep通过三元组索引只触碰可能命中的文件,在超大仓库中实现秒级响应。这反映了搜索工具从“暴力扫描”到“智能过滤”的演进,尤其适合高频搜索场景。
AI Agent 的搜索需求催生新工具
文章指出,Claude Code、Codex、Pi等主流编程助手底层均使用ripgrep,因其稳定、快速且输出易解析。但随着仓库增大,rg的全扫模式成为瓶颈,tgrep和zg应运而生:前者用索引加速,后者引入语义检索以减少无效搜索和token消耗。这显示搜索工具正从通用工具向Agent基础设施演变。
rawgrep 的极限与门槛
rawgrep绕过文件系统直接读裸盘,在特定场景下速度惊人,但仅限Linux且需root或setcap能力,内存占用也未优化。文章将其定位为“性能天花板参照系”,而非日常工具。这提醒读者,追求极致性能往往伴随平台限制和安全风险,需权衡实际需求。
如何根据场景选择工具
文章建议:日常开发用rg;超大monorepo且高频搜索用tgrep;rawgrep适合只读分区或超大日志等特定场景;AI Agent用户可关注zg的语义搜索。选择取决于仓库规模、搜索频率和平台限制,没有绝对最优,只有最适合当前工作流的工具。
Q&A
ripgrep(rg)为什么能成为代码搜索的事实标准?
ripgrep 采用全量扫描思路,用 SIMD 加速的 regex 引擎匹配,默认递归并自动过滤 gitignore、隐藏文件和二进制文件,Unicode 默认开启且不掉速,还支持类型过滤、PCRE2、搜压缩文件等。性能上,搜 Linux 内核源码 [A-Z]+_SUSPEND 仅需 0.082 秒,比 ag 快 5 倍,比 ack、git grep 快 30 多倍。它不建索引、不缓存,安装即用,因此成为事实标准。
tgrep 如何实现超大仓库的秒级搜索?
tgrep 通过预建三元组(trigram)索引,搜索时只碰可能命中的文件,并采用 server/client 架构。它使用双层索引(磁盘 mmap 索引和内存覆盖层),后台并行建索引,周期落盘,内存有界建索引(默认 external 策略将峰值内存压到 160MB)。在 gecko-dev 仓库上,tgrep 搜索仅需 643 毫秒,比 ripgrep 的 33.4 秒快 51.9 倍。
rawgrep 直接读裸盘有什么优缺点?
rawgrep 绕过文件系统直接读裸块设备,减少一层开销,并利用 fragment cache 学习可跳过的文件,从而加速重复搜索。在 Chromium 500K 文件上搜 TODO,热缓存下 131.8ms,比 rg 的 363.5ms 快 2.76 倍;冷缓存下 2.72s 比 11.90s 快 4.38 倍。但缺点也很明显:仅支持 Linux 和 ext4/ntfs 文件系统,需要 root 或 setcap 能力,内存占用偏高,因此对大多数开发者门槛较高。
zg 在代码搜索中有什么独特之处?
zg 将 ripgrep、BM25 和向量检索统一在一个本地优先的入口后面,支持语义搜索。它先按意思召回相关片段并排序,需要精确确认时再落到文本或正则。数据、索引和本地模型全在本机,远程 embedding 需授权。它天生为 AI Agent 设计,支持 MCP,能接 Codex、Claude Code 等,通过语义召回减少 Agent 的无效搜索和 token 消耗。
Claude Code、Codex、Pi 这些编程助手底层用什么搜索代码?
它们底层都使用 ripgrep。Claude Code 内置的 Grep 工具底层就是 ripgrep,并捆绑在发行版中;Codex 的打包脚本硬性要求所有平台发行版必须带上 rg;Pi 的 grep 工具通过 spawn 一个 rg 进程并解析其 JSON 输出,如果机器上没有 rg 还会自动下载。原因是 ripgrep 经过十年验证,默认行为合理,输出格式好解析。
如何根据场景选择 rg、tgrep、rawgrep 或 zg?
日常写代码找东西,rg 是默认选择,安装即用。如果仓库大到 rg 一次要等好几秒且高频搜索,tgrep 值得上,索引成本能摊回来。rawgrep 适合当性能天花板,但需接受 Linux 和 root/能力门槛。如果使用 AI Coding Agent 且受够无效搜索和 token 消耗,zg 值得关注,其语义加关键词组合能补上纯 grep 在不知道确切名字时的短板。
