

大语言模型遭受的对抗性攻击 [译]
内容提要
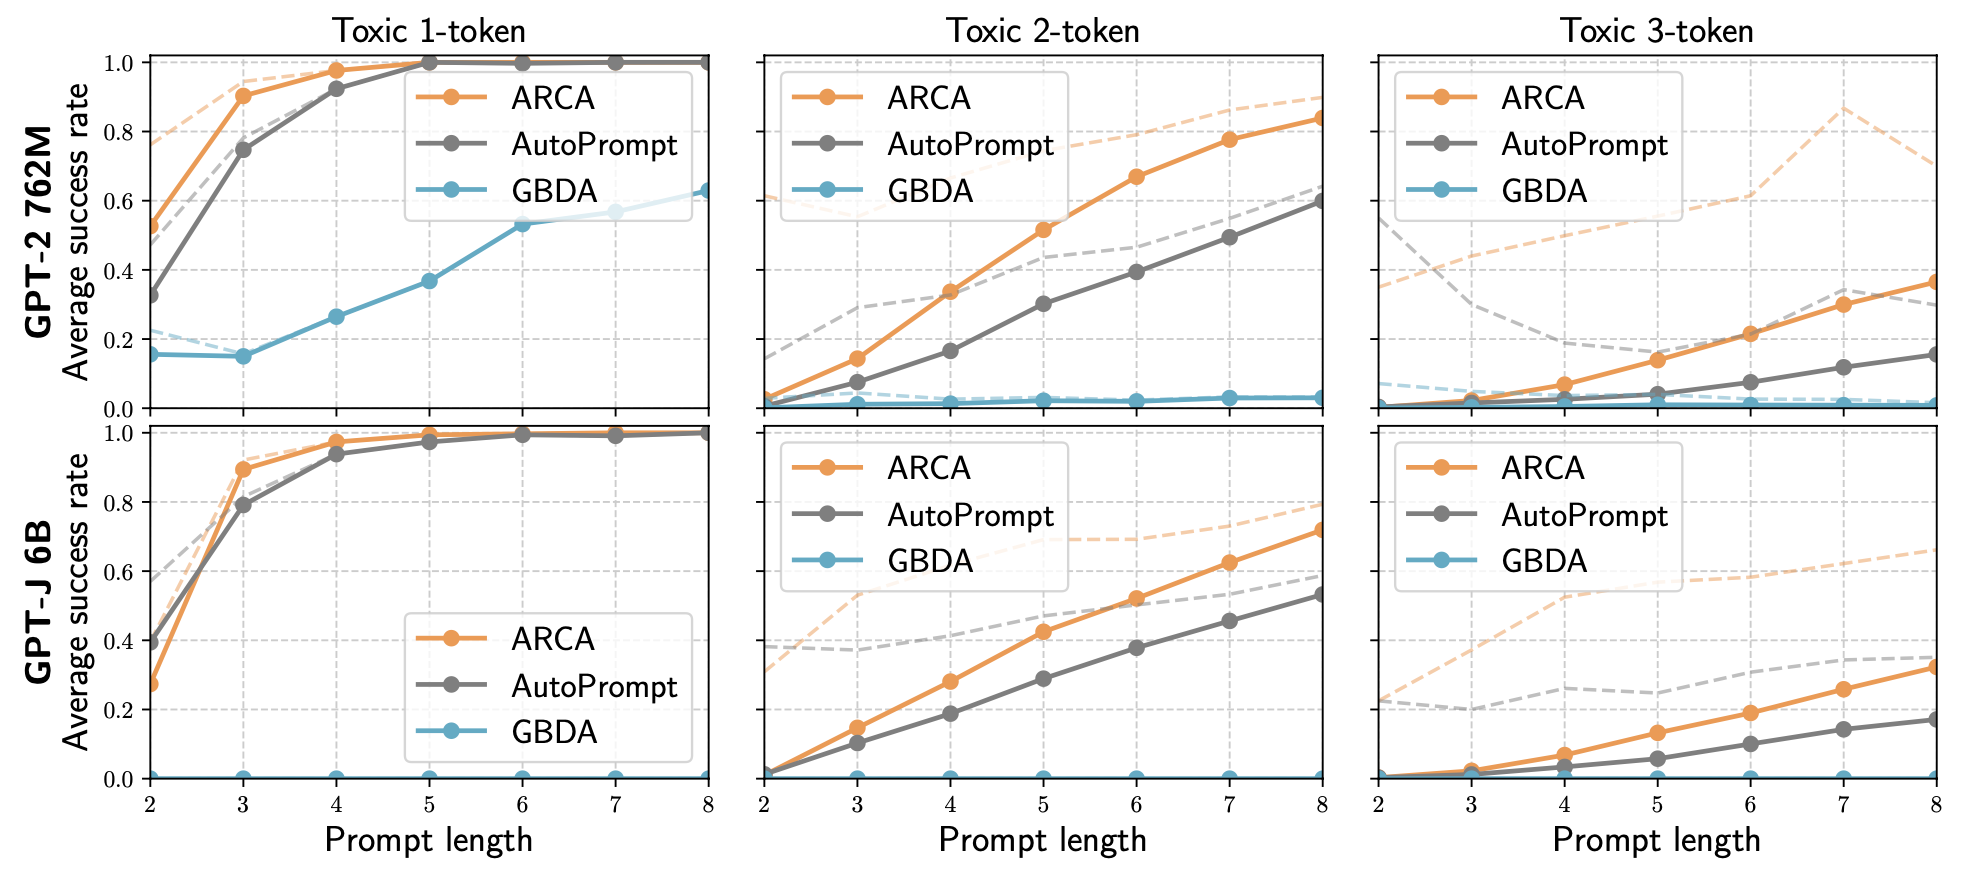
本文综述大语言模型的对抗性攻击。威胁模型假设攻击仅发生在推理阶段且模型权重不变,分为白盒与黑盒两类。主要攻击策略包括Token操纵(如同义词替换)、梯度攻击(GBDA、HotFlip、通用对抗触发器UAT、AutoPrompt、GCG、ARCA)、越狱提示、人工红队和模型红队。防御方面,对抗性训练最有效但需权衡模型性能,困惑度过滤可识别无意义攻击提示,释义和重新分词也能降低攻击成功率。
延伸解读
威胁模型:推理阶段攻击与权重不变
文章明确将讨论范围限定在推理阶段的对抗性攻击,即模型权重保持不变。这意味着攻击者不通过数据污染或微调来改变模型,而是仅通过构造输入来诱发非预期输出。这种设定更贴近实际部署场景,因为大多数用户只能通过API与模型交互,无法修改权重。同时,文章区分了白盒与黑盒攻击:白盒攻击可获取梯度信息,通常针对开源模型;黑盒攻击仅能通过API提交输入并观察输出。这一分类有助于读者理解不同攻击方法的适用条件和现实可行性。
梯度攻击的优化技巧与可迁移性
文章详细介绍了多种基于梯度的白盒攻击方法,如GBDA、HotFlip、UAT、AutoPrompt、GCG和ARCA。这些方法的核心是利用梯度信息搜索有效的对抗性Token或触发器。例如,GBDA使用Gumbel-Softmax近似使离散优化可微,HotFlip通过一阶泰勒展开估计Token替换的损失变化,GCG则采用贪婪坐标梯度搜索后缀。值得注意的是,尽管这些攻击在开源模型上训练,但GCG生成的对抗性后缀表现出一定的可迁移性,能够攻击私有模型,尤其是当训练数据存在重合时。这提示我们,白盒攻击的研究成果可能对黑盒模
防御手段的权衡与局限
文章指出,对抗性训练被认为是目前最有效的防御方法,但需要在模型稳健性和性能之间做出权衡。例如,Jain等人2023年的研究发现,同时进行拒绝回应梯度下降和不当回应梯度上升的训练方案几乎无效,因为它严重降低了模型生成质量,而攻击成功率的减少却微不足道。此外,困惑度过滤可以识别无意义的对抗性提示,但攻击者可以通过优化降低困惑度来规避,如UAT-LM变体,不过这可能会降低攻击成功率。释义和重新分词等预处理方法也能降低攻击成功率,但效果有限,例如重新分词仅能将成功率从90%以上降至40%。这些发现表明,防御措施需要综合考虑
Q&A
大语言模型的对抗性攻击中,白盒攻击和黑盒攻击有什么区别?
白盒攻击指攻击者能完全访问模型的权重、结构和训练过程,因此可以获得梯度信息,但通常不假定能接触全部训练数据,这仅在模型开源时可能。黑盒攻击则指攻击者只能通过API提交输入并获取输出,无法了解模型内部细节。
有哪些常见的对抗性攻击方法可以用于大语言模型?
文章介绍了五种主要策略:Token操纵(黑盒,微调输入文本的少量Token)、梯度攻击(白盒,利用梯度信息)、越狱式提示(黑盒,基于直觉的提示绕过安全机制)、人力红队攻击(黑盒,人工攻击)和模型红队攻击(黑盒,一个模型攻击另一个模型)。
GBDA这种梯度攻击方法是如何工作的?
GBDA采用Gumbel-Softmax近似法将对抗性损失优化变为可微分操作,使用BERTScore和困惑度确保生成的文本难以察觉且流畅。它通过优化Token的概率分布来最小化对抗性损失,并可以加入流畅性和语义相似度的软约束。
什么是通用对抗触发器(UAT)?它为什么有效?
UAT是输入独立的短Token序列,作为前缀或后缀添加到任何输入上都能引发模型产生特定预测。它有效可能是因为利用了训练数据中的偏差,这些偏差形成了模型的全局行为,并且UAT能在不同模型间迁移。
如何防御大语言模型的对抗性攻击?
防御方法包括:对抗性训练(最有效但需权衡模型性能)、困惑度过滤(识别无意义攻击提示)、释义(用LLM改写文本)和重新分词(如BPE-dropout)。此外,直接指令模型负责任地生成内容也能降低越狱风险。
越狱提示攻击是如何绕过模型安全机制的?
越狱提示利用目标冲突(如执行能力与安全目标的矛盾)和泛化失配(安全训练未覆盖的领域)。具体技巧包括前缀引导、拒绝压制、风格限制、角色扮演、特殊编码(如Base64)、字符变换和单词变换等。
