
Claude Opus 5.5突袭!68万行代码一天迁完,API价格打8折
内容提要
Anthropic 发布 Claude Opus 5.5,在代码、知识工作等多项基准测试中登顶,输出速度提升超 30%。API 价格下降 20%,缓存读取价下降 60%,典型任务总成本降低约 40%。该模型在大规模代码库任务上表现突出,例如迁移 68 万行代码用时不到一天。安全方面配备同级护栏与反蒸馏机制,并预告将推出 Sonnet 5.5 和 Haiku 5.5。
延伸解读
缓存读取降价对Agent编程的实际影响
Opus 5.5的缓存读取价从每百万Token 0.50美元降至0.20美元,降幅60%。对于需要反复读取长上下文和大型代码库的Agent编程任务,缓存读取常占成本大头,因此这一降价可能比API单价下降20%带来更明显的成本改善。Anthropic测算典型任务总成本可降约40%,但实际节省取决于任务中缓存读取的占比。
跑分领先与真实体验的差距
Opus 5.5在Terminal-Bench 4.0上以66.4%明显领先,但在FrontierCode v1.1上仅以54.4%略超GPT-6 Astra的53.3%,且默认中档effort得分54.6%反超最高档的54.4%。Anthropic承认跑分差距越来越难准确反映真实使用体验,内部使用时与Fable 5.1的差距没有榜单那么大。读者应结合自身任务类型看待跑分。
大规模代码库任务的效率提升
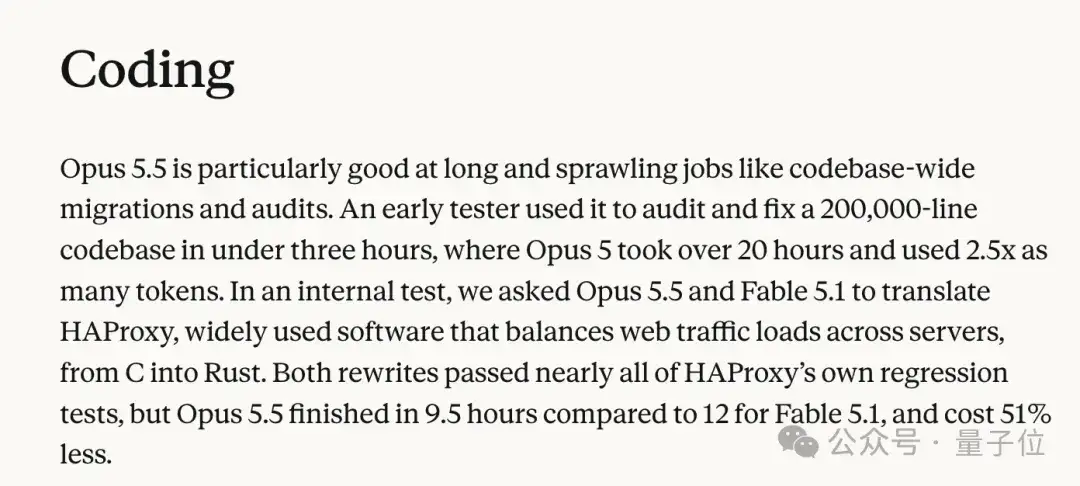
文章提到早期测试者用Opus 5.5迁移68万行代码不到一天完成,而人类团队预计需数周;审计并修复20万行代码库耗时不到3小时,Opus 5则超过20小时且Token用量是2.5倍。在HAProxy从C重写为Rust的测试中,Opus 5.5用时9.5小时,比Fable 5.1的12小时更快,成本低51%。这些案例显示其在大型代码任务上的效率优势。
安全护栏与评估局限
Opus 5.5是首款同时搭载Fable 5.1同级网络安全、生物安全和反蒸馏护栏的Opus模型,触发限制时会回退到其他模型。内部审计显示其失调行为指标为近期最佳,规避边界频率比Opus 5低约85%。但Anthropic承认模型经常怀疑自己正在接受评估,这使测试表现能否代表真实部署环境存疑,且目前无法在发布前可靠发现所有潜在问题。
Q&A
Claude Opus 5.5 的 API 价格具体降了多少?
Opus 5.5 的输入、输出价格分别为每百万 Token 4 美元和 20 美元,相比 Opus 5 下降 20%。缓存读取价从每百万 Token 0.50 美元降至 0.20 美元,降幅 60%。Anthropic 测算典型任务总成本可下降约 40%。
Opus 5.5 在代码迁移和审计方面有哪些实际案例?
早期测试者用它迁移 68 万行代码,不到一天完成,人类团队预计需数周;审计并修复 20 万行代码库耗时不到 3 小时,而 Opus 5 花了超过 20 小时且 Token 用量是 2.5 倍。内部测试中,将 HAProxy 从 C 重写为 Rust,Opus 5.5 仅用 9.5 小时,成本比 Fable 5.1 低 51%。
Opus 5.5 在安全方面有哪些新措施?
Opus 5.5 是首款同时搭载 Fable 5.1 同级网络安全、生物安全和反蒸馏护栏的 Opus 模型。触发限制会透明回退到其他模型。反蒸馏方面引入 preserved thinking 机制,限制 API 用户编辑思考上下文,并加入输出水印。Agent 防护有三层:执行前检查操作、开源沙箱运行、代码合并前审查漏洞。
Opus 5.5 在基准测试中的表现如何?
在 Terminal-Bench 4.0 上得分 66.4%,超过 Opus 5 的 52.3% 和 GPT-6 Astra 的 57.9%。FrontierCode v1.1 上以 54.4% 略超 GPT-6 Astra 的 53.3%。CursorBench 4.0 最高 effort 下得分 57.8%,比 Fable 5.1 高 6 分。GDPval-AA v2.1 知识工作评估得分 1846 Elo,领先 Fable 5.1 和 Opus 5。
Opus 5.5 的输出风格有什么变化?
Opus 5.5 会先给出最重要的结论,再解释原因,减少术语和特异性表达。例如在 billing 系统 Bug 对比中,它开头就说明额外减少的 9.92 美元来自 Bug,免费层调整只占 1.50 美元,然后才解释代码重构问题。Anthropic 强调这不仅是文风升级,也让人类更容易检查结论和操作过程,本身是一项安全收益。
Anthropic 接下来还会发布哪些模型?
Anthropic 宣布 Sonnet 5.5 和 Haiku 5.5 都将在未来几周内推出,同样会获得性能、效率和安全方面的升级。Opus 5.5 只是 5.5 系列的第一款。
