
EgoInteract:一种面向第一人称视觉理解、具备自纠正能力的交互式多模态智能体
内容提要
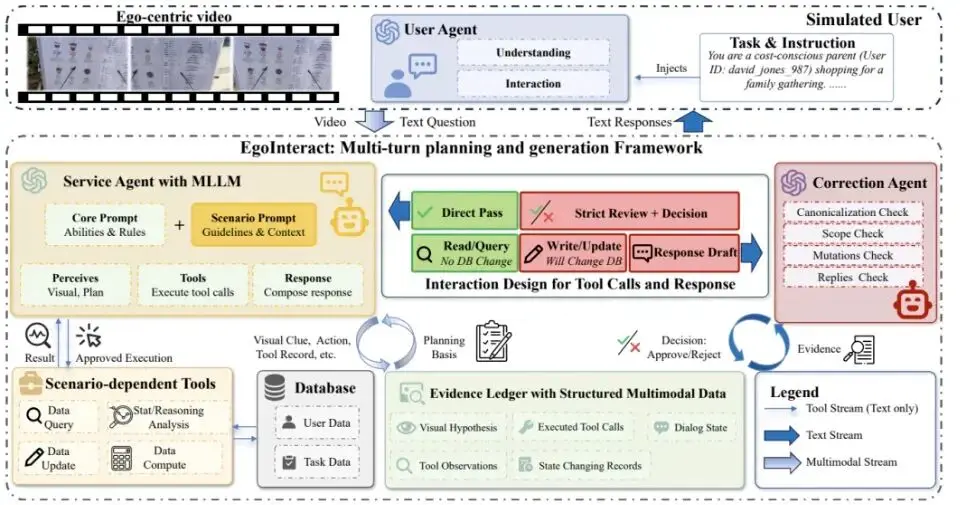
上海交大团队提出EgoInteract系统,用于EgoLink挑战赛Track 2的第一人称社会场景交互任务。该系统包含场景感知服务Agent与范围受限自纠正Agent,通过证据账本统一视觉假设、工具观测与对话状态,防止无依据的状态变更。官方评测中排名第一,联合成功率0.844,微平均准确率0.916。消融实验显示场景规则贡献最大,纠正机制提供针对性防护。
延伸解读
场景规则为何是性能基石
消融实验显示,移除场景规则后联合成功率从0.844骤降至0.646,降幅远大于移除纠正机制。这说明在零售、餐厅、厨房和点餐等差异显著的任务中,场景特定的定位与工具使用规则直接决定了有效分支的选择。例如厨房场景需将可见食材匹配到官方名称再联动食谱与库存,点餐场景则严格区分单品与套餐操作。缺乏这些规则,Agent容易误解工具语义或选错操作路径。
自纠正机制的价值与边界
自纠正Agent作为范围受限的审计器,仅检查高风险提案是否得到对话、视觉假设、工具观测等证据支持,不执行视觉识别或替代规划。移除它后联合成功率下降0.063,表明其能拦截无依据的状态变更和参数错误。但双重消融仅比单独移除场景规则略差,说明当规划器已能提出合理工具链时,纠正机制的增益有限。其核心作用在于为写操作和最终回复提供针对性防护。
过程与结果为何必须联合评估
EgoLink采用Tool Success和Result Success联合验证,Joint Success要求两者同时成立。EgoInteract的Result分数(0.875)高于Tool分数(0.854),表明部分轨迹虽最终数据库状态正确,但工具步骤存在缺失或错配。定性案例中,去掉纠正的版本虽得出正确数值,却绕过指定计算工具自行计算,导致Tool和Joint被扣分。这提醒读者,在工具使用任务中,结果正确不代表过程正确,两者兼顾才是可靠性的体现。
分场景性能差异的启示
分场景结果显示,retail6和kitchen4表现最强,其中retail6取得满分;order2和retail10则更具挑战。order2因混合单品与套餐操作、订单状态依赖和支付计算而复杂;retail10则受商品形状、标签关联和空间定位影响,准确锁定商品本身较难。这些差异说明,第一人称服务交互的难度高度依赖场景的视觉结构与工具语义,通用策略需结合场景技能才能应对。
Q&A
EgoInteract 是什么?它主要解决什么问题?
EgoInteract 是上海交大团队提出的推理时多模态智能体系统,用于 EgoLink 挑战赛 Track 2 的第一人称社会场景交互任务。它旨在解决现有被动视觉语言模型无法可靠规范化目标或执行状态变更,以及通用工具使用 Agent 假设实体和约束以文本形式给出的问题,通过统一证据链完成真实世界任务。
EgoInteract 的系统架构包含哪些核心组件?
EgoInteract 包含两个核心 Agent:场景感知服务 Agent 和范围受限的自纠正 Agent。服务 Agent 形成视觉和语言假设,通过官方工具规范化,并提出下一步动作;自纠正 Agent 审计状态变更调用和最终回复的证据充分性。两者通过提案—审计—重规划循环协作,并维护一个证据账本。
EgoInteract 在 EgoLink Track 2 官方评测中的表现如何?
在 EgoLink Track 2 官方最终评测中,EgoInteract 在已公布队伍中排名第一,取得 0.844 的联合成功率、0.916 的微平均准确率、0.875 的结果成功率和 0.854 的工具成功率。
消融实验揭示了哪些关键发现?
消融实验表明,移除纠正 Agent 后联合成功率从 0.844 降至 0.781;移除场景规则导致更大幅度下降至 0.646;双重消融仅比单独移除场景规则略差。这说明场景感知提示是主要增益来源,纠正机制为无依据操作提供针对性防护。
自纠正 Agent 是如何工作的?它审计哪些内容?
自纠正 Agent 是范围受限的证据审计器,不执行视觉识别,仅检查服务 Agent 提出的高风险提案(状态变更工具调用或最终回复)是否得到对话、视觉假设、工具账本、当前状态、活跃分支、规范目标、数量和所需计算的支持。输出为批准、拒绝、要求更多证据或修改最终回复。只读查询走快速通道,写操作和最终回复必须审计,纠正最多五轮。
EgoInteract 如何处理不同场景的差异?
EgoInteract 采用通用策略加场景技能的两层结构。通用策略是有序检查清单,场景技能填充领域知识:零售场景规定包装文字来自帧、商品事实来自工具;餐厅场景将指代分类并保持菜单区域稳定;厨房场景匹配食材到官方名称并联动工具;点餐场景强调餐厅名来自对话、区分单品与套餐、支付使用指定计算工具。
