


从慢速到SIMD: 一个Go优化的故事
内容提要
本文介绍了使用SIMD进行Go性能优化的方法,包括展开循环、消除边界检查、量化向量和使用SIMD指令。通过这些方法,点积函数的性能提高了530%。文章还提到了使用AVX-512指令集和GPU实现点积的可能性。
延伸解读
优化步骤的递进关系
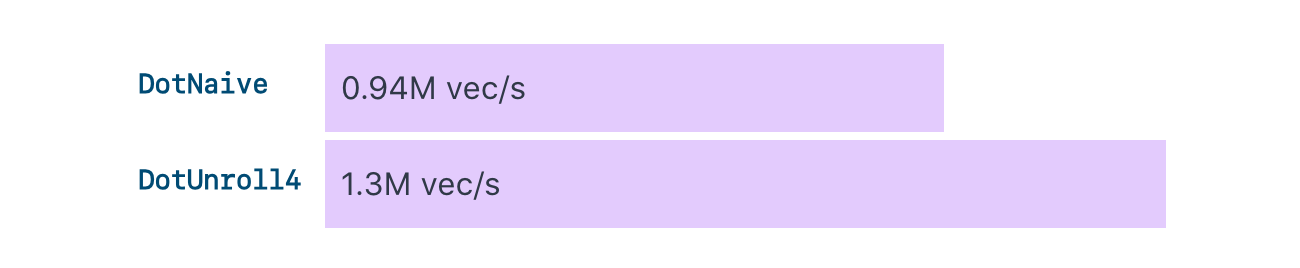
文章展示的优化并非独立,而是层层递进:循环展开先提升37%,边界检查消除再提升9%,量化虽减少内存但导致性能下降,最终SIMD带来530%的飞跃。读者应注意,每一步都建立在前一步基础上,且量化后的性能下降被后续SIMD优化掩盖,实际应用中需权衡内存与速度。
SIMD在Go中的实现选择
Go不直接暴露SIMD内建函数,作者选择手写汇编而非Cgo,以避免Cgo的性能开销和构建复杂性。手写汇编虽能获得最佳性能,但需熟悉Go汇编器的独特语法和限制,如操作数顺序、指令名称差异等。对于需要跨平台的项目,可结合运行时检测和纯Go回退方案。
量化与精度的权衡
将float32向量量化为int8可减少4倍内存,但会引入精度损失。文章提到他们进行了仔细测量,但未深入细节。在实际应用中,需评估精度下降对相似性搜索排名的影响,尤其是在需要高准确性的场景。量化可能适合内存受限的环境,但需监控结果质量。
AVX-512 VNNI的额外收益与限制
AVX-512 VNNI扩展通过VPDPBUSD指令直接计算int8点积,避免了转换为int16的步骤,从而在AVX2基础上再提升21%。但该指令要求一个向量为有符号字节,另一个为无符号字节,作者通过添加128偏移并补偿的技巧解决。使用AVX-512需考虑CPU支持度,可能需回退到AVX2。
Q&A
在Go中如何通过循环展开优化点积函数?
循环展开通过一次迭代处理多个元素(如4个)来减少数据依赖,使CPU能更好地利用指令流水线。例如,将循环展开4次,每次计算4个乘积并累加,从而将循环开销分摊到多个操作上。在基准测试中,这使吞吐量提高了37%。
什么是边界检查消除,它如何提升Go代码性能?
边界检查消除是一种减少Go运行时切片越界检查的技术。通过确保切片长度相等且为4的倍数,并将所有边界检查移到循环外,可以避免每次迭代的检查,从而提升性能。在点积函数中,这带来了9%的性能提升。
量化如何减少内存使用,对性能有什么影响?
量化通过将float32向量元素转换为int8,将内存使用减少4倍。但转换会引入int8到int32的转换指令,导致性能下降。虽然准确性略有牺牲,但内存节省对大规模向量搜索很重要。
如何使用SIMD(AVX2)优化Go中的点积函数?
使用Go汇编手写AVX2指令,如VPMOVSXBW、VPMADDWD和VPADDD,一次处理16个int8元素。核心循环利用VPMADDWD合并乘加操作,避免溢出并扩展为int32。这使性能比之前最佳版本提升了530%。
AVX-512 VNNI扩展如何进一步提升点积性能?
AVX-512 VNNI的VPDPBUSD指令直接计算int8向量的点积,无需转换为int16,且向量宽度加倍,一次处理64个元素。通过技巧处理有符号和无符号字节的混合,再减去额外项,最终性能又提升了21%。
为什么Sourcegraph选择手动优化点积而不是使用向量数据库?
使用索引向量数据库会增加基础设施管理、构建延迟和资源需求,且近似检索引入模糊性。而穷举搜索更易解释,通过手动优化点积函数,他们实现了9.3倍的吞吐量提升和4倍内存减少,满足了性能需求。
